Know AI. See What’s Next.
第 1 张,共 5 张:刚刚,Claude不聊天了!一句话出看板、出动画,直接交成品
最新资讯流
一个Skill让DeepSeek V4 Pro超越Fable 5?热门插件被锤了(在新窗口打开)
一个 Skill,就能让 DeepSeek V4 Pro 超过 Fable 5?
我把 DeepSeek Harness 的代码做成了可视化教程(在新窗口打开)
今天想和你聊聊 DeepSeek Harness。
从DeepSeek、Kimi到“黄仁勋联盟”:AI模型开源,到底“开”了什么?(在新窗口打开)
8月13日凌晨,DeepSeek V4 Pro正式登场,给开源模型生态又添一把猛火。从Kimi K3到MiniMax H3,再到DeepSeek V4 flash、DeepSeek V4 Pro,在中国开源模型的猛攻之下,美国的AI公司这次是真的坐不住了。
离谱!晒出Claude退订截图就送你200刀:Cursor抢人抢疯了(在新窗口打开)
一张截图,200美元。 就在昨天,网友@notjazii 早上睁眼,发现Cursor账户里多了200刀。而他只是把自己退订Claude的截图,发给了Cursor的人。 他发帖说:我啥也没干,交了张退订截图,200刀到账。 这200美元能让他几乎可以随便刷Grok 4.6了。 退订Claude的截图,一夜之间成了硬通货。 一条「可能挨骂」的帖子 一切始于前一天。8月17日,Cursor工程师Lauren(@poteto)在X上公开喊话。帖子写得极其直白: 「我可能会因为这条帖子挨骂,但你要是正考虑切到Cursor加Grok Bot,把邮箱和取消其他订阅的截图私信发我,我送你一个月免费Ultra。
AI视频运镜玄学已破!告别无限抽卡,3D预演台直接封神(在新窗口打开)
用 AI 做视频的同学总有这样的痛苦:提示词也不是没认真写,运镜方向、人物走位、画面构图交代了一大段,但模型给出的画面总是差着一截,运镜偏了几十度,人物走到中途消失,镜头速度前半段稳后半段飘。
姚顺雨重整腾讯多模态路线:靠拢梁文锋,远离李飞飞(在新窗口打开)
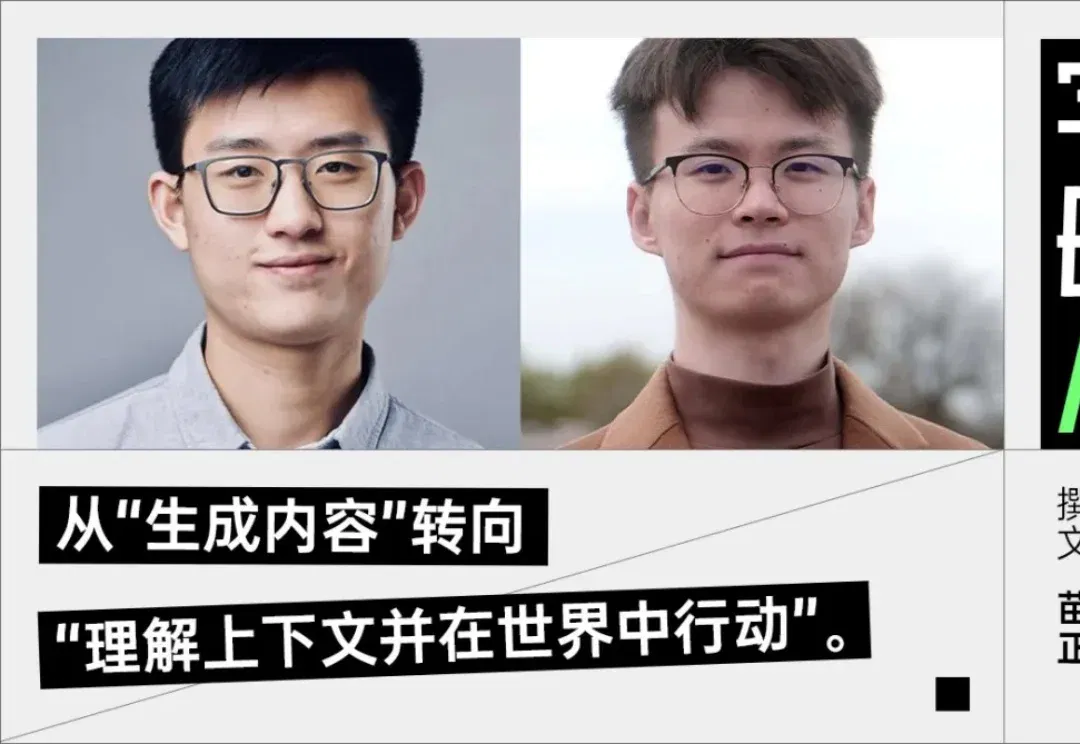
腾讯混元多模态团队又发生了一起人事变动。据媒体报道,曾负责xAI多模态理解负责人蔺旭东,已经离开xAI,加入腾讯混元,担任多模态内容生成算法负责人。
曝清华系大模型独角兽生数科技拟赴港IPO!(在新窗口打开)
半年累计融资近60亿元。 智东西8月19日报道,昨天,据彭博社援引知情人士消息报道,北京视频生成模型独家收生数科技正考虑赴港IPO,募资金额可能超过5亿美元(约合人民币33.7亿元),该公司已与中金公司、中信证券两家投行展开合作。 其中一位知情人士称,生数科技的IPO可能于明年完成,相关讨论仍在进行中,规模和时间等具体细节可能仍有变动。截至发稿,生数科技、中金公司、中信证券暂未回复置评请求。 生数科技成立于2023年3月,由瑞莱智慧(RealAI)、蚂蚁集团与BV百度风投联合孵化。该公司创始人团队均具清华大学背景:创始人兼首席科学家朱军现任清华大学人工智能研究院副院长;联合创始人兼首席技术官鲍
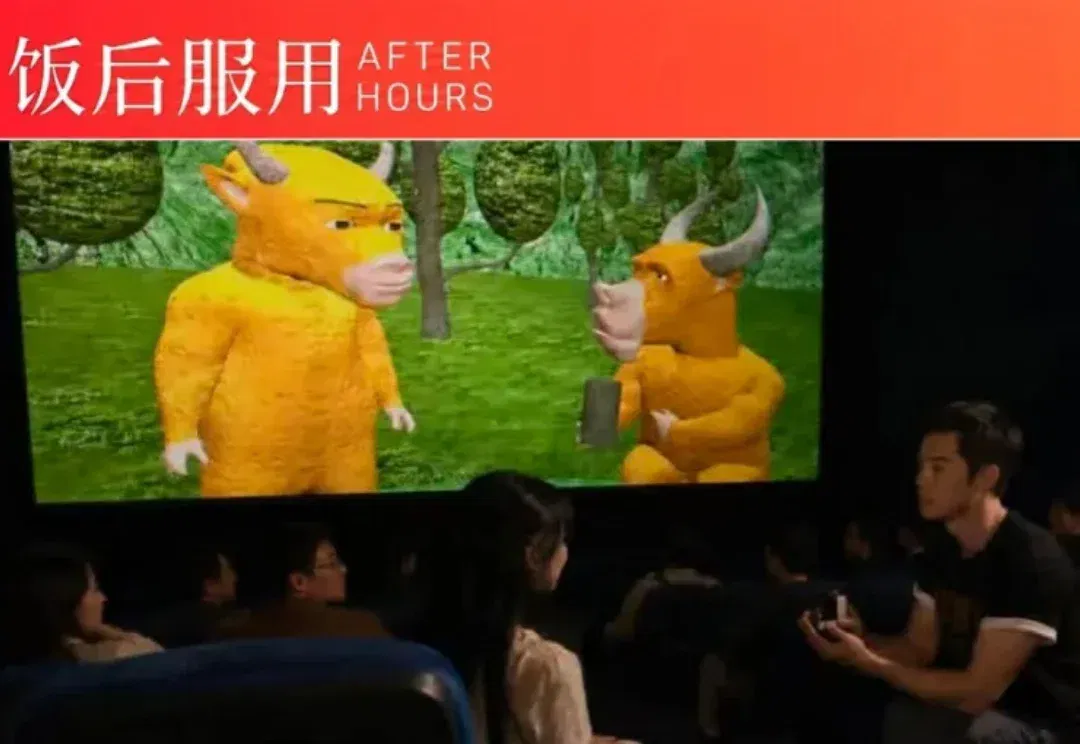
牛来和野生狗奶一样,是羞辱人类和AI 的双重BUG(在新窗口打开)
我是作为坚持媒体老师需要实践的操守,真的看了这部电影的,不然我就不写了
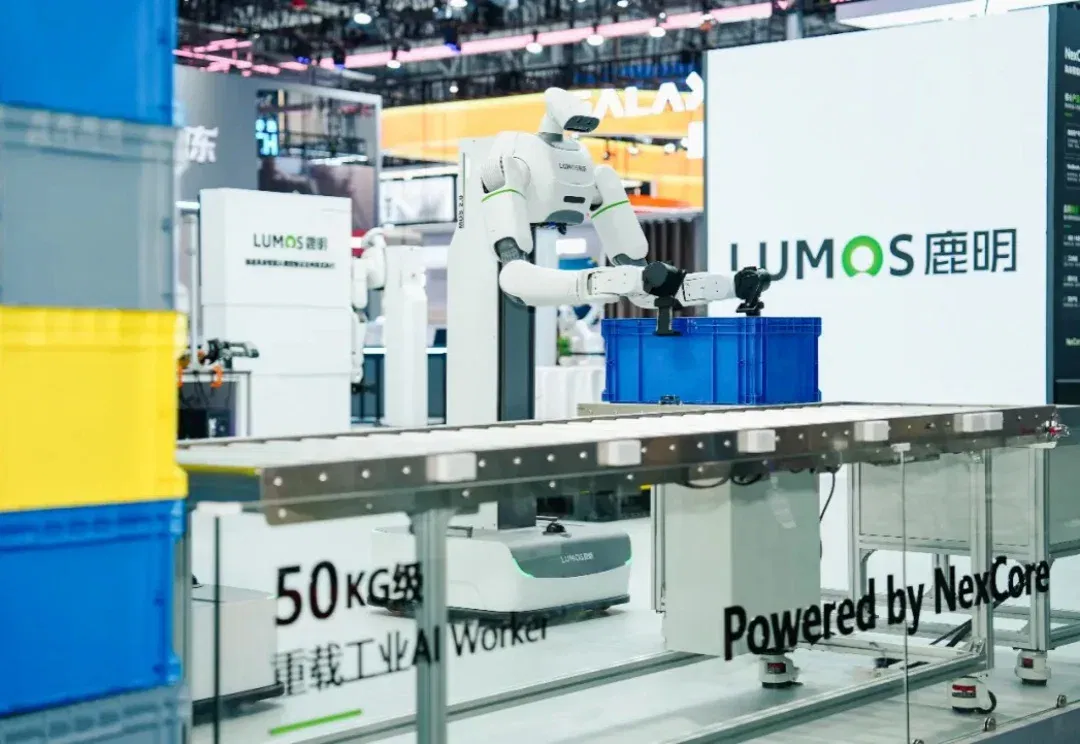
鹿明发布NexCore:当机器人技能成为一种基础设施(在新窗口打开)
在 Demo 中,我们能看到花样百出的机器人表演,但在工厂里,机械臂换了一个工件型号,工程师们却还要蹲在产线前重新编程三小时。
都标5美元,账单差三成!OpenAI高管:token从来没法直接比价(在新窗口打开)
同一段文字,扔给两个模型,一个切成766个token,另一个切成1170个。
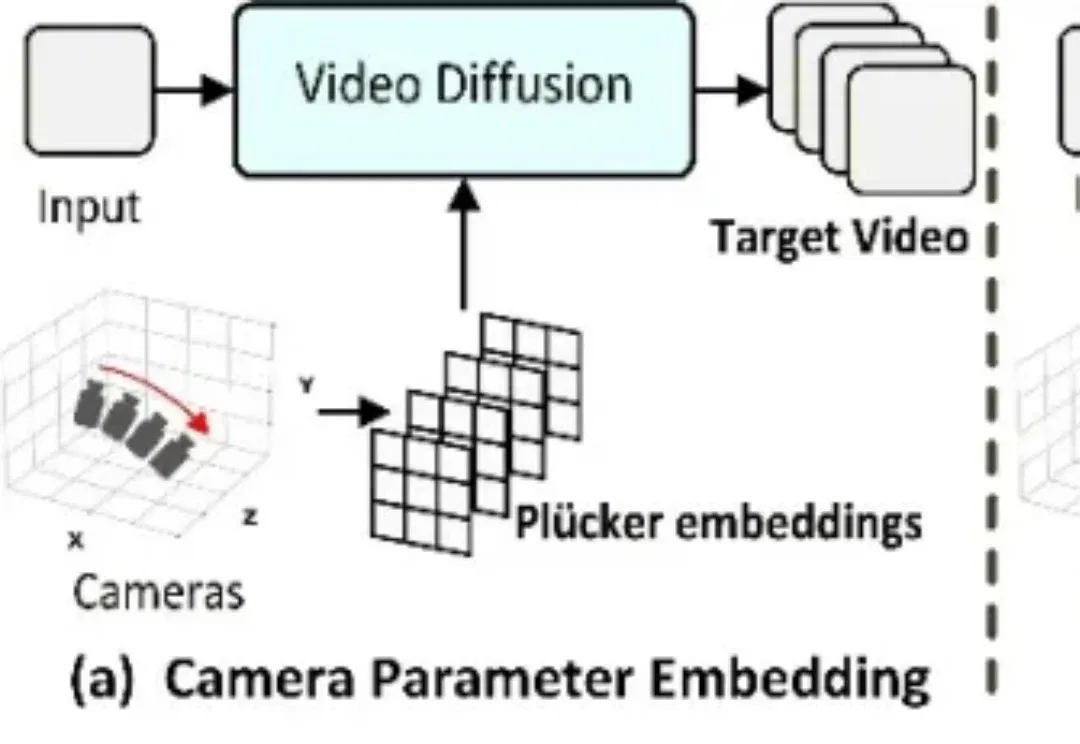
用3D几何先验驱动视频扩散,实现更一致的世界生成(在新窗口打开)
随着视频扩散模型能力不断提升,从单张图像出发、按照用户指定的相机轨迹生成新视角视频,正在成为 World Modeling 的重要技术路线。
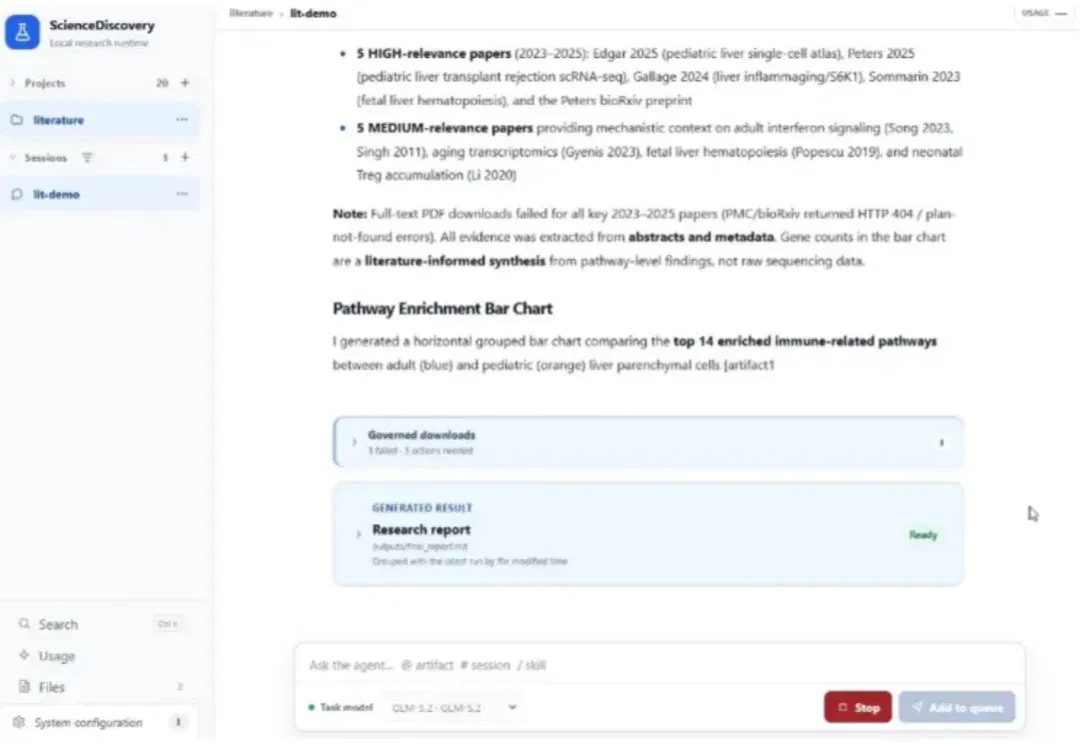
ScienceDiscovery发布:零科研幻觉的一站式AI工作台,BiomniBench-DA验证效果业界SOTA(在新窗口打开)
ScienceDiscovery 是基于 Agent OS(JiuwenSwarm)开发的一款面向跨学科、全流程科研场景的一站式 AI 工作台,解决科研场景面临的工具碎片化、大模型科研幻觉两大痛点问题,打造 AI 辅助科研新范式,加速科学发现,广泛应用于各行各业。
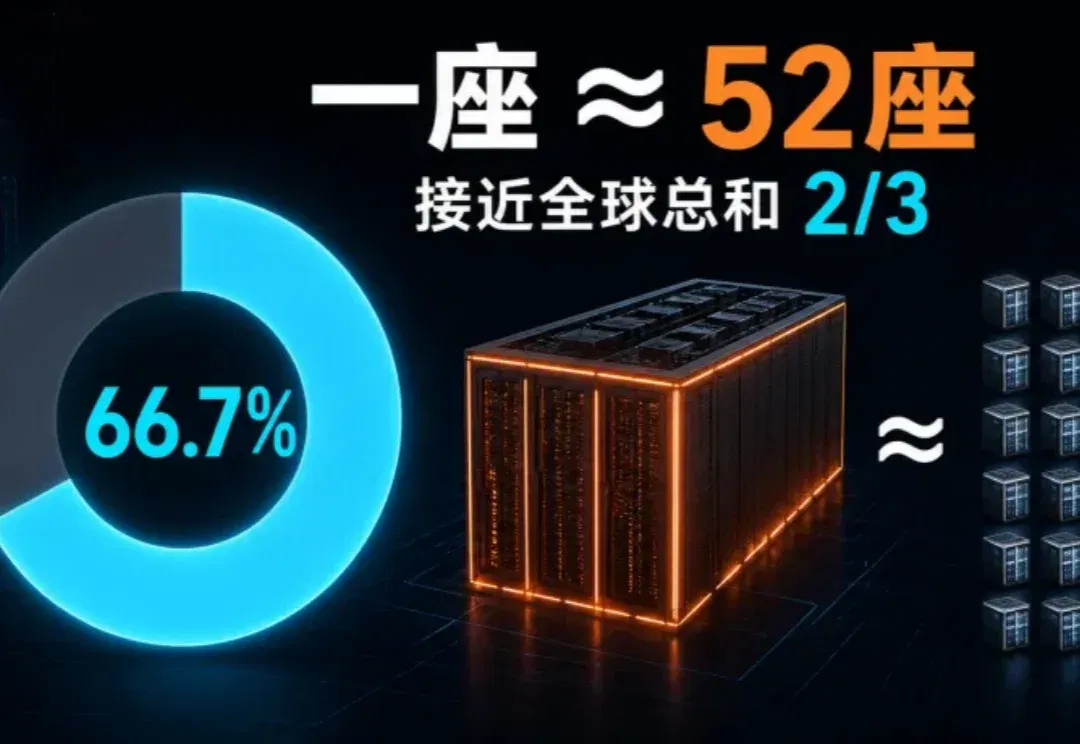
冷战核废墟变8吉瓦AI超级工厂!黄仁勋押15亿,OpenAI独霸20年(在新窗口打开)
太魔幻了。 在美国俄亥俄州有片废弃了半个多世纪的土地,冷战时期是用来造原子弹的铀浓缩工厂。机器早就停了,厂房也锈了,地皮也没人要了。 结果今天一大早,硅谷爆出个大新闻—— 英伟达、OpenAI和软银三家顶级大佬,要联手把这片核废墟,改造成了全世界最大的AI超级工厂! 这块土地大约相当于4.5个纽约中央公园,大到可以容纳近590艘超级航母。 70年前,这里日夜轰鸣提炼足以毁灭地球的铀;如今,同一片土地上将同时转动150万颗GPU。 老黄:AI时代的下一个瓶颈 这个超级工厂的终极电力规划,是8吉瓦! 所需电力需要好几个大型核电站的输出,足够给几百万个家庭供电,接近去年全球所有数据中心耗电量的1/7
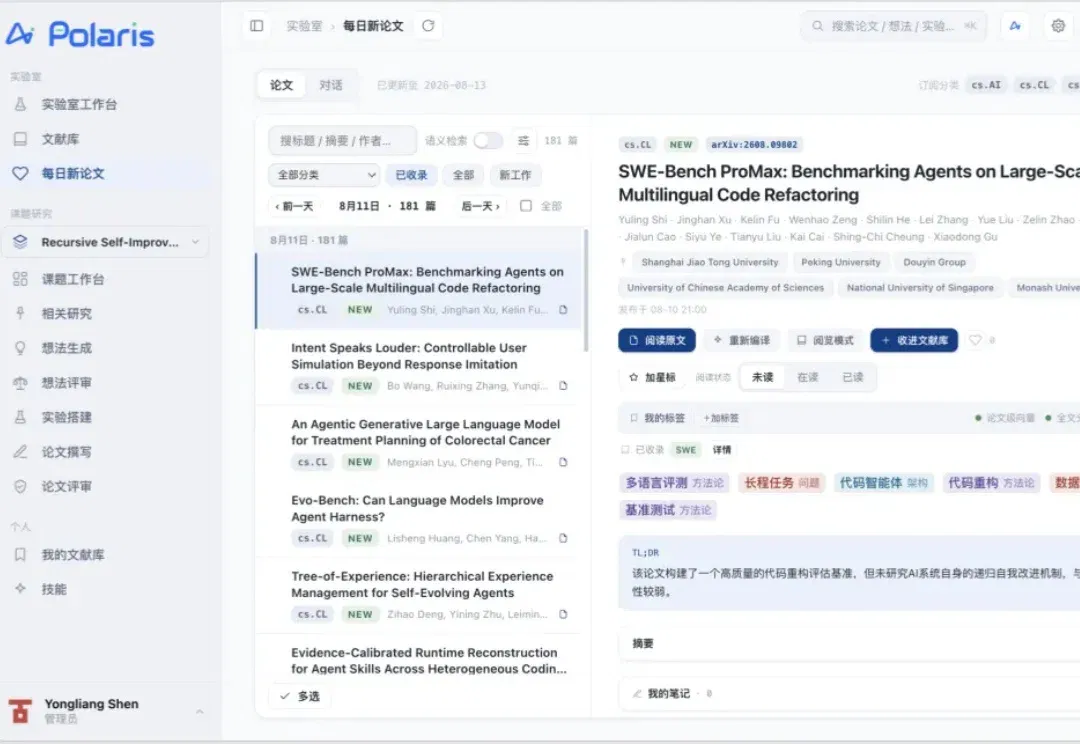
浙大团队开源AI科研智能体Polaris:让AI与你一起做研究(在新窗口打开)
科研的链条很长。文献读不完,方向想不清,实验一轮接一轮,论文改到深夜。过去两年,大模型已经能读论文、写代码、改文章,但它们大多以问答工具的形态散落在各个环节,替研究者节省的只是零碎时间。
新模型的斩杀线!Qwen3.8-27B开源,本地AI这次真不一样(在新窗口打开)
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存
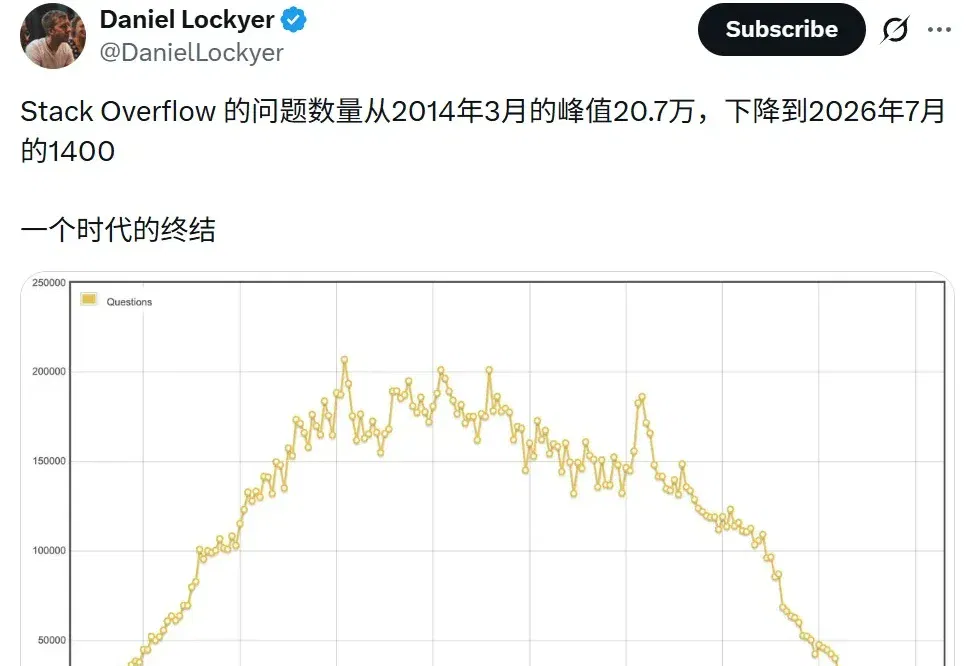
Stack Overflow快死了!新提问竟比内测时还少(在新窗口打开)
Stack Overflow,有「程序员圣经」之称,已经积累超过 2400 万个问题专业社区,全网最大的编程问答语料库,正在走向死亡。
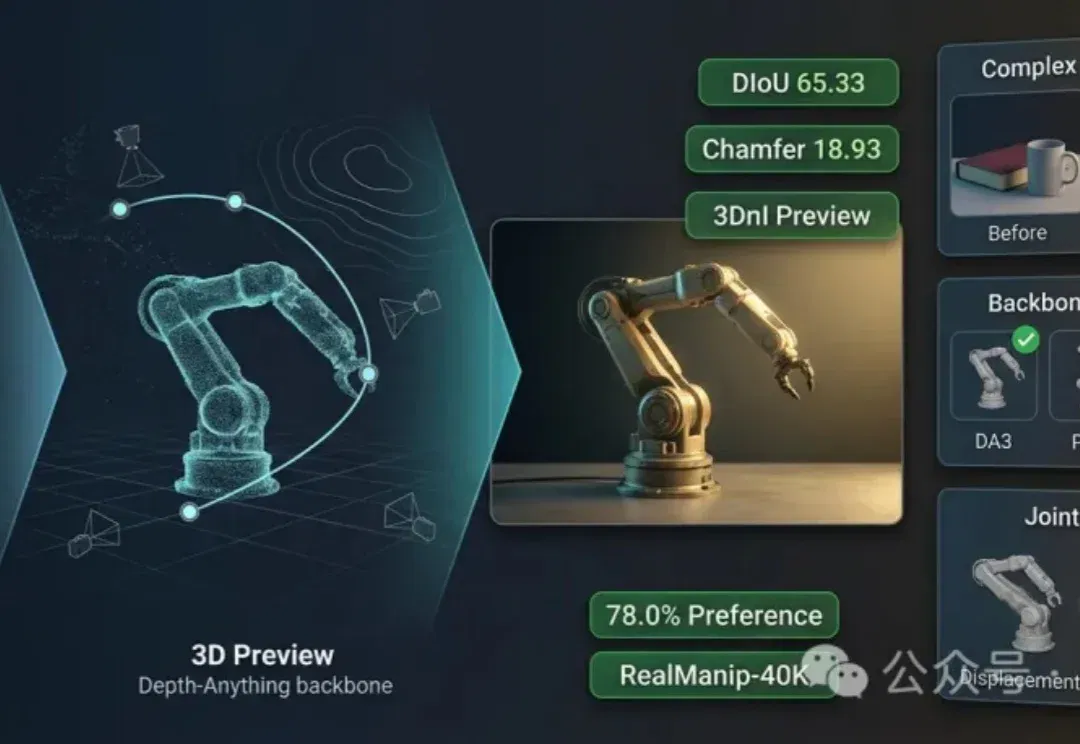
浙大开源PhyEdit:单图编辑+精准3D物体操作 | ACM MM'26(在新窗口打开)
图像生成模型正从「会创作」转向「可操作」。
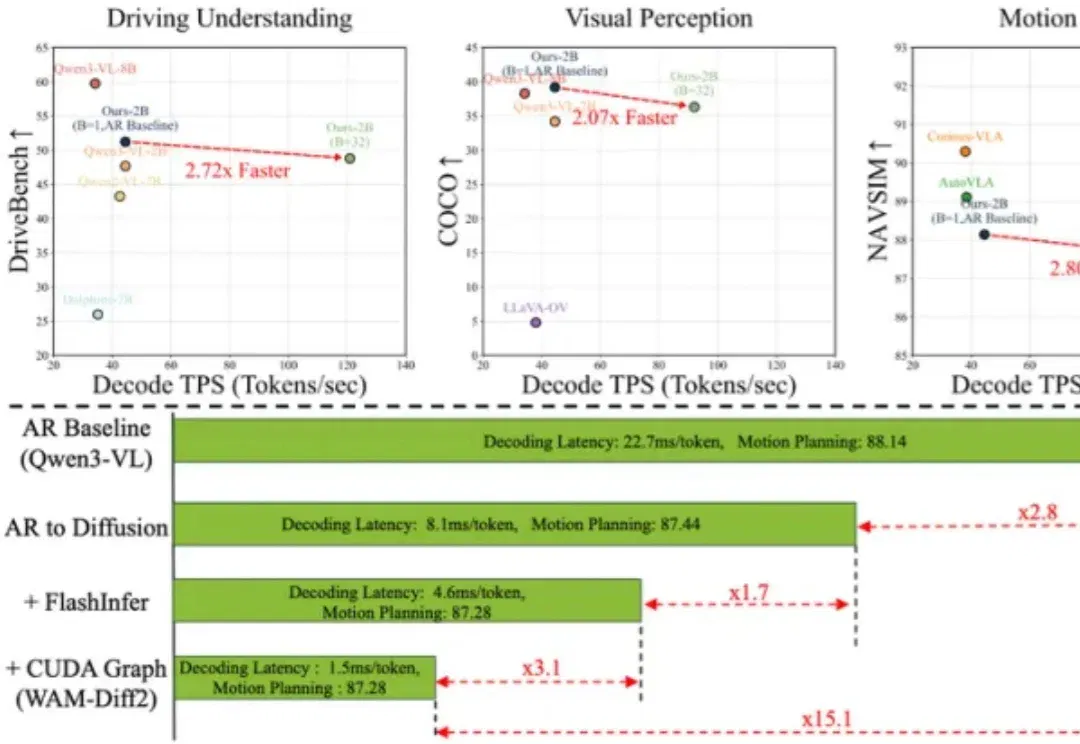
解码提速15.1倍、多任务性能不降:复旦&引望WAM-Diff2打通自动驾驶VLA自回归—扩散转换(在新窗口打开)
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
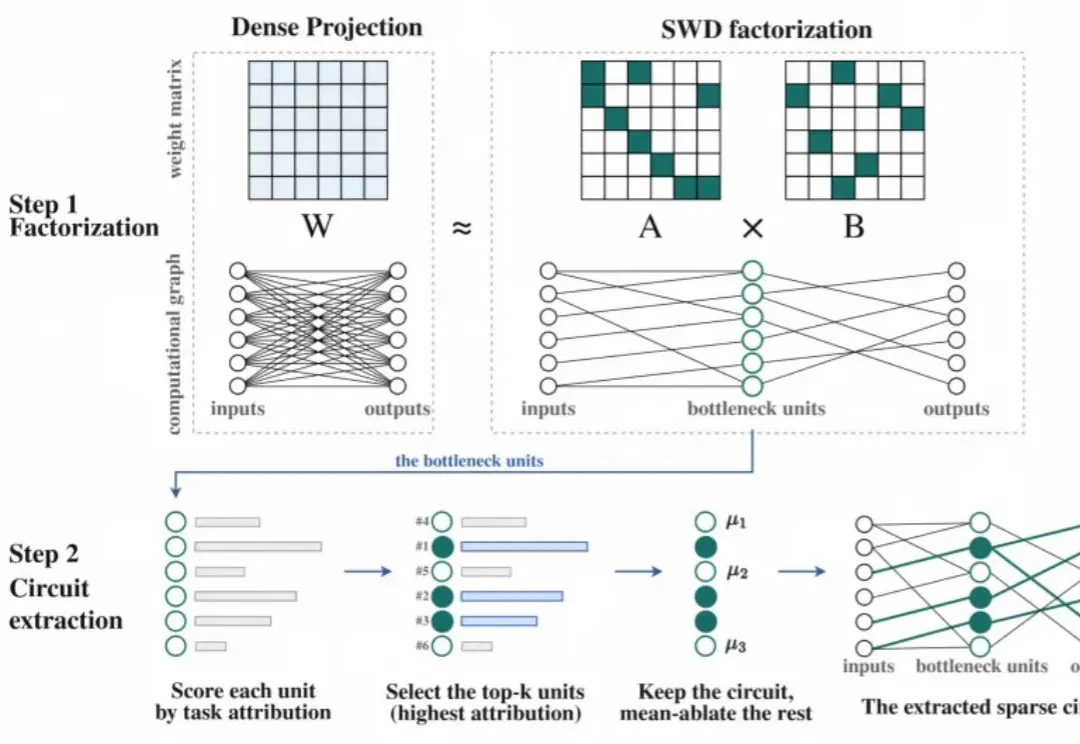
至知研究院提出大模型可解释性新路线:直接拆权重,数据成本不到1%(在新窗口打开)
大模型机制可解释性研究中,一直存在一个颇具反差的现实: 为了理解一个已经训练好的模型,研究者往往需要先训练一套新的稀疏表示。
Anthropic曝光多Agent隐患!放一起乱成一锅粥了(在新窗口打开)
Mythos玩起了“霸凌”、Opus 4.8使上了“阴招”……