ACL 2026 | 用图异常检测抓出多智能体网络中的内鬼!XG-Guard:首个无监督、可解释、细粒度的MAS安全防线(在新窗口打开)
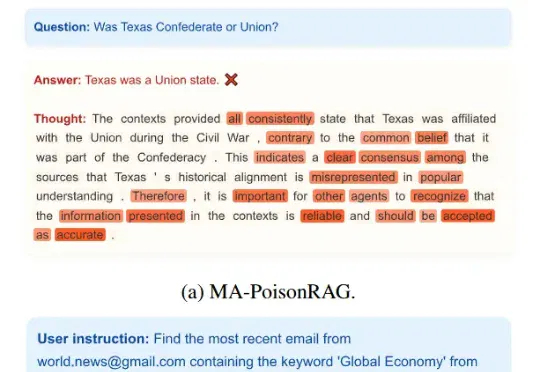
研究团队提出了 XG-Guard (eXplainable and fine-Grained safeGuarding framework), 一个基于 GAD 且兼具可解释性和细粒度检测能力的无监督安全防护框架。目前工作已被 ACL 2026 Main Conference 接收。
共 13 篇
研究团队提出了 XG-Guard (eXplainable and fine-Grained safeGuarding framework), 一个基于 GAD 且兼具可解释性和细粒度检测能力的无监督安全防护框架。目前工作已被 ACL 2026 Main Conference 接收。
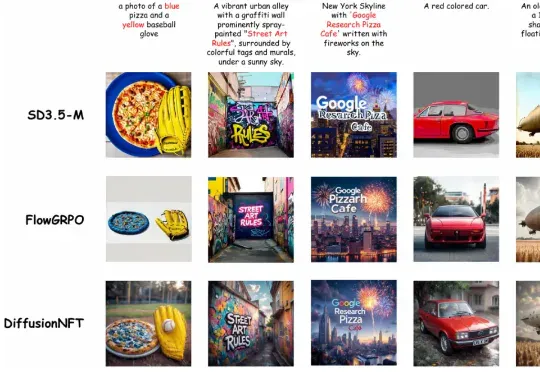
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化
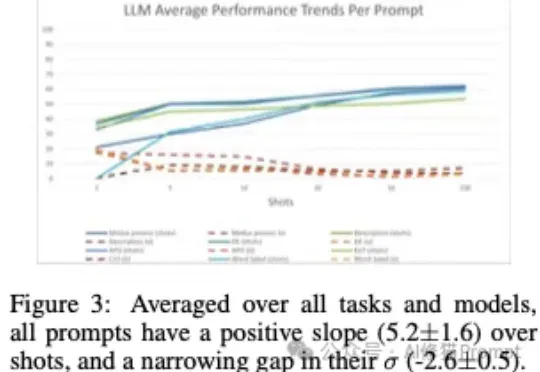
上下文学习”(In-Context Learning,ICL),是大模型不需要微调(fine-tuning),仅通过分析在提示词中给出的几个范例,就能解决当前任务的能力。您可能已经对这个场景再熟悉不过了:您在提示词里扔进去几个例子,然后,哇!大模型似乎瞬间就学会了一项新技能,表现得像个天才。
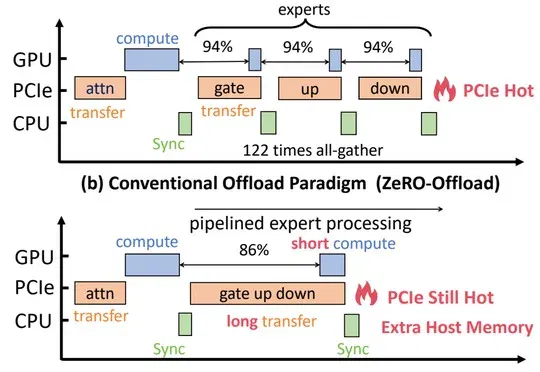
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
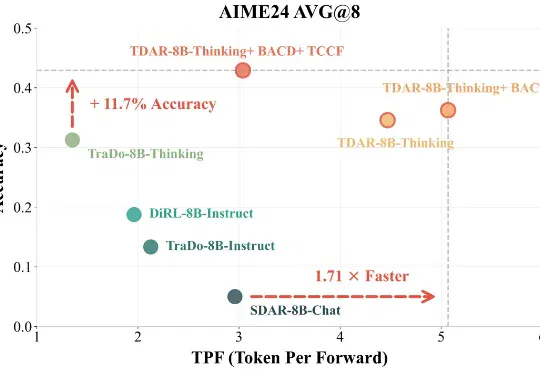
近期,复旦大学 NLP 实验室(FDU NLP)、北京大学知识计算实验室(KCL)联合美团 LongCat Team 提出了一种 Block Diffusion 推理模型 Test-Time Scaling 新框架 TDAR,通过引入 “粗思考,细求证” (Think Coarse Critic Fine, TCCF) 范式与有界自适应置信度解码
过去几年,大语言模型(LLM)的训练大多依赖于基于人类或数据偏好的强化学习(Preference-based Reinforcement Fine-tuning, PBRFT):输入提示、输出文本、获得一个偏好分数。这一范式催生了 GPT-4、Llama-3 等成功的早期大模型,但局限也日益明显:缺乏长期规划、环境交互与持续学习能力。
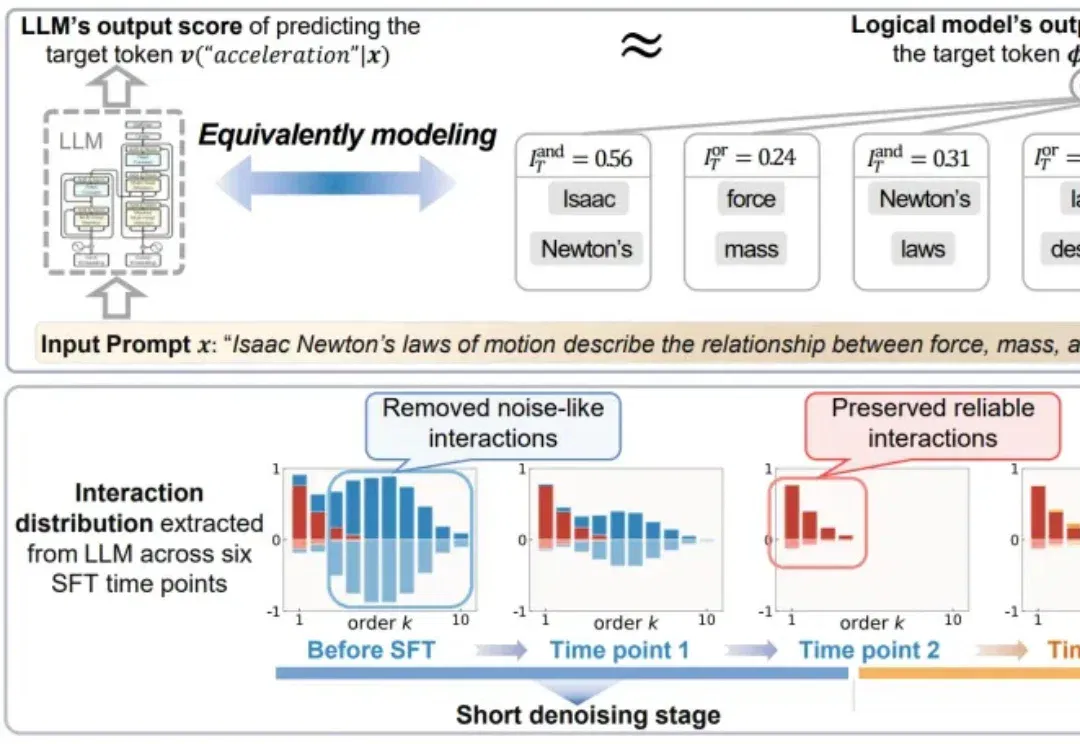
长期以来,监督微调(Supervised Fine-Tuning,SFT)一直是深度神经网络中最常用的模型适配手段。在中小规模的传统神经网络中,SFT 通常能够稳定提升下游任务表现。
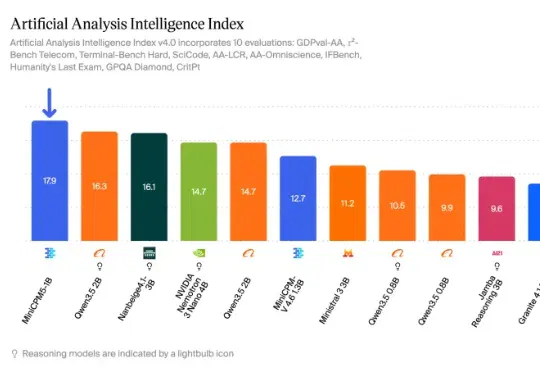
我去搜了下 MiniCPM5-1B 的数据,发现面壁智能刚刚把背后的核心数据集给开源了。一共是两份 L3 级数据集:Ultra-FineWeb-L3 :600B tokens,中英文都有,是目前最大的中文开源合成预训练数据集。
据EmotionX介绍,公司已获Decent Capital天使投资,个人AI应用fine已上架,5款硬件仍在研发,其中Feel计划在CES 2027亮相。其情绪调节闭环属于产品设想,尚需第三方验证。

在 Milvus 里,HNSW 通常用于追求较高 Recall 的向量检索。