超DeepEP两倍!无问芯穹FUSCO以「空中变阵」突破MoE通信瓶颈,专为Agent爆发设计(在新窗口打开)
机器之心发布 随着 ChatGPT、Gemini、DeepSeek-V3、Kimi-K2 等主流大模型纷纷采用混合专家架构(Mixture-of-Experts, MoE)及专家并行策略(Expert
共 12 篇
机器之心发布 随着 ChatGPT、Gemini、DeepSeek-V3、Kimi-K2 等主流大模型纷纷采用混合专家架构(Mixture-of-Experts, MoE)及专家并行策略(Expert
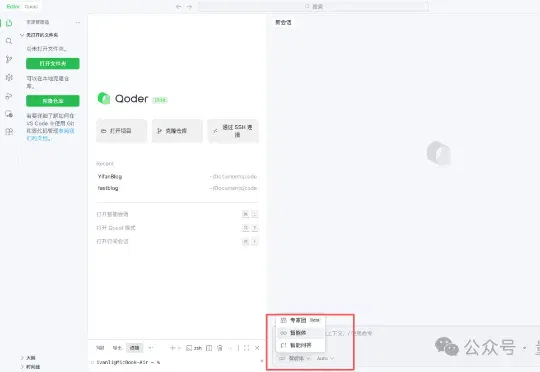
我最近实测阿里Qoder「专家团模式(Experts Mode)」后,发出了上述感慨。在「专家团模式」下,Qoder直接给我组织了一支赛博工程团队,我就负责看,专家团负责干。它帮我自动解析需求,分配任务,调配前端、后端、测试、运维等不同职责的“工程师”,驱动多个智能体同时推进任务,直接让我躺着当了回CTO。
周伯文还详细介绍了上海 AI 实验室近年来开展的前沿探索与实践,包括驱动 “通专融合” 发展的技术架构 ——“智者”SAGE(Synergistic Architecture for Generalizable Experts),其包含基础、融合与进化三个层次,并可双向循环实现全栈进化;支撑 AGI4S 探索的两大基础设施“书生”科学多模态大模型 Intern-S1、“
OpenAI开招新岗位:投行专家。核心任务就是教AI做投行的活儿,并且定义什么才算“做得好”。岗位全称Subject Matter Expert, Investment Banking,投资银行领域专家,隶属Applied AI团队,坐标旧金山。
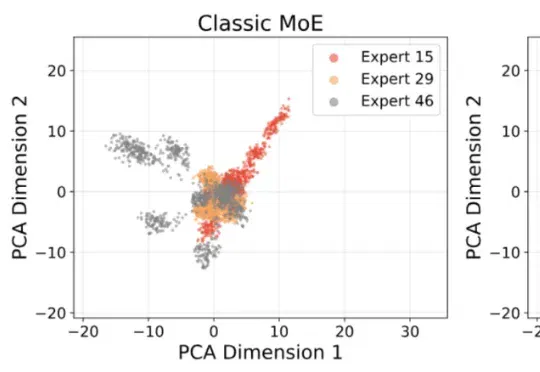
近年来,Mixture-of-Experts(MoE)已经成为大模型扩展的重要架构之一。相比稠密 Transformer,MoE 通过稀疏激活机制,在每个 token 上只调用少量专家,从而在控制计算成本的同时扩大模型容量。然而,一个长期存在的问题是:专家越多,并不意味着专家真的学得越 “专”。
《读佳》获知,腾讯推出面向外部行业人才的专家平台“混元智囊团”,平台Slogan为“聚智为谋,引领未来”。该平台隶属于腾讯混元旗下,通过连接各领域顶尖实战专家与真实AI训练问题,以高质量数据集生产、专业内容编写、知识审核为核心工作,产出的专家资源与专业数据服务于混元大模型持续迭代优化。
过去十年,大模型世界里很多最关键的技术路线背后,都能看到Andrew Dai的身影。从早期预训练与监督微调,到后来主流的MoE(Mixture of Experts)架构;从Google Brain最初只有几十人的研究时代,到后来支撑Gemini的大规模数据体系,这位在 Google 工作超过14年的研究科学家,几乎站在了大模型时代每一次关键转折的现场。
今天,MiniMax Agent 2.0 推出了 Desktop App,能操作本地文件、自动化网页操作。MiniMax Agent 2.0 这次更新了两个核心能力:一个是 Desktop App,一个是 Expert Agents。
最近,Prime Intellect正式发布了INTELLECT-3。这是一款拥有106B参数的混合专家(Mixture-of-Experts)模型,基于Prime Intellect的强化学习(RL)技术栈训练。在数学、代码、科学与推理的各类基准测试上,它达成了同规模中最强的成绩,甚至超越了不少更大的前沿模型。
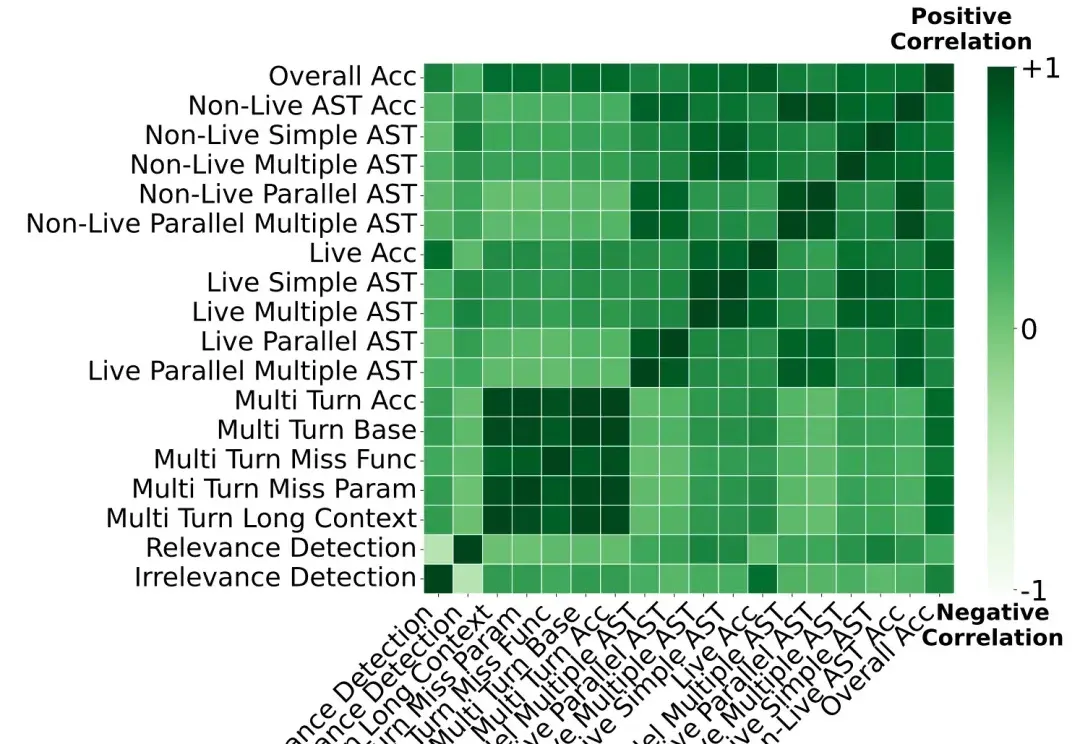
模型也要学会取长补短。 大语言模型(LLM)在众多领域展现出卓越的能力,但它们的训练依然高度依赖算力和时间,需要庞大的计算资源以及精细的训练流程设计。 模型 Souping(Model Souping) ,即对同一架构的多个模型进行权重平均,形成一个新的、更强的模型。相比训练一个庞大的统一模型,souping 更轻量、成本更低,同时能够融合模型的互补能力。 然而,传统的模型 souping 方式通常采用简单的均匀平均,即把所有候选模型的参数直接做等权融合。 本文中,来自 Meta、伦敦大学学院机构的研究者提出类专家 Soup(Soup Of Category Experts, SoCE),这是