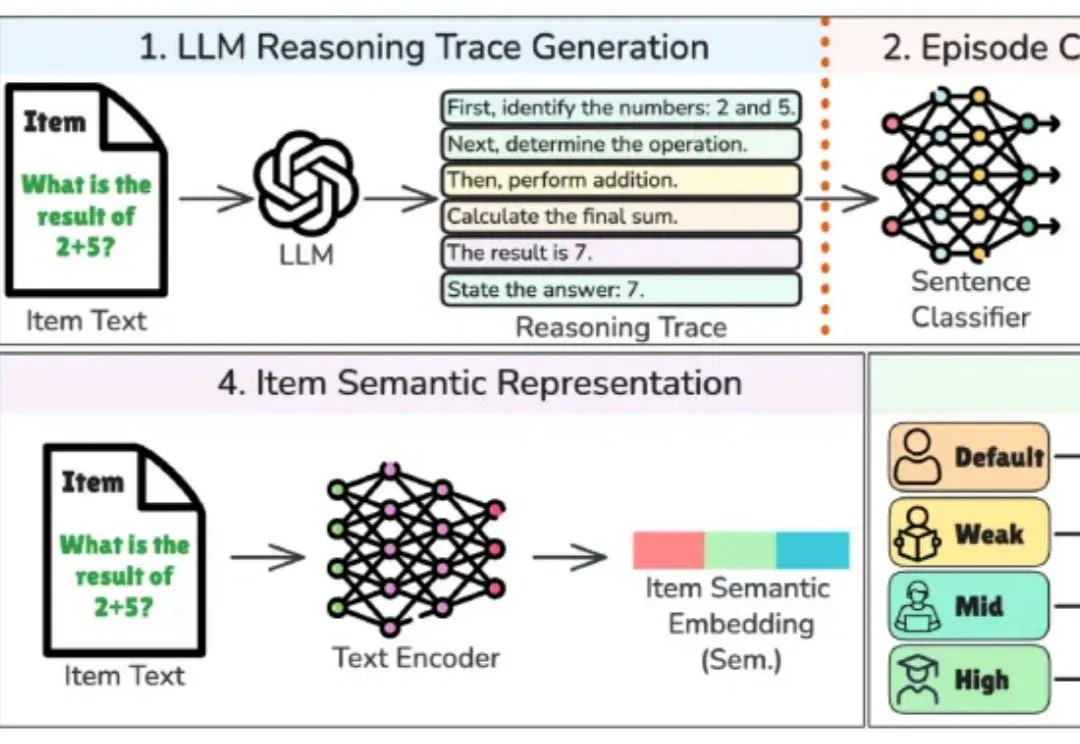
Epi2Diff 用大模型推理轨迹预测试题难度,获 TMLR 接收(在新窗口打开)
Epi2Diff 将大模型解题过程拆为八类认知片段,提取过程特征并结合题目语义预测人类作答难度。研究在四个测评数据集上报告结果,SAT数学主实验准确率为73.0%;方法仍依赖已有难度标签训练,也需要目标人群验证与专家复核。
共 3 篇
Epi2Diff 将大模型解题过程拆为八类认知片段,提取过程特征并结合题目语义预测人类作答难度。研究在四个测评数据集上报告结果,SAT数学主实验准确率为73.0%;方法仍依赖已有难度标签训练,也需要目标人群验证与专家复核。
机器学习期刊TMLR联合主编Nihar B. Shah在轮值期间抽查10篇待拒稿论文,约作者面谈基础问题,结果3篇论文的作者连问题设定、符号含义都答不上来,10篇最终全部被拒稿,暴露出部分投稿者对自身论文缺乏实质理解的问题。
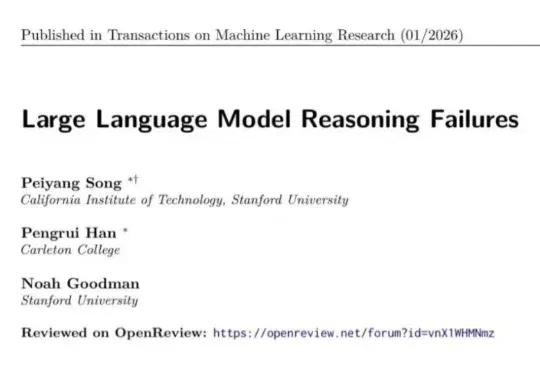
近期发表于 TMLR 的论文《Large Language Model Reasoning Failures》对这一问题进行了系统性梳理。该研究并未围绕 “模型是否真正理解” 展开哲学层面的争论,而是采取更加务实的路径 —— 通过整理现有文献中的失败现象,构建统一框架,系统分析大语言模型的推理短板。