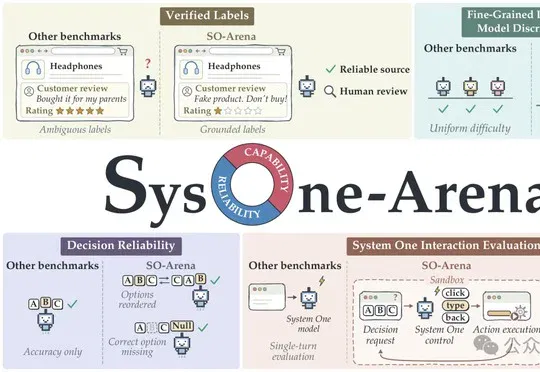
NUS发布System One模型评测基准:能力有多宽,决策有多稳?(在新窗口打开)
NUS xML Lab提出SO-Arena,以2919项任务评估System One模型的跨领域能力、选项重排稳定性及正确答案缺失识别。研究发现能力排名与可靠性排名不一致;本地单H100与远程API延迟采用不同测量口径。
共 5 篇
NUS xML Lab提出SO-Arena,以2919项任务评估System One模型的跨领域能力、选项重排稳定性及正确答案缺失识别。研究发现能力排名与可靠性排名不一致;本地单H100与远程API延迟采用不同测量口径。
当AI不再只会聊天。 TypeSafe在9月15日公开这款模型时,给它取了一个很大的名字,System One Model。 它不写回复,也不生成代码,只接收一段状态信息和一组问题,然后返回选择结果、分数或者概率。 上线没多久,社区里就出现两种截然不同的看法。 不少开发者直言,这个思路不算新鲜。给一段文字,配上几组备选答案,让模型挑最合适的选项,这类做法早就有人做过。 零样本分类就能完成类似任务,BERT类编码器也可以在固定标签里做判断,GLiNER和受约束解码还有别的实现方案。 Jev的架构、权重和训练细节又没有公开,因此很难仅凭产品发布就把底层方法认作技术突破。 第二种态度更偏向先用起来。
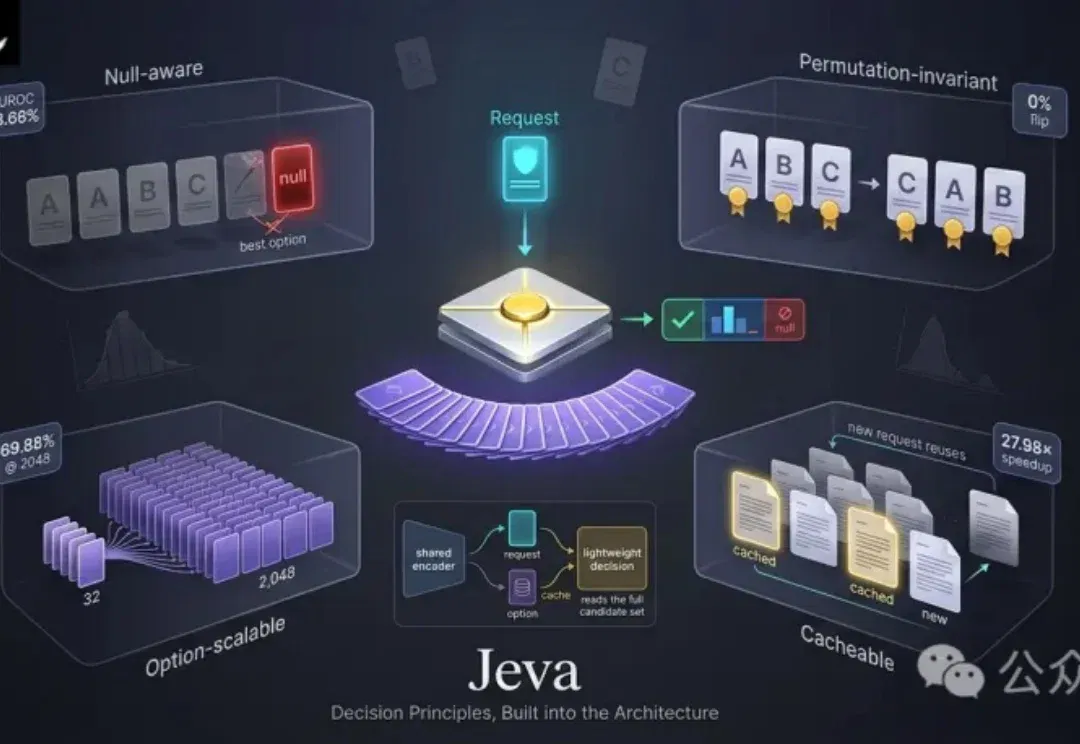
当任务的终点是决策,模型是否应该从决策本身出发?
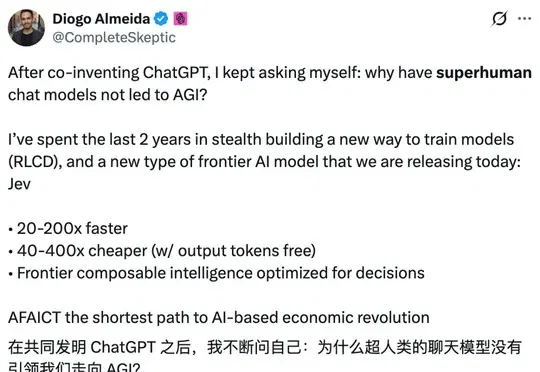
AI模型Jev开发商TypeSafe AI在9天内估值从2亿美元暴涨50倍至100亿美元以上,正洽谈逾10亿美元融资,Jev作为专为软件和Agent提供快速低成本判断的"System One模型"凭借Vercel等平台的快速采用获得投资人追捧。
前OpenAI研究员所在的TypeSafe AI于9月15日发布专门处理判断题的AI模型Jev,将其定义为System One Models,因在Agent评估、广告分析及浏览器操作等场景展现出的高速低成本能力而在开发者社区迅速走红,LangChain、OpenAI研究员Tibo等纷纷跟进关注。