全面战胜ReAct!斯坦福全新智能体推理框架,性能提升112.5%(在新窗口打开)
斯坦福和MIT的研究团队推出了一种新的AI智能体推理框架ReCAP,在长上下文任务中全面超越了现有的主流框架ReAct,性能提升显著。ReCAP通过独特的递归树结构和三大机制,解决了大语言模型在复杂任务中常见的目标漂移、上下文断层和成本爆炸等问题。
共 2 篇
斯坦福和MIT的研究团队推出了一种新的AI智能体推理框架ReCAP,在长上下文任务中全面超越了现有的主流框架ReAct,性能提升显著。ReCAP通过独特的递归树结构和三大机制,解决了大语言模型在复杂任务中常见的目标漂移、上下文断层和成本爆炸等问题。
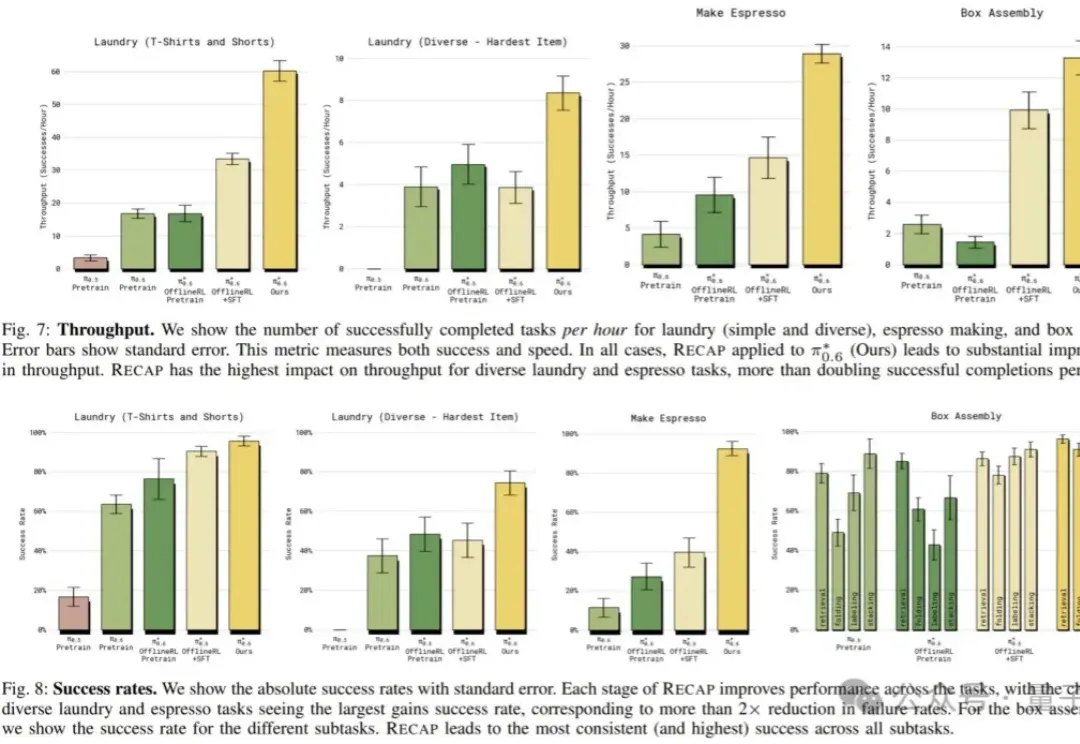
看似轻描淡写,实则力透纸背。 Physical Intelligence刷屏全网的机器人基础模型π*0.6,一亮相就秀出了实力: 让机器人连续一整天制作意式浓缩咖啡,数小时不间断折叠各类衣物,还能精准组装工厂所需的包装纸箱。 在π*0.6的加持下,这些任务的成功率都达到了90%以上。 然而,仔细阅读论文就会发现,比起连做13个小时咖啡,π*0.6真正的突破在于引入了一种更直觉的学习方法——Recap: 指导:用人类示范教它基础动作辅导:纠错指导让它修正错误练习:从自主经验中不断优化、变得更强 这彻底扭转了过去机器人只会逼近 “真值” 的模仿学习模式,让机器人能从自己的错误中成长。 就连网友也直