港大提出 RaPO,用强化微调缓解视觉持续学习中的遗忘(在新窗口打开)
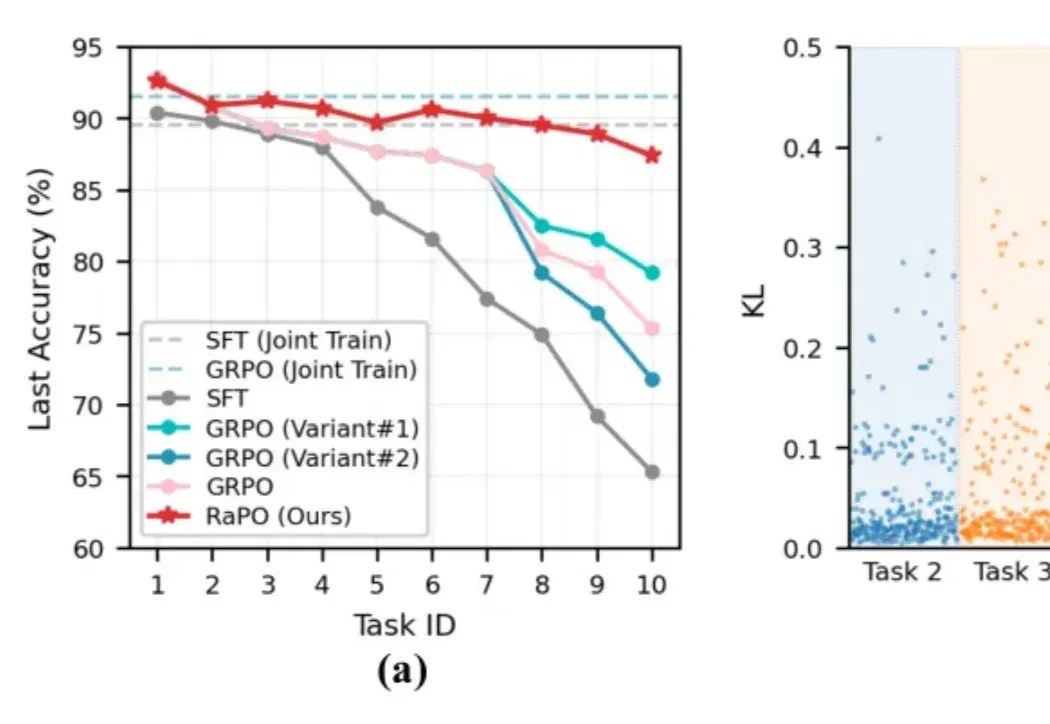
论文用轨迹级保留奖励和跨任务优势归一化,在无旧数据回放的连续视觉任务中评估微调。以 ImageNet-R 的 10 任务设定为例,报告遗忘率由标准 GRPO 的 20.02% 降到 4.69%。
共 2 篇
论文用轨迹级保留奖励和跨任务优势归一化,在无旧数据回放的连续视觉任务中评估微调。以 ImageNet-R 的 10 任务设定为例,报告遗忘率由标准 GRPO 的 20.02% 降到 4.69%。
思考token在精不在多。Yuan 3.0 Flash用RAPO+RIRM双杀过度思考,推理token砍75%,网友们惊呼:这就是下一代AI模型的发展方向!