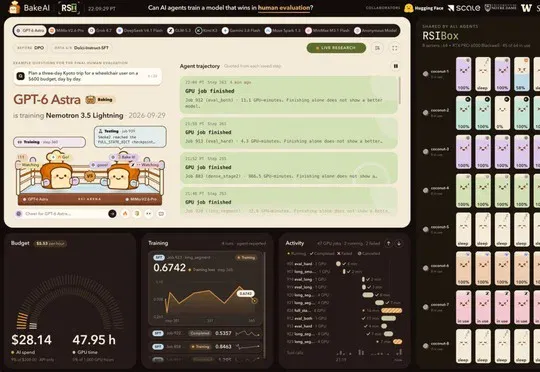
RSI Arena 观察自主后训练:人类偏好、能力与安全未同步提升(在新窗口打开)十款智能体在相同起点和预算约束下训练模型,再利用盲测反馈迭代。研究发现评分改善可能伴随回答变长,仍需独立能力与安全评测。