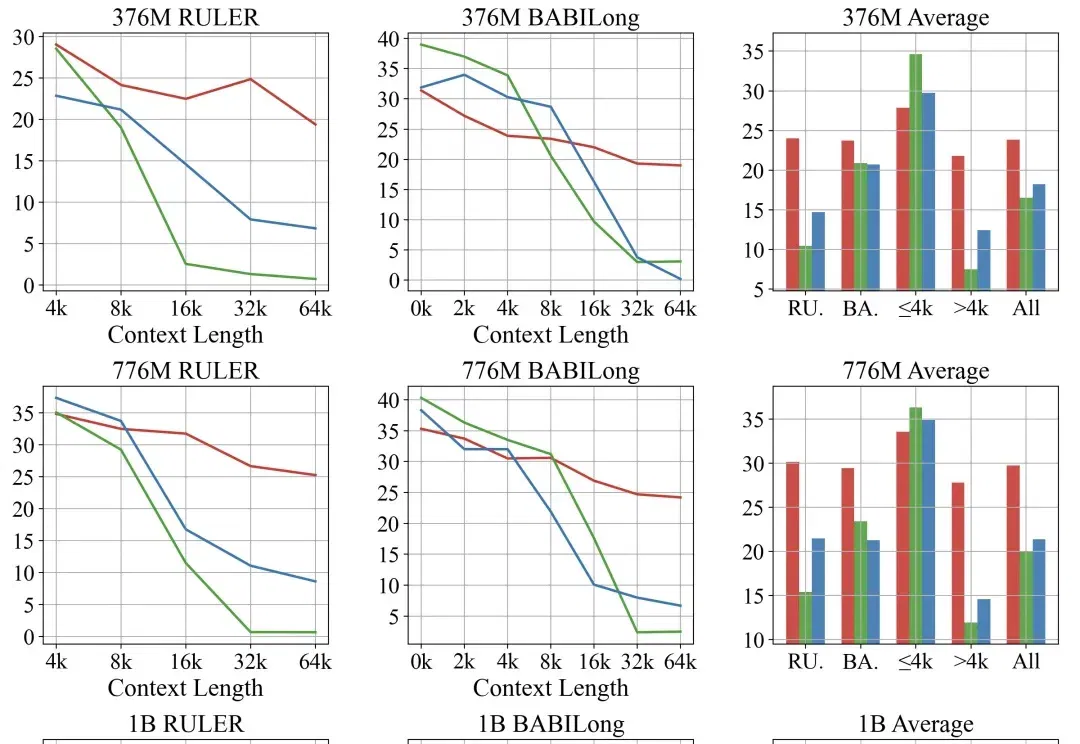
混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要(在新窗口打开)
OpenMOSS 团队比较全注意力、滑窗和门控线性注意力在长文训练与长度外推中的配合。实验发现,无位置偏置的 NoPE 与带位置偏置模块各有分工;增大窗口、调整损失或限制推理时的相对位置范围,可分别改善不同架构的短板。
共 3 篇
OpenMOSS 团队比较全注意力、滑窗和门控线性注意力在长文训练与长度外推中的配合。实验发现,无位置偏置的 NoPE 与带位置偏置模块各有分工;增大窗口、调整损失或限制推理时的相对位置范围,可分别改善不同架构的短板。
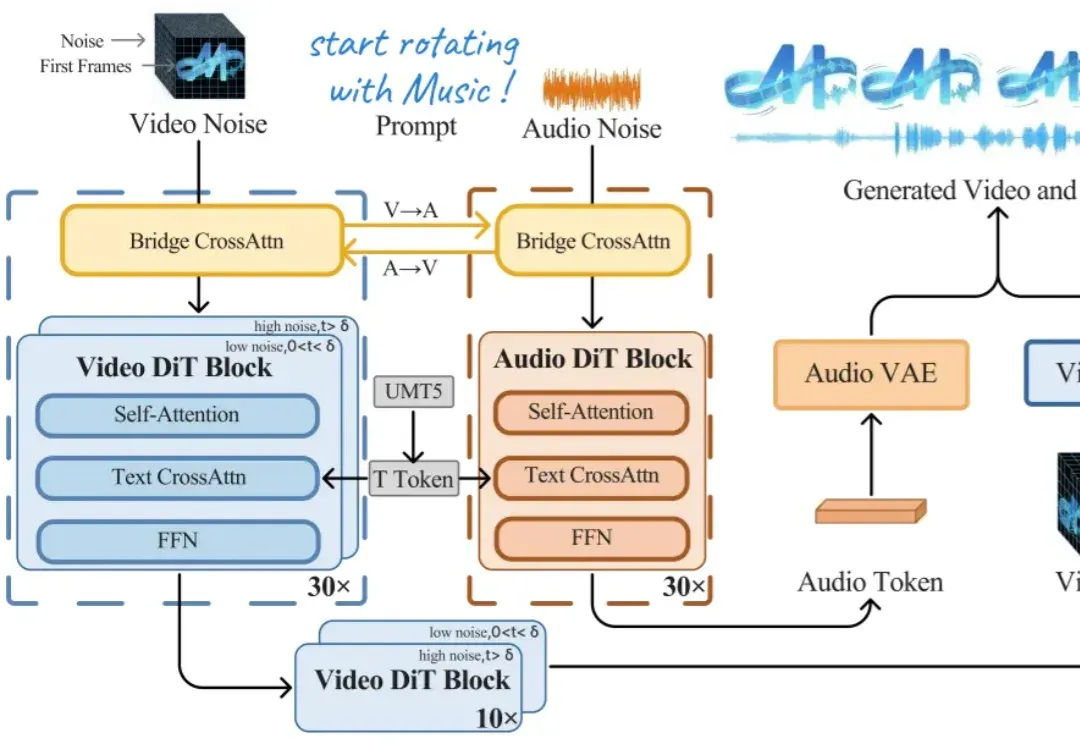
今天上午,上海创智学院 OpenMOSS 团队联合初创公司模思智能(MOSI),正式发布了端到端音视频生成模型 —— MOVA(MOSS-Video-and-Audio)。
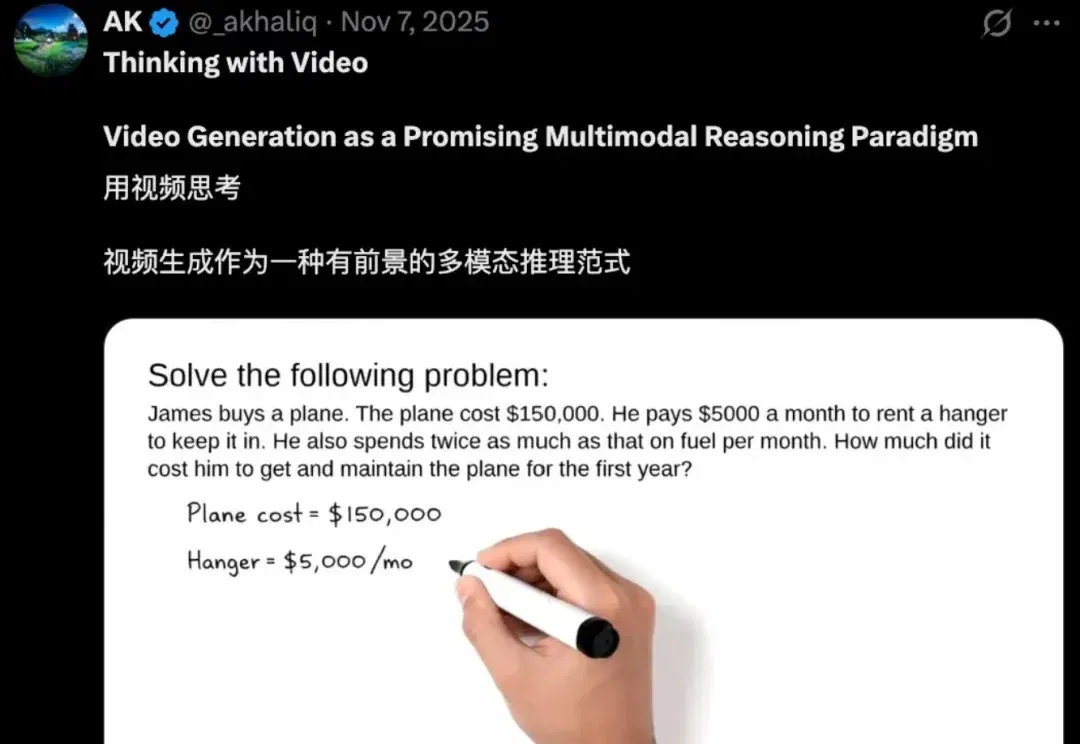
被CVPR 2026收录! 复旦邱锡鹏团队(OpenMOSS)首次提出Thinking with Video这一推理新范式: 借助视频生成模型,以视频帧为统一媒介进行多模态推理,打破视觉与文本的界限。 团队发现,Thinking with Text(基于文本的CoT推理)和Thinking with Images(在CoT中加上图像辅助推理)范式已大幅提升了LLMs和VLMs的推理能力。 但它们仍有局限:静态图像无法展现动态过程,文本与视觉模态的割裂阻碍了统一理解与生成。 而借助新范式Thinking with Video,视频生成模型在视觉任务上不仅总体媲美SOTA VLMs,而且竟也能解决