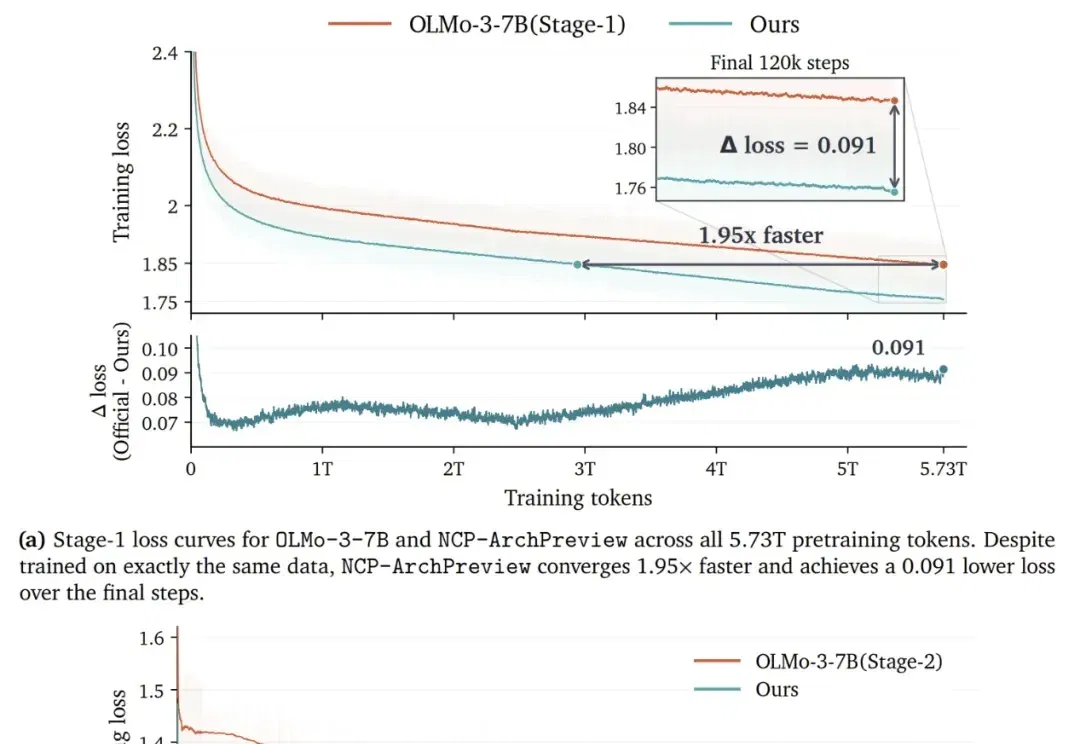
预训练Token消耗直接腰斩!上海AI Lab&上交大提出全新预训练任务,开源首个8.9B隐空间大模型NCP-ArchPreview(在新窗口打开)
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
共 1 篇
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?