搜索

关于“Multimodal models”的结果

共 3 篇

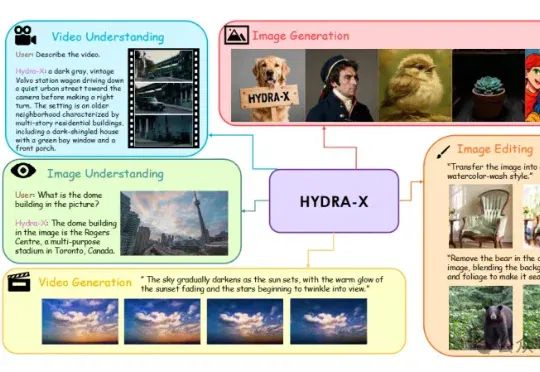
单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题

单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题(在新窗口打开)

南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。
AI技术文章
0
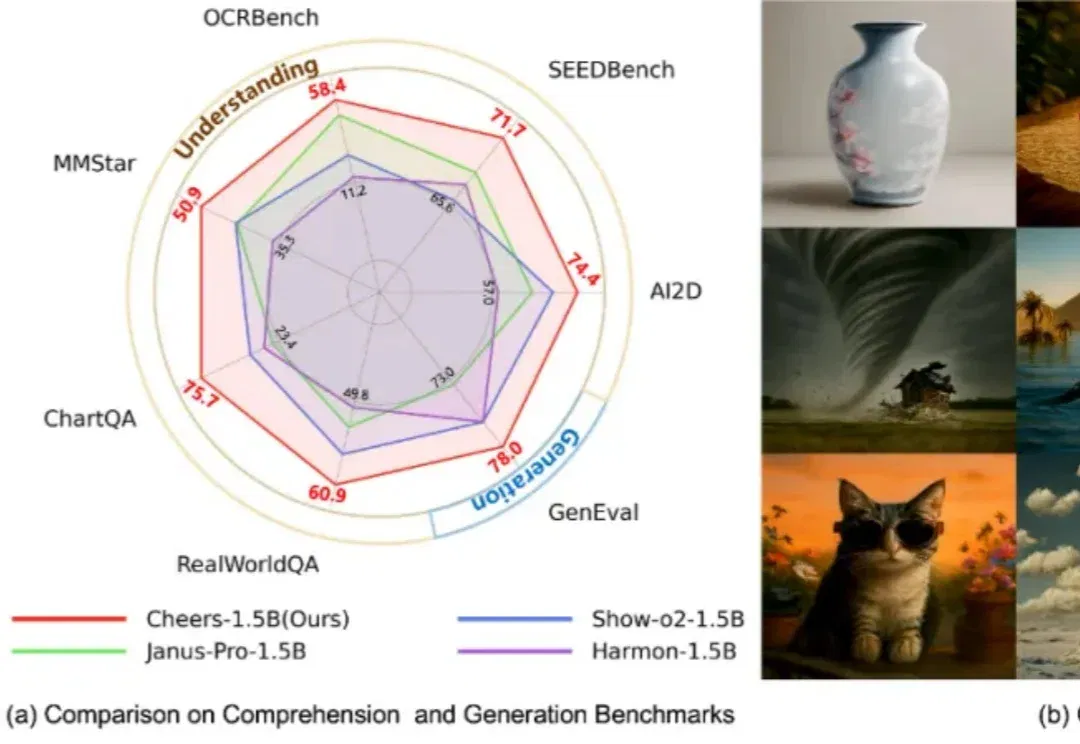
清华、西交联合开源发布了Cheers : 一条更简洁、更高效的统一多模态路线

清华、西交联合开源发布了Cheers : 一条更简洁、更高效的统一多模态路线(在新窗口打开)

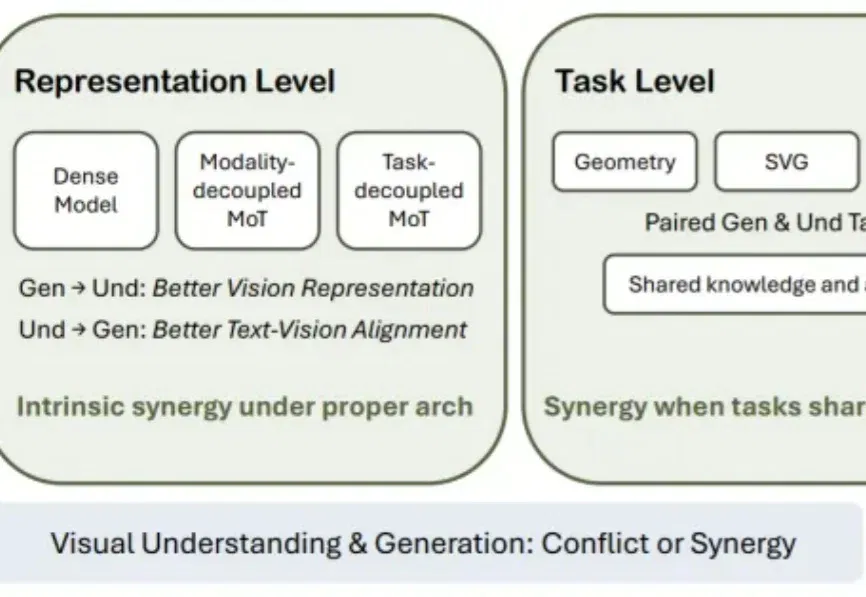
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。

AI技术文章
0