Flash模型又添一员大将:实测MiniMax M3.1(在新窗口打开)
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
共 5 篇
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
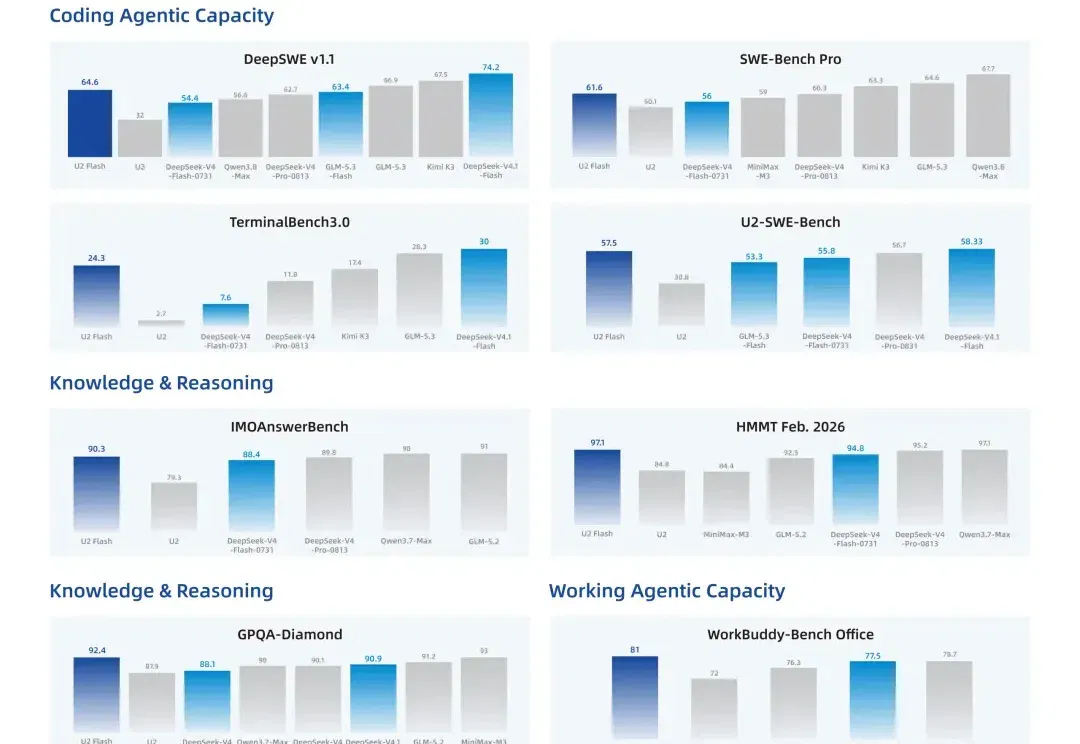
RSI,彻底火了。 从硅谷一路烧到国内,「让模型参与训练下一版自己」几乎一夜之间成了AI圈最热的叙事。 不过热闹归热闹,目前真正拿模型交卷的还屈指可数。 而就在这一当口,「港股AGI第一股」云知声正式发布U2-Flash,率先交出一份国产RSI早期答卷。 △图源:云知声 在U2-Flash的后训练闭环里,模型已经开始深度参与自身演进: 从生成训练数据、分析执行轨迹,到巡检和修复训练系统。 然后,反常识的部分来了。 按行业惯例,Flash一般默认是「旗舰平替」,通常更快、更便宜,但能力相对打折。 结果U2-Flash呢? 速度和省钱能力的提升确实没含糊。相比U2,其生成速度提升2.1倍,Agen
1492 年,哥伦布驶向大西洋深处。远洋航行当然需要速度,但真正决定船队能否抵达彼岸的,是淡水、食物、船体、桅杆和帆索能否撑过漫长风暴。改写跨洋贸易的,正是这种并不浪漫的工程逻辑。 后来,荷兰人设计出
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
DeepSeek据悉将迎来高瓴创投90后合伙人严文韬出任CFO,同时已聘请中信证券筹备上海科创板IPO,并近期发布了DeepSeek V4.1 Flash模型,资本与产品双线加速推进。