Context Engineering 2.0:在未来,一个人的本质,就是其所有上下文的总和|上海交大(在新窗口打开)
在几天前,上海交大发布了一篇名为 《上下文工程2.0:上下文工程的上下文》(Context Engineering 2.0: The Context of Context Engineering) 的重磅论文。
共 12 篇
在几天前,上海交大发布了一篇名为 《上下文工程2.0:上下文工程的上下文》(Context Engineering 2.0: The Context of Context Engineering) 的重磅论文。
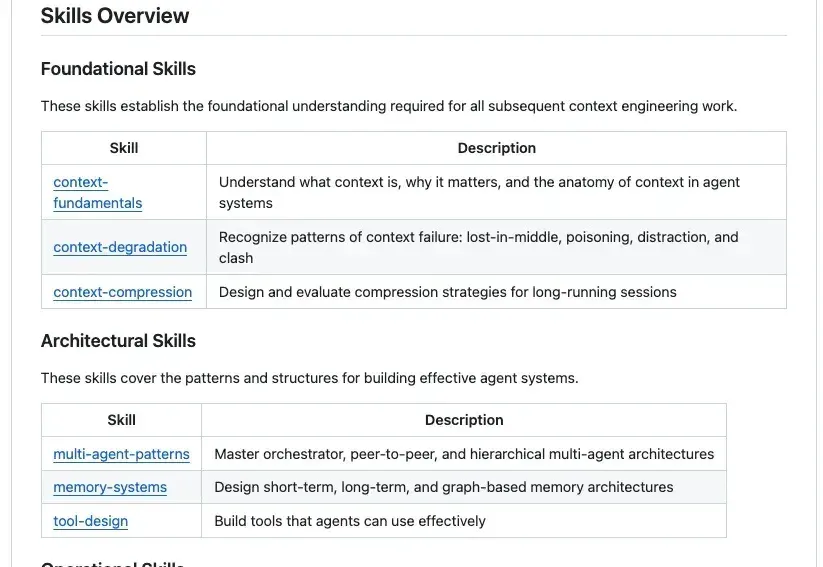
GitHub上最近出现了一个非常火的项目Agent-Skills-for-Context-Engineering,发布不到一周就斩获了2.3k Stars。为什么它能瞬间引爆社区?因为站在2025年末的节点上,我们已经受够了那些只存在于大厂白皮书里的Context Engineering(上下文工程) 理论。
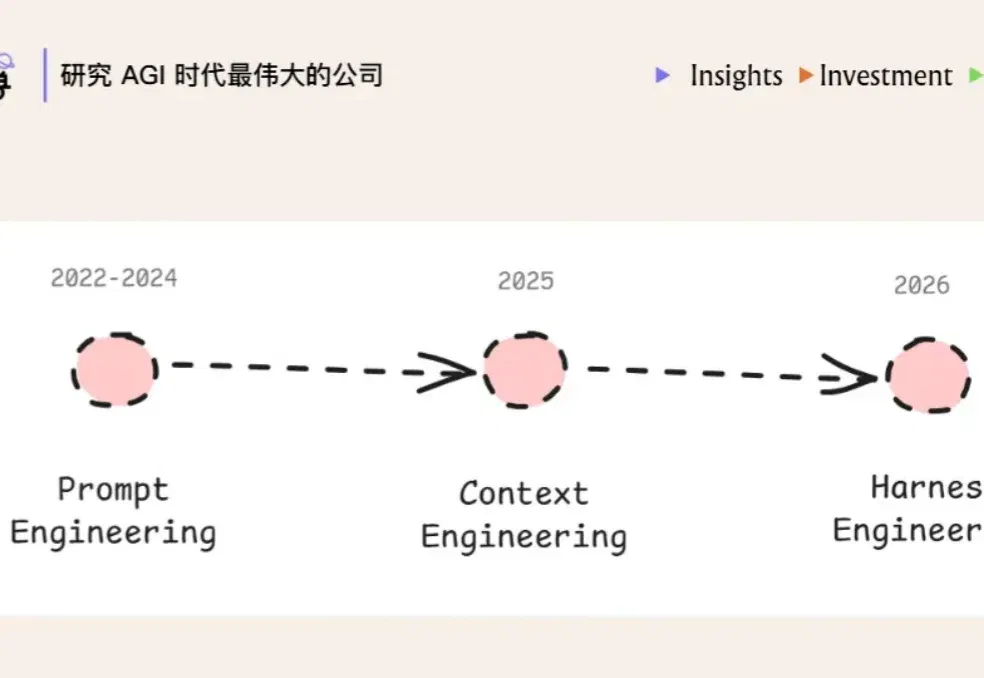
最近,harness engineering 又成了继 prompt engineering、context engineering 之后新一代的 buzzword。
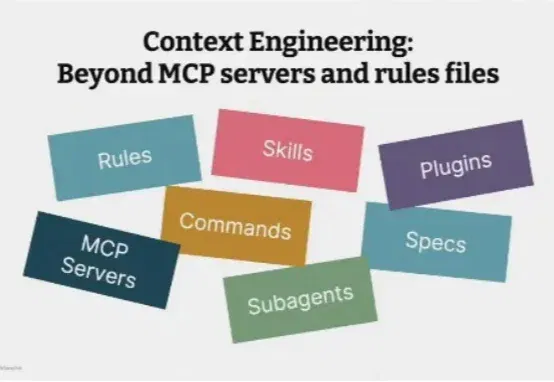
一年前,行业还在为“从自动补全到 Agent”的进化感到兴奋。然而一年过去,我们不难发现单纯靠“Vibe Coding”和“Prompt 调优”,面对非确定性模型带来的风险和成本问题,显然无法撑起企业级软件开发。
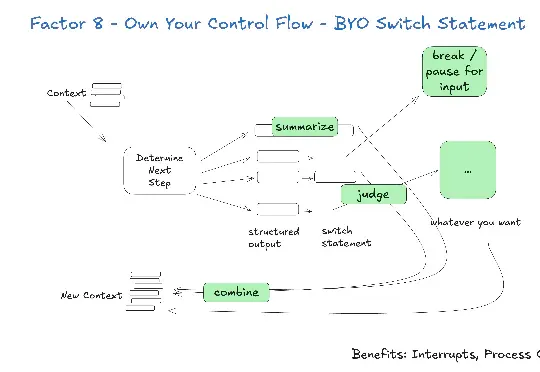
最近半年,我阅读了业界关于 AI Agent 的工程实践:Anthropic 的 Context Engineering 论文、Manus 的工程分享、Cline 的 Memory Bank 设计等。同时自己也一直在做跟 AI Agent 相关的项目,如:Jta[1](开源的翻译 Agent,基于 Agentic Workflow)。
谷歌在第三天发布了《上下文工程:会话与记忆》(Context Engineering: Sessions & Memory) 白皮书。文中开篇指出,LLM模型本身是无状态的 (stateless)。如果要构建有状态的(stateful)和个性化的 AI,关键在于上下文工程。
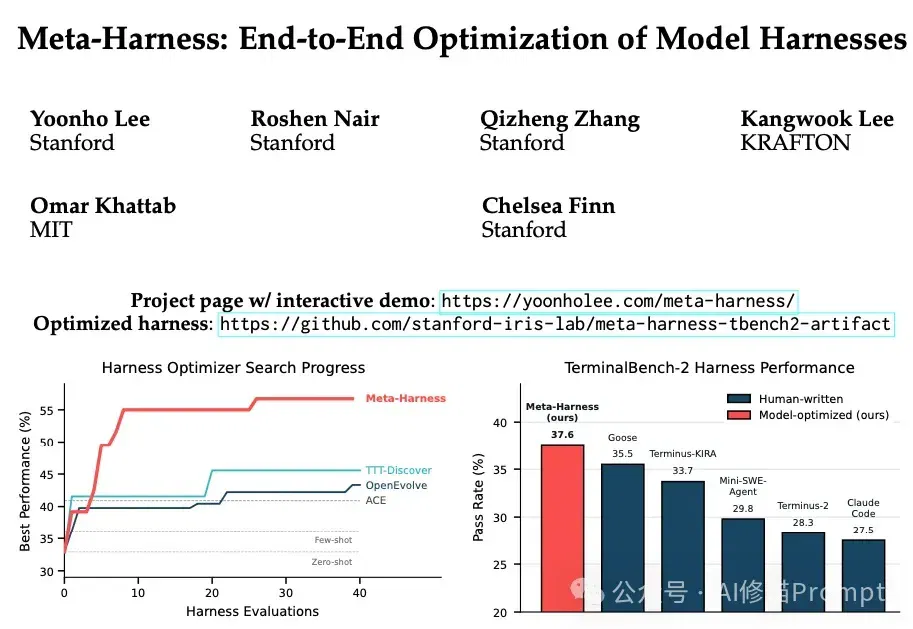
去年讨论Agent落地时,重点往往是Context Engineering。大家都在琢磨怎么放 Few-shot,怎么优化 RAG 检索的文本片段。但随着 Agent 任务复杂度的上升,控制数据流向、工具调度和异常处理的底层脚手架代码,往往比单纯拼接文本对系统性能的影响更大。
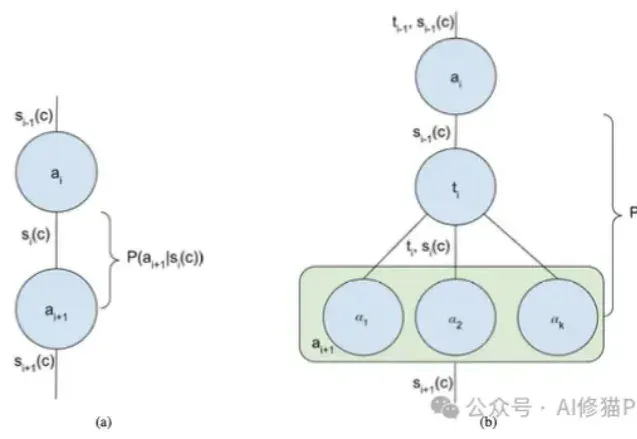
我们正处在一个AI Agent(智能体)爆发的时代。从简单的ReAct循环到复杂的Multi-Agent Swarm(多智能体蜂群),新的架构层出不穷。但在这些眼花缭乱的名词背后,开发者的工作往往更像是一门“玄学”,我们凭直觉调整提示词,凭经验增加Agent的数量,却很难说清楚为什么某个架构在特定任务上表现更好。
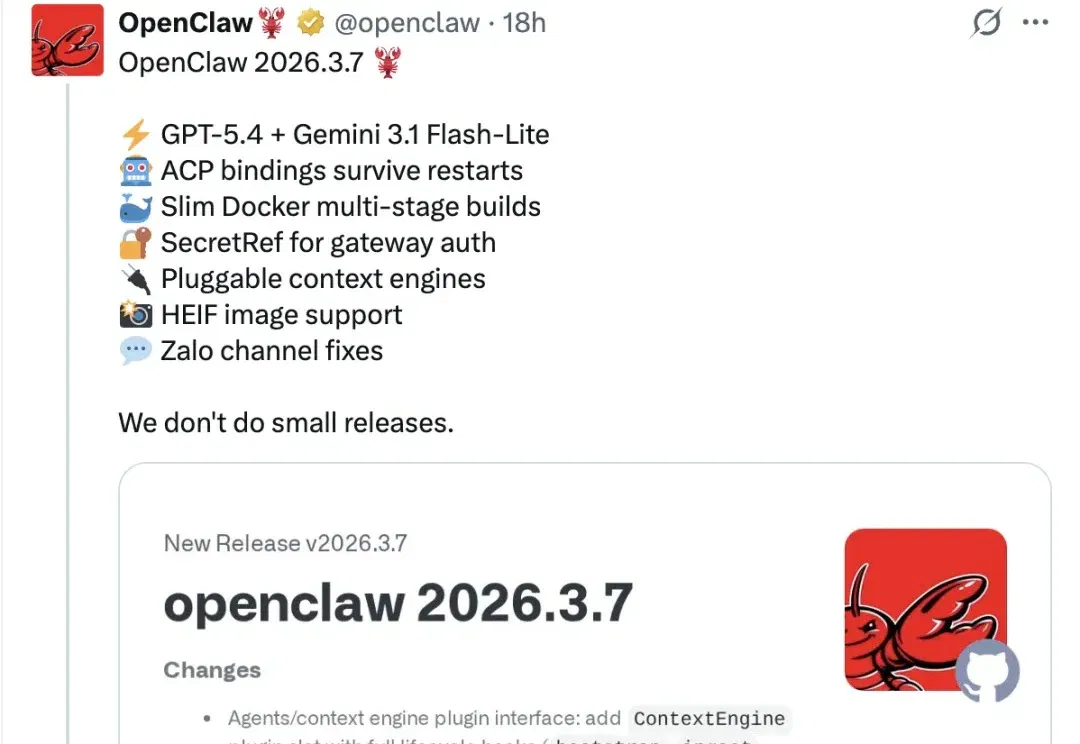
报!龙虾更新了! 刚刚,新的OpenClaw测试版(2026.3.7)已经推出,并光速上线OA两家最新模型GPT-5.4和Gemini Flash 3.1。 与此同时,一并更新的还有: ACP绑定在重启后依然可保留精简版Docker多阶段构建 用于网关认证的SecretRef 可插拔的上下文引擎 支持HEIF图像格式 修复Zalo渠道问题 其中,可插拔的上下文引擎(pluggable context engine)可谓是这次更新的重点,不少网友纷纷表示: 相比于跑那个模型,上下文才是关键。 细心的你甚至还发现了,在官方的changelog上直接点名了一个插件例子lossless-claw。 那
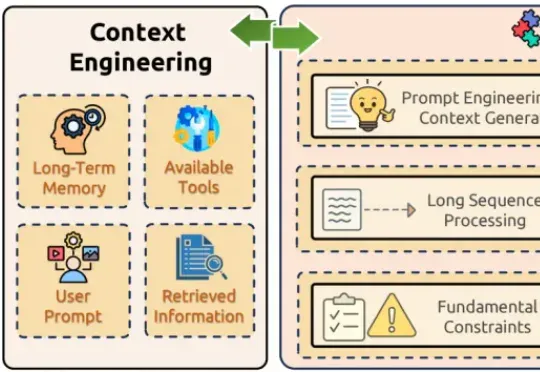
RAG效果不及预期,试试这10个上下文处理优化技巧。对大部分开发者来说,搭一个RAG或者agent不难,怎么把它优化成生产可用的状态最难。在这个过程中,检索效率、准确性、成本、响应速度,都是重点关注问题。