搜索

关于“ASP”的结果

共 18 篇

6.6万人排队!小米旗舰“超速”模型延长体验时间,官方:500强争着用

6.6万人排队!小米旗舰“超速”模型延长体验时间,官方:500强争着用(在新窗口打开)

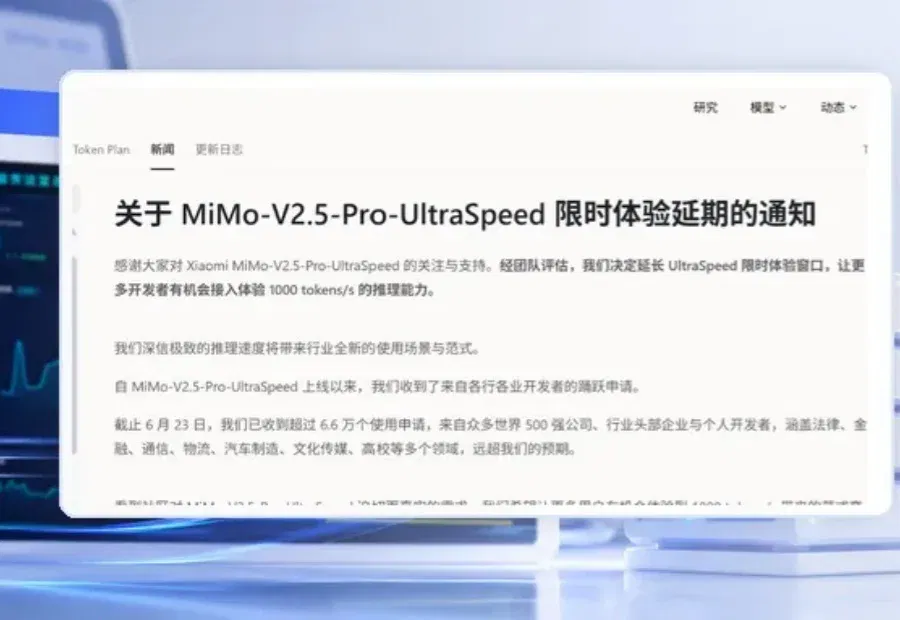
小米UltraSpeed需求远超预期。 智东西6月24日消息,昨日,小米MiMo开放平台发布公告,宣布延长旗下MiMo-V2.5-Pro-UltraSpeed模型的聊天体验与API接入体验期限。该模型于6月9日上线,原定体验窗口截至6月23日,但由于申请量远超预期,团队决定延长开放时间。 ▲关于MiMo-V2.5-Pro-UltraSpeed限时体验延期的通知(图源:小米MiMo) 官方数据显示,截至6月23日,MiMo-V2.5-Pro-UltraSpeed已收到超过6.6万个使用申请,申请者包含世界500强公司、行业头部企业与个人开发者,涵盖法律、金融、通信、物流、汽车制造、文化传媒、高校
AI资讯
0
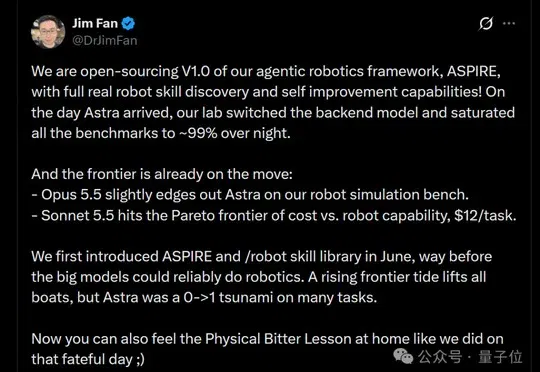
具身智能的Skill时刻!英伟达开源机器人技能库,Jim Fan:范式变了

具身智能的Skill时刻!英伟达开源机器人技能库,Jim Fan:范式变了(在新窗口打开)

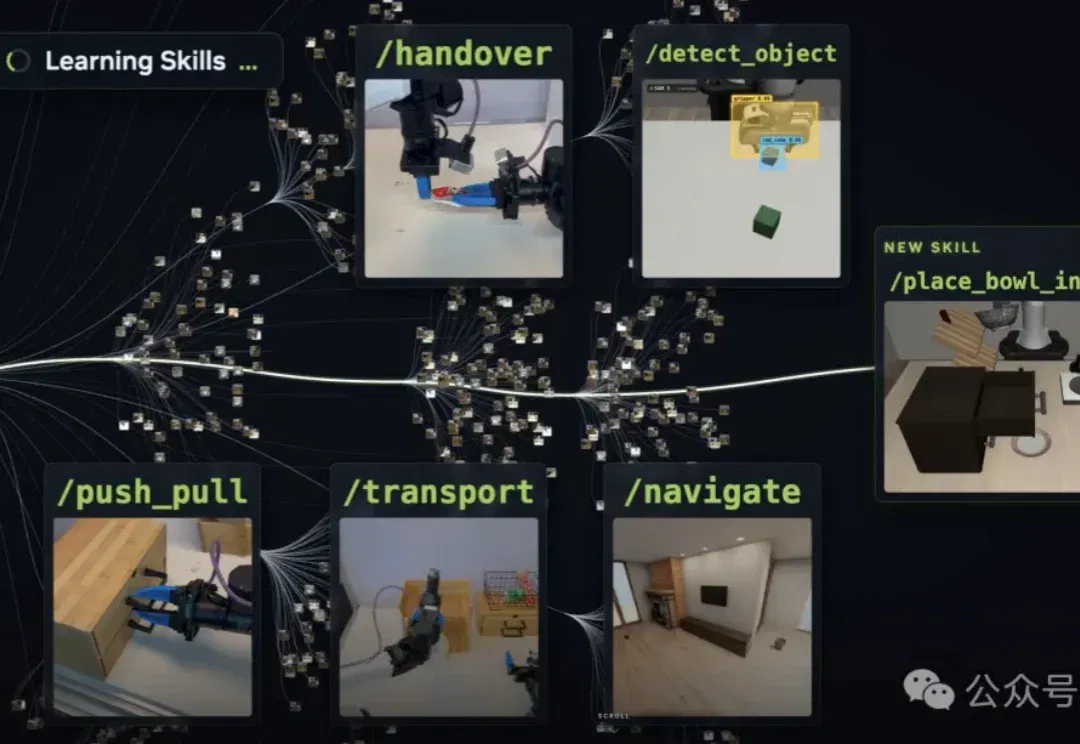
6!机器人也能学Skill了。 刚刚,英伟达放出了一套能让机器人持续成长的技能库—— ASPIRE。 简单理解,ASPIRE有点像一个机器人版Coding Agent。 就跟GPT能把你的prompt、工作记录炼成可复用的skill一样,它也会把机器人的一次次失败和修复,沉淀成之后能继续调用的经验。 只不过,它review的不是代码,而是机器人的操作过程。 每当机器人执行任务时,ASPIRE就会把感知、导航、抓取、碰撞、运动规划这些过程都记下来。 它背后调用的GPT / Claude则会像研究员一样,判断任务中哪里出了问题,迭代程序。如果跑通,就把沉淀出来的经验写进Skill。 由此,机器人就

AI技术文章
0
ICRA 2026|NUS邵林团队提出T(R,O) Grasp:刷新跨智能体灵巧抓取SOTA,实现5FPS动态环境交互

ICRA 2026|NUS邵林团队提出T(R,O) Grasp:刷新跨智能体灵巧抓取SOTA,实现5FPS动态环境交互(在新窗口打开)

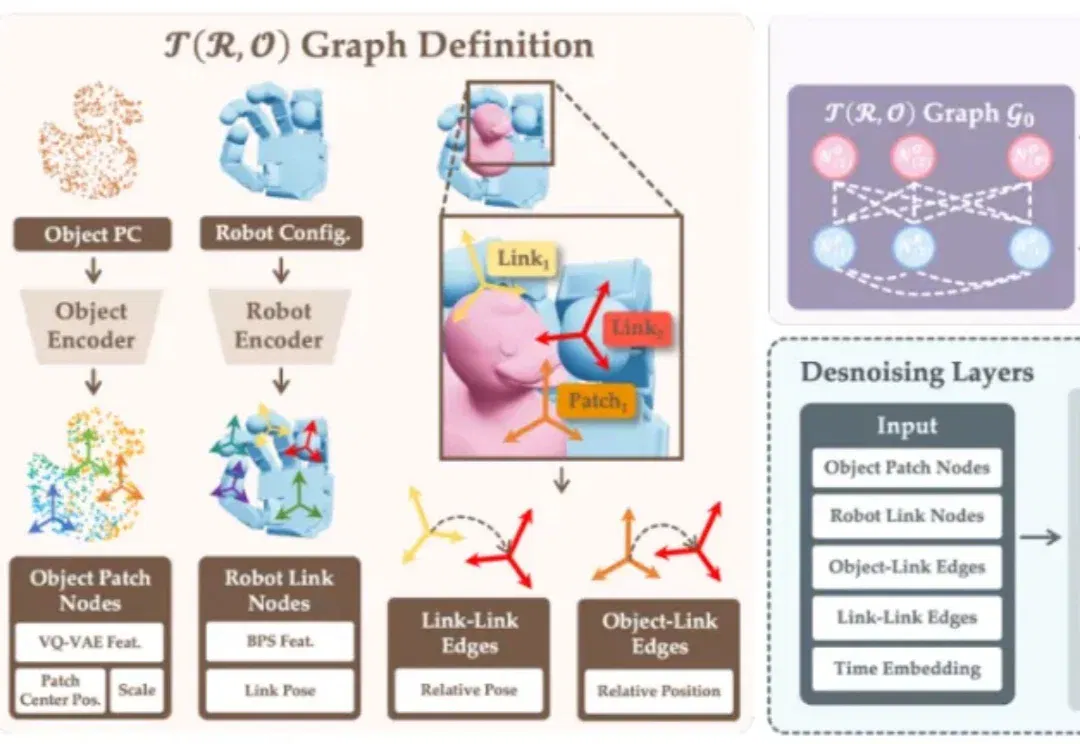
T (R,O) Grasp 是一种基于物体 — 机器手空间关系建模的图扩散架构,具备跨智能体的统一表征能力。在 NVIDIA 40GB A100 GPU 上,该方法可实现 5 FPS 的推理速度和 50 grasp/s 的吞吐量,并在多种智能体上取得 94.83% 的平均抓取成功率,刷新了跨智能体灵巧抓取的 SOTA,具备与动态场景实时交互的能力。

AI技术文章
0
两位95后打造“伴身智能”硬件,获商汤国香、奇绩创坛千万元级投资

两位95后打造“伴身智能”硬件,获商汤国香、奇绩创坛千万元级投资(在新窗口打开)

一枚戒指里的“Token经济学”。 2024年11月,深圳,凌晨三点。腾讯滨海大厦楼下的空气里弥漫着南方特有的潮湿,一场对话已经持续数个小时。 这场谈话的主角是两位95后,Jasper和黄鑫晨(Xander)。当时,他们正站在人生重要的十字路口上——是继续留在各自的职业高光安稳度日,还是放下已有的成绩,踏上一条从未有人走过的路,开始一次创业冒险? Jasper出自全球顶级人工智能研究机构Mila研究院,是图灵奖得主、全球深度学习三巨头之一约书亚・本吉奥(Yoshua Bengio) 实验室成员。近年来,他一直在做AI for Science相关的研究,在和英特尔、IMC、腾讯、Oura的合作经

AI资讯
0
罗福莉带小米登顶全球开源榜首!大规模RL立功,斩杀Grok 4.7

罗福莉带小米登顶全球开源榜首!大规模RL立功,斩杀Grok 4.7(在新窗口打开)

大模型江湖变天了。 9月21日,小米MiMo团队正式发布并全面开源新一代MiMo V2.6系列,一口气端出三款模型——Pro、Flash、Ultraspeed,直接改写全球开源模型的格局。 MiMo V2.6 Pro在Artificial Analysis智能指数(AA Intelligence Index v4.3)中拿下 46 分,超过Kimi K3和Qwen3.8 Max。 全球开源模型第一、国产模型第一! 拉出AA榜单横着看:Fable 5.1得分53,GPT-6 Astra得分52.8,Opus 5得分50.7。 MiMo V2.6 Pro虽然还没追平这几位「天花板」,但已经稳稳站进

AI资讯
0
NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了

NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了(在新窗口打开)

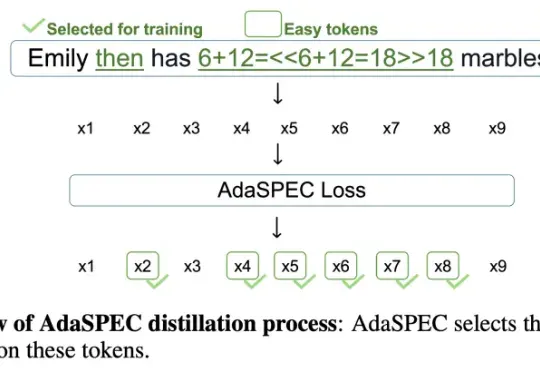
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。

AI技术文章
0