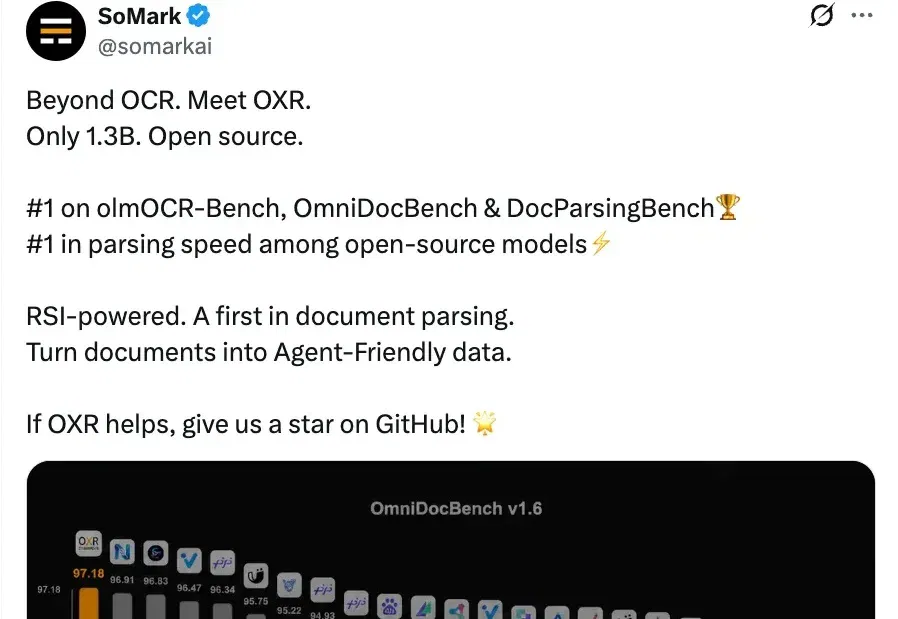
开源文档解析模型 OXR,如何结合自我改进与可插拔版面分析(在新窗口打开)
OXR 面向复杂文档的文字、表格、公式和阅读顺序解析。报道拆解其预测分类、错误归因和数据生成的后训练循环,并介绍版面分析与内容识别分工、本地部署和开源资源入口。
共 4 篇
OXR 面向复杂文档的文字、表格、公式和阅读顺序解析。报道拆解其预测分类、错误归因和数据生成的后训练循环,并介绍版面分析与内容识别分工、本地部署和开源资源入口。
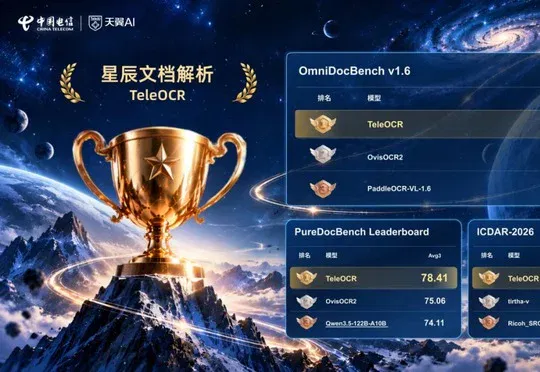
中国电信星辰通用人工智能实验室推出的轻量化文档解析模型TeleOCR(约1.2B参数)凭借形变感知学习、多边形版面分割、CGDP采样及内容—结构解耦等技术创新,在OmniDocBench v1.6、Wild-OmniDocBench、PureDocBench等多个公开榜单取得领先,并在ICDAR 2026 Sci-ImageMiner挑战赛中夺冠,目前已开源。
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
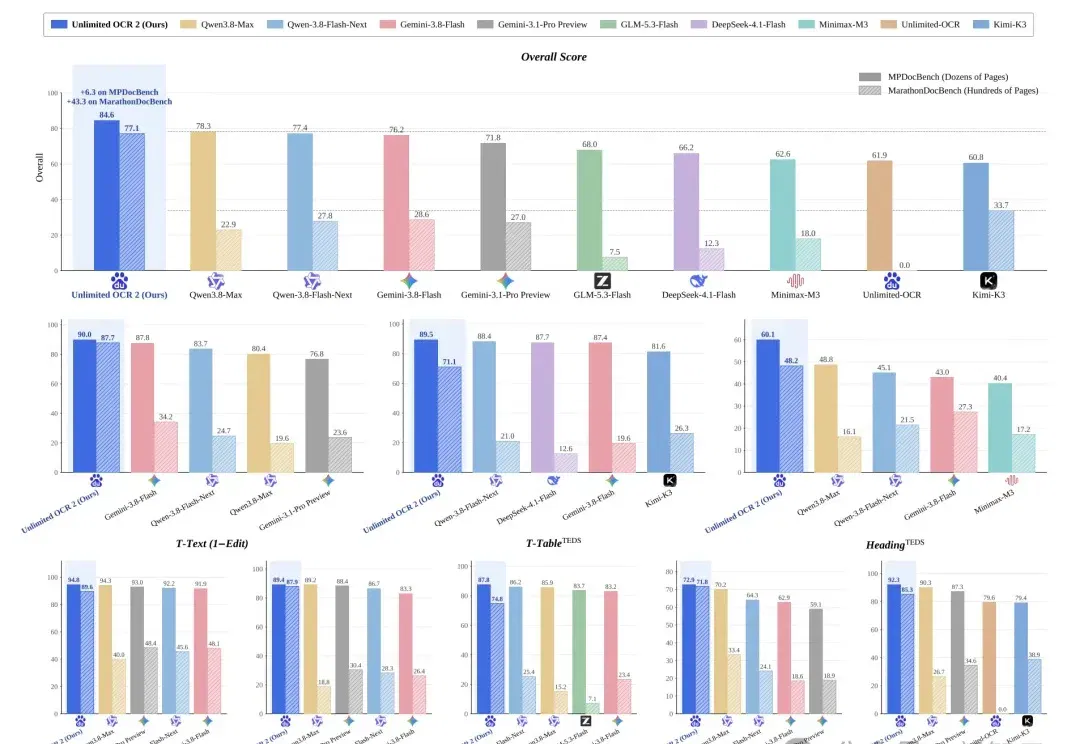
曾获LeCun转发推荐、狂揽1,000万下载的百度开源神作,又杀回来了!