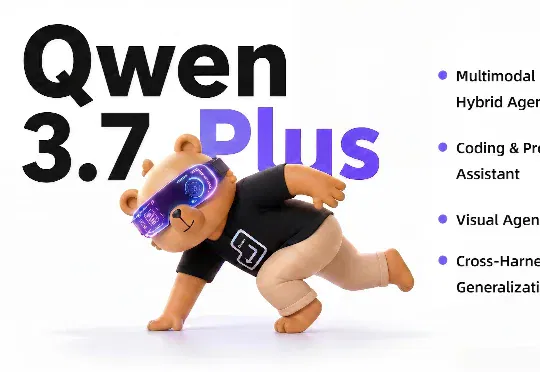
阿里通义千问发布多模态智能体模型Qwen3.7-Plus,让AI从“读懂世界”,走向“动手完成任务”。(在新窗口打开)
今天,阿里通义千问发布多模态智能体模型Qwen3.7-Plus。相比传统“看图说话”式多模态模型,Qwen3.7-Plus在识别图像的基础上,进一步打通界面感知、工具调用、代码生成和任务交付,让AI从“读懂世界”,走向“动手完成任务”。
共 2 篇
今天,阿里通义千问发布多模态智能体模型Qwen3.7-Plus。相比传统“看图说话”式多模态模型,Qwen3.7-Plus在识别图像的基础上,进一步打通界面感知、工具调用、代码生成和任务交付,让AI从“读懂世界”,走向“动手完成任务”。
商汤首席科学家林达华在专访中判断,未来一两年多模态将迎来能力涌现的"GPT时刻",并阐述商汤以原生理解生成统一模型U系列和多模态智能体模型SenseNova 6.8为核心的长期技术路线。