Anthropic CEO再预警:未来5年砍掉一半入门岗,失业率10–20%(在新窗口打开)
数据显示,仅2025年开年以来,美国已有超过一万个岗位因为引入AI而被裁撤。Anthropic CEO Dario Amodei认为AI技术的扩散对就业和社会的冲击,已经到了必须向全世界预警的地步。
共 997 篇
数据显示,仅2025年开年以来,美国已有超过一万个岗位因为引入AI而被裁撤。Anthropic CEO Dario Amodei认为AI技术的扩散对就业和社会的冲击,已经到了必须向全世界预警的地步。
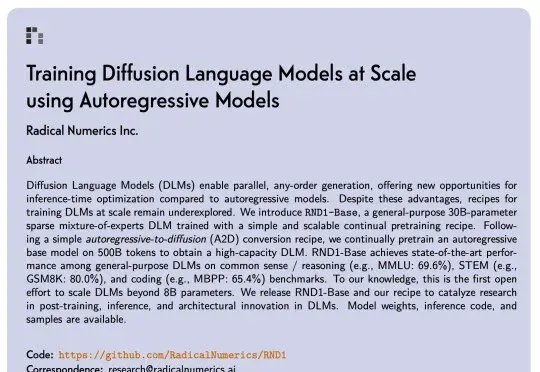
扩散语言模型(Diffusion Language Models,DLM)一直以来都令研究者颇感兴趣,因为与必须按从左到右顺序生成的自回归模型(Autoregressive, AR)不同,DLM 能实现并行生成,这在理论上可以实现更快的生成速度,也能让模型基于前后文更好地理解生成语境。
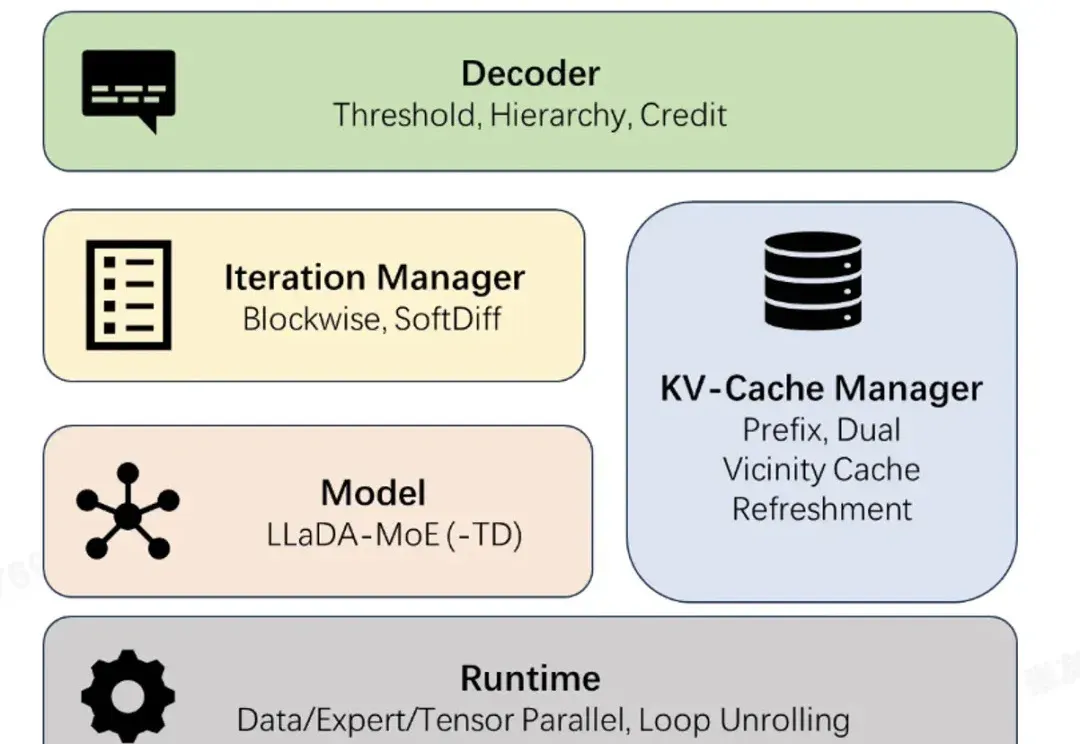
近日,蚂蚁集团正式开源业界首个高性能扩散语言模型(Diffusion Large Language Model,dLLM)推理框架 dInfer。
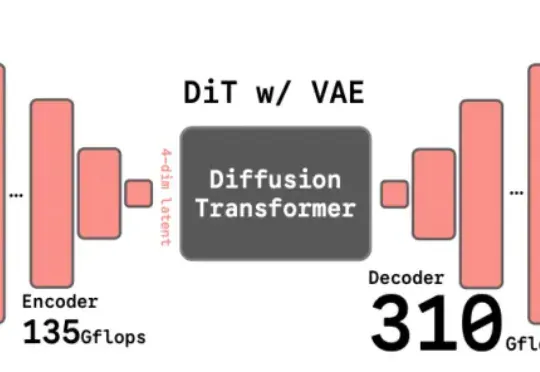
谢赛宁团队最新研究给出了答案——VAE的时代结束,RAE将接力前行。其中表征自编码器RAE(Representation Autoencoders)是一种用于扩散Transformer(DiT)训练的新型自动编码器,其核心设计是用预训练的表征编码器(如DINO、SigLIP、MAE 等)与训练后的轻量级解码器配对,从而替代传统扩散模型中依赖的VAE(变分自动编码器)。
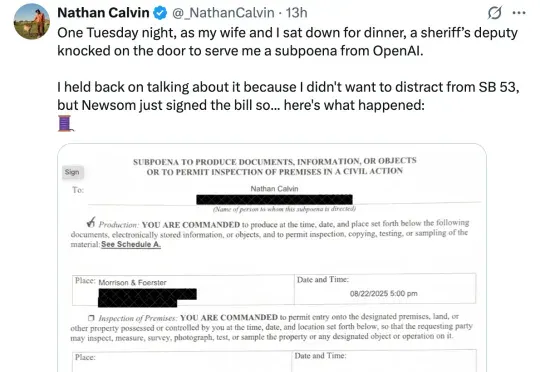
几个小时前,一位名为 Nathan Calvin 的 X 网友发推文称,「一个周二晚上,我和妻子正准备吃晚饭,一位副警长敲门,递给了我一张 OpenAI 的传票」。该传票不仅涉及他所在的 Encode 组织,还要求 Calvin 提供与加州立法者、大学生和前 OpenAI 员工的私人信息。而这一切都与一项近期通过的名为 SB 53 的法案有关。
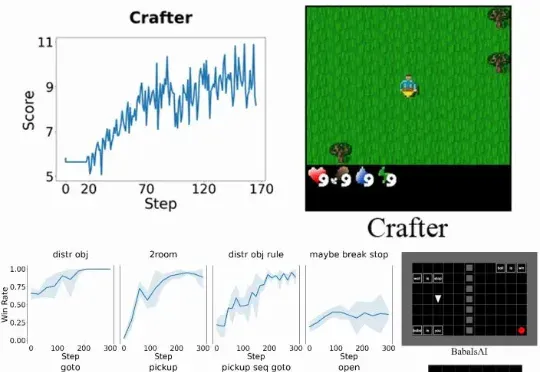
具体而言,Verlog 是一个多轮强化学习框架,专为具有高度可变回合(episode)长度的长时程(long-horizon) LLM-Agent 任务而设计。它在继承 VeRL 和 BALROG 的基础上,并遵循 pytorch-a2c-ppo-acktr-gail 的成熟设计原则,引入了一系列专门优化手段,从而在任务跨度从短暂交互到数百回合时,依然能够实现稳定而高效的训练。
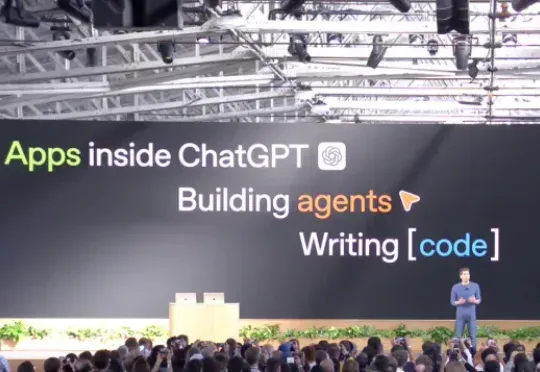
OpenAI 2025开发者日上,全场座无虚席。奥特曼重磅官宣四大更新:首发Apps SDK要把ChatGPT打造为「操作系统终极入口」,一键拖拽构建智能体AgentKit,无代码Codex开发,以及Sora 2等三大API登场。OpenAI的野心,彻底藏不住了。
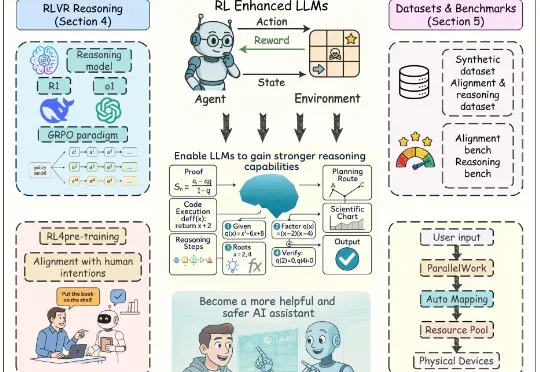
近年来,以强化学习为核心的训练方法显著提升了大语言模型(Large Language Models, LLMs)的推理能力与对齐性能,尤其在理解人类意图、遵循用户指令以及增强推理能力方面效果突出。尽管现有综述对强化学习增强型 LLMs 进行了概述,但其涵盖范围较为有限,未能全面总结强化学习在 LLMs 全生命周期中的作用机制。
当科技巨头们终于调转庞大的船头,驶向这片“新大陆”时,他们发现,早已有人在这里深耕。面壁智能(ModelBest)就是其中最坚定的先行者之一。早在“端侧AI”成为巨头们发布会上的热词之前,这支团队就已笃定云端API路线的局限,并确立了以提升“知识密度”为核心,在端侧“以小博大”的独特技术路径。
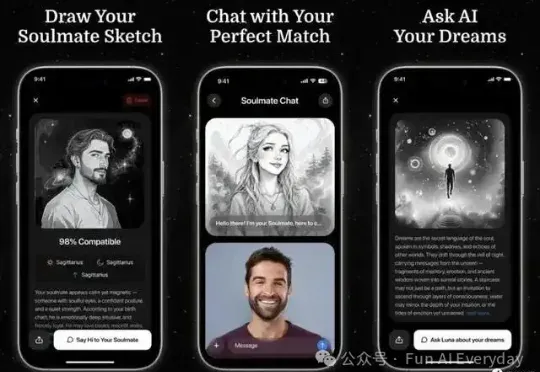
HubX 和 Codeway 的模式几乎一模一样,它没有选择单点突破式的产品路线,而是搭建起一个由 自治工作室+ 中央 Hub 组成的组织架构。一方面,每个工作室专注于特定应用的快速开发与迭代;另一方面,中央 hub 提供统一的技术、资金与数据支持。