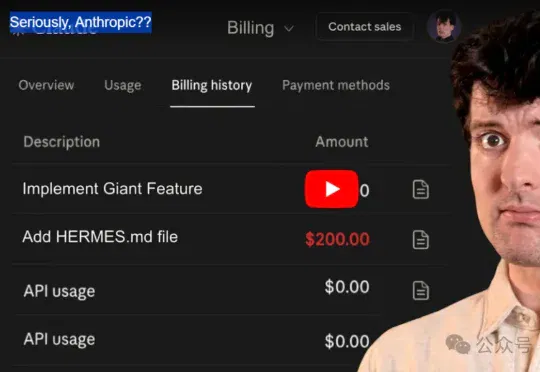
Claude被曝按关键字付费,现在官方愿意退款或者补偿,你准备好了?(在新窗口打开)
不是 Anthropic 主动通知,不是账单透明到让用户自己看出来,是一个 Reddit 帖子,一个 YouTube 视频,一堆截图,在社区里流传开了,才终于有官方工作人员在 X 的评论区回复,说这是第三方恶意工具引入的 BUG,已经退款并做了补偿。
共 1092 篇
不是 Anthropic 主动通知,不是账单透明到让用户自己看出来,是一个 Reddit 帖子,一个 YouTube 视频,一堆截图,在社区里流传开了,才终于有官方工作人员在 X 的评论区回复,说这是第三方恶意工具引入的 BUG,已经退款并做了补偿。
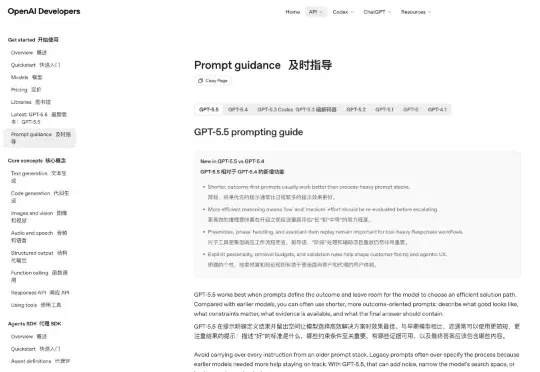
OpenAI 和 Anthropic 几乎在同一时间发布自己的提示词文档,在 OpenAI 官网,从 GPT-4.1 到 GPT 5.5,每次新模型发布都有一份完整的提示词指南,告诉我们怎么用新的模型。
Grok 4.3 是 xAI 一次务实升级:更便宜、更快、更像能干活的助手。但它在硬推理、稳定性和可信度上,仍落后 GPT-5.5 与 Claude Opus 4.7。
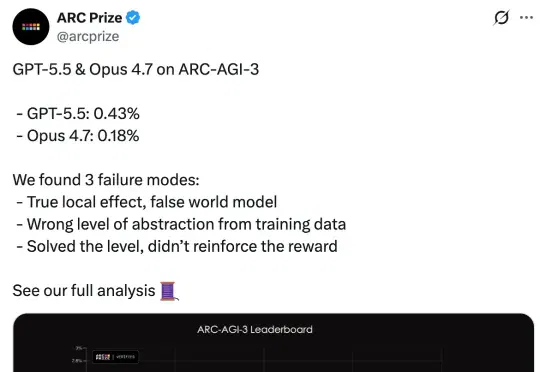
近日,ARC Prize 官方发布了针对这两款顶级模型的详细分析报告,结果令人震惊:在面对未见过的逻辑任务时,两者的表现得分均低于 1%,GPT-5.5 得分 0.43%,Claude Opus 4.7 得分 0.18%。
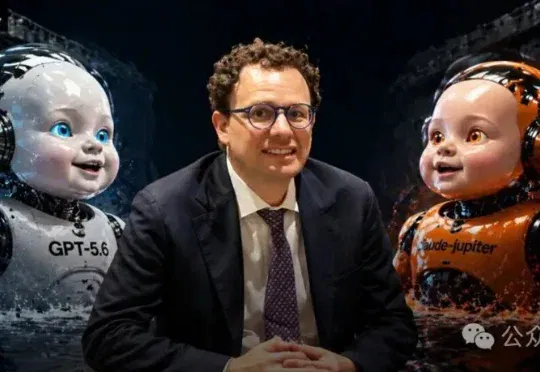
GPT-5.5发布没几天,后台日志里就冒出了GPT-5.6;Anthropic的一个从未见过的代号——Jupiter也炸出了!两天之内,两家巨头的下一代模型同时浮出水面。新一轮模型军备竞赛,比我们想的都要快!
AI界深水炸弹!4月29日,Anthropic被爆正在谈判新一轮融资,估值可能突破9000亿美元。如果交割完成,这家成立不到四年的公司将一举超越OpenAI,成为地球上最贵的AI独角兽。
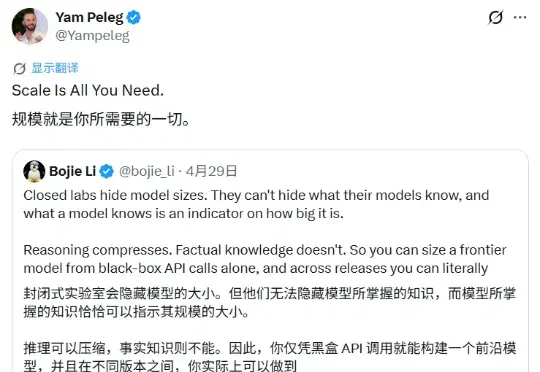
基于此,研究者在 89 个参数量已知的开源模型(规模从 1.35 亿到 1.6 万亿参数)上拟合出事实准确率与参数量的对数线性关系,拟合优度 R² = 0.917,并据此对闭源模型进行参数估算。
程序员们,先别忙着焦虑 AI 会抢走你的饭碗。现在更该焦虑的,可能是你们的 CTO 和 CFO 了:因为让 AI 写代码,实在太烧钱了。今天(4 月 28 日),GitHub 宣布从 2026 年 6 月 1 日起,GitHub Copilot 将告别“无限畅饮”模式,将 Copilot 从“按请求计费”转为“按使用量计费”。
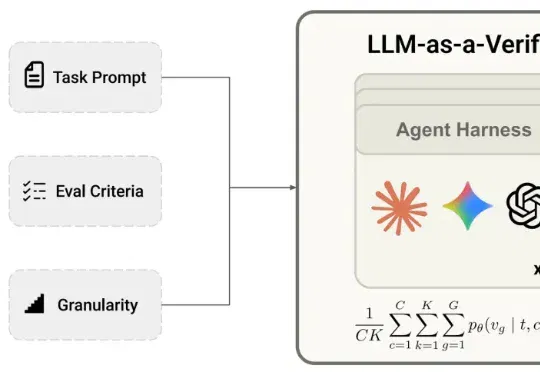
Transformer论文作者Lukasz Kaiser以及GAN作者Bing Xu转发关注了一项工作——LLM-as-a-Verifier验证框架,该方法是一种通用的验证机制,可与任意Agent Harness和模型结合。
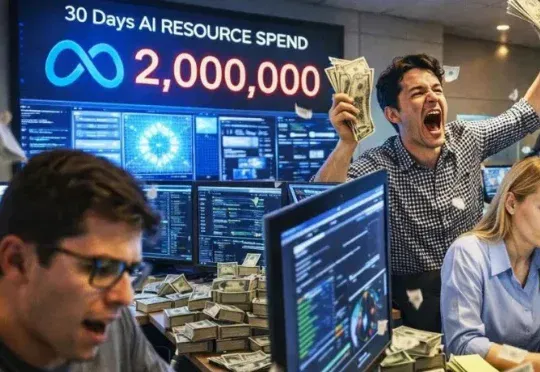
Meta内部搞了个AI用量排行榜「Claudeonomics」,8.5万员工拼消耗、冲段位、抢「Token传奇」称号。有人一个月烧掉200万美元,有人写外挂冲榜,有人挂着Agent睡觉也在跑——硅谷卷Token,已经卷到走火入魔了。