OpenAI发布Codex实战手册,GPT5.1的持续工作极限为2小时17分钟(在新窗口打开)
2小时17分钟,这是截至2025年8月,前沿AI模型在保持50%成功率的前提下,能够维持连续推理工作的时长。这个数字意味着AI已经从处理“秒级”的代码片段,跨越到了处理“小时级”的复杂工程任务。
共 997 篇
2小时17分钟,这是截至2025年8月,前沿AI模型在保持50%成功率的前提下,能够维持连续推理工作的时长。这个数字意味着AI已经从处理“秒级”的代码片段,跨越到了处理“小时级”的复杂工程任务。
TRAE国内版终于上线SOLO模式了,且全部功能完全免费!一口气带来了SOLO Coder、Plan模式、多任务并行等多个核心能力。
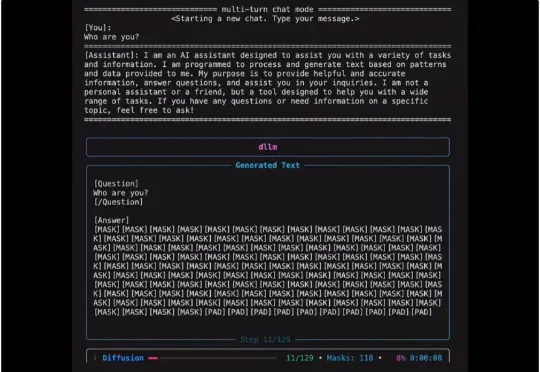
扩散式语言模型(Diffusion Language Model, DLM)虽近期受关注,但社区长期受限于(1)缺乏易用开发框架与(2)高昂训练成本,导致多数 DLM 难以在合理预算下复现,初学者也难以真正理解其训练与生成机制。
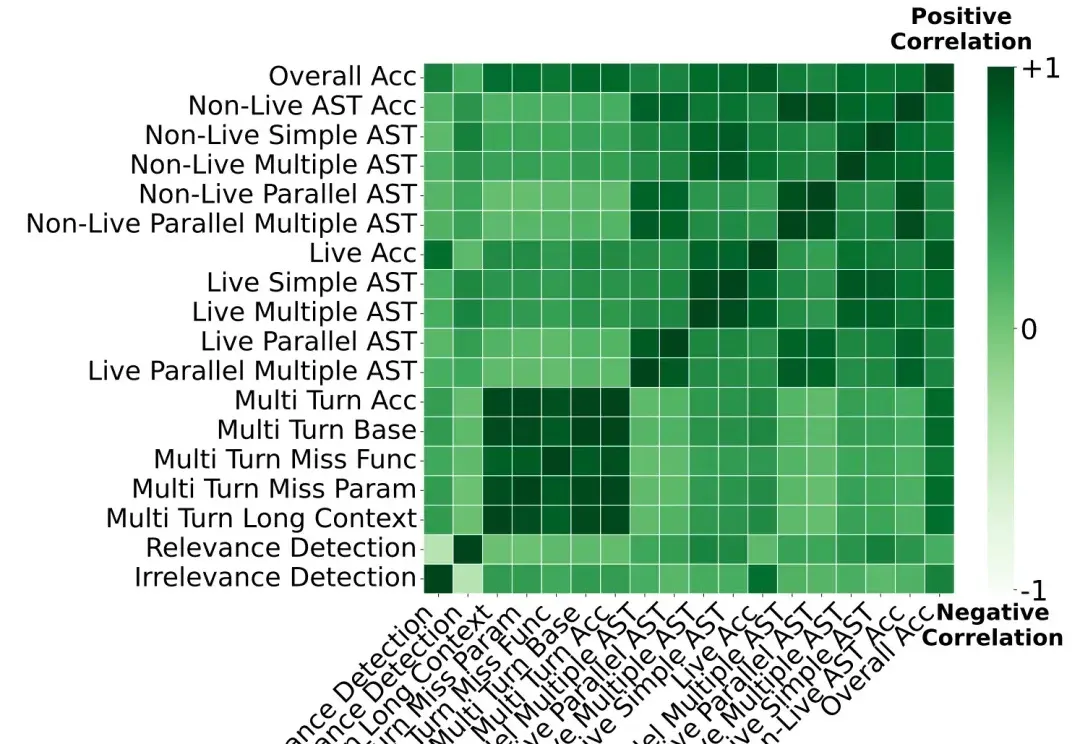
模型也要学会取长补短。 大语言模型(LLM)在众多领域展现出卓越的能力,但它们的训练依然高度依赖算力和时间,需要庞大的计算资源以及精细的训练流程设计。 模型 Souping(Model Souping) ,即对同一架构的多个模型进行权重平均,形成一个新的、更强的模型。相比训练一个庞大的统一模型,souping 更轻量、成本更低,同时能够融合模型的互补能力。 然而,传统的模型 souping 方式通常采用简单的均匀平均,即把所有候选模型的参数直接做等权融合。 本文中,来自 Meta、伦敦大学学院机构的研究者提出类专家 Soup(Soup Of Category Experts, SoCE),这是
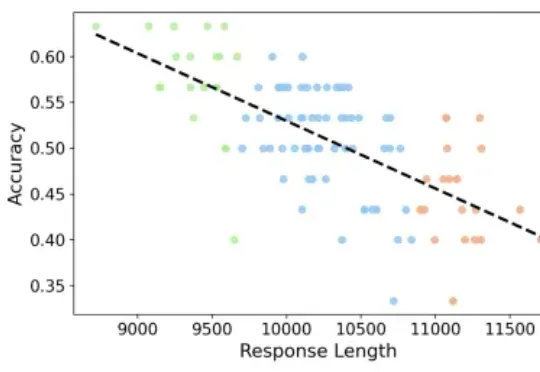
专注推理任务的 Large Reasoning Models 在数学基准上不断取得突破,但也带来了一个重要问题:越想越长、越长越错。本文解读由 JHU、UNC Charlotte 等机构团队的最新工作
近日,一家名为 CraftStory 的 AI 初创公司推出了 Model 2.0 视频生成系统,凭借可生成长达五分钟的富有表现力、可媲美专业水准、以人为中心的视频,破解了困扰 AI 视频生成行业长久以来的「视频时长」难题,引起热议,并被视为或将是 OpenAI 的 Sora 和 Google 的 Veo 的强有力竞争者。
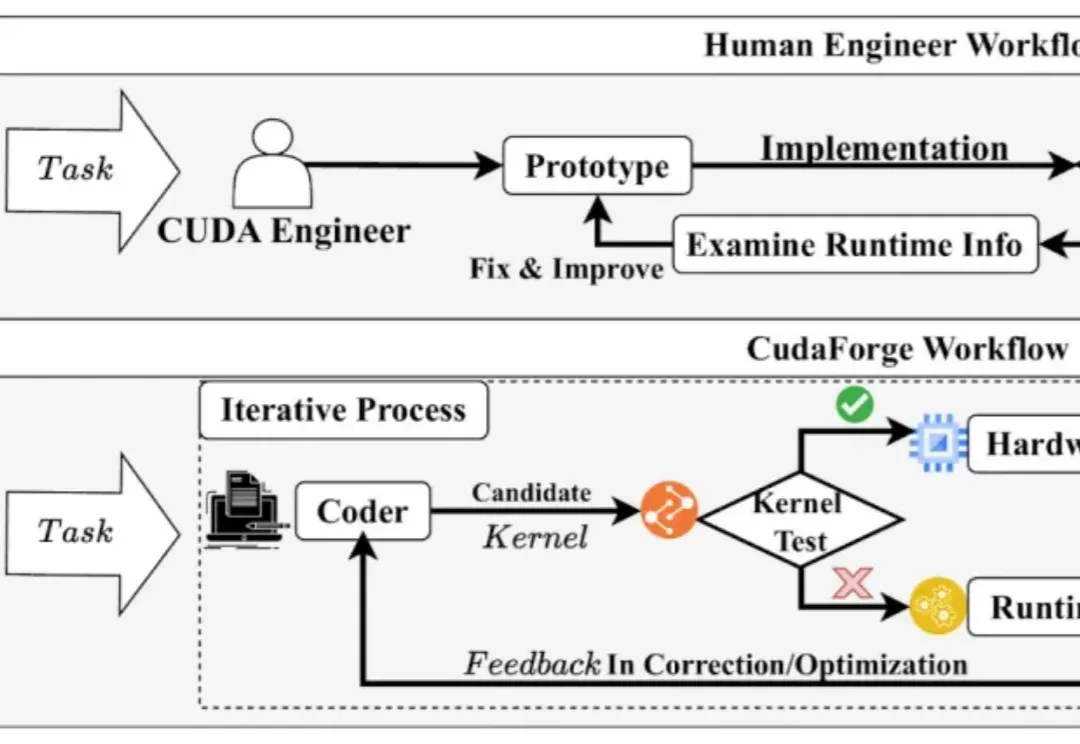
CUDA 代码的性能对于当今的模型训练与推理至关重要,然而手动编写优化 CUDA Kernel 需要很高的知识门槛和时间成本。与此同时,近年来 LLM 在 Code 领域获得了诸多成功。
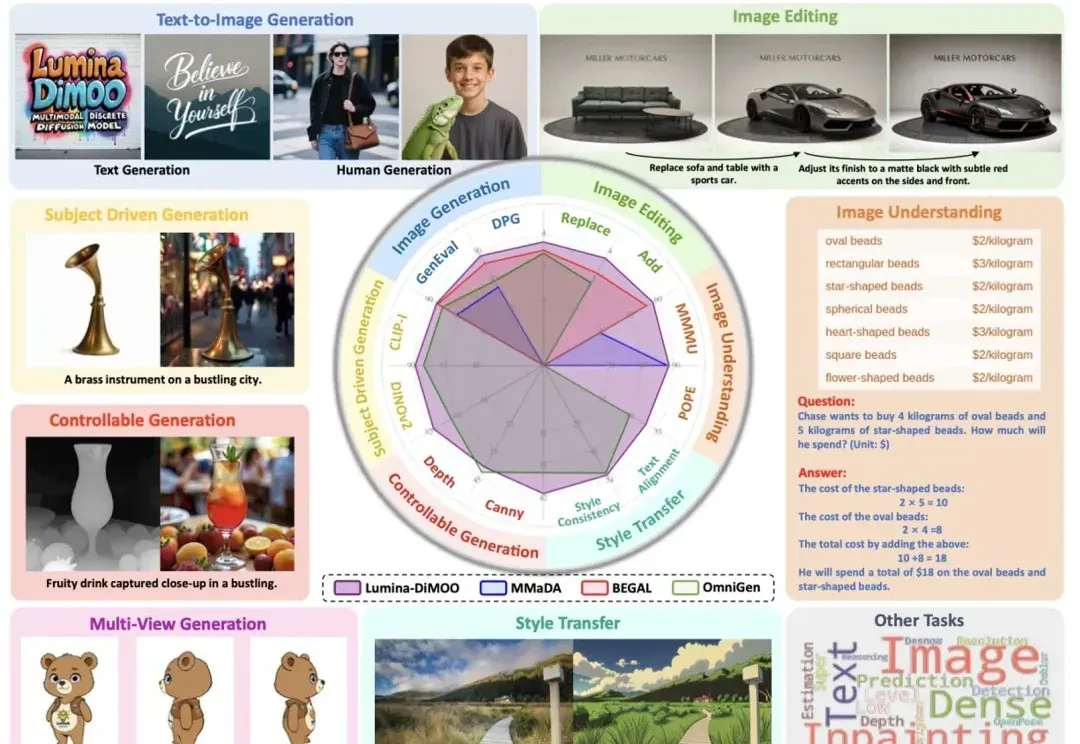
上海人工智能实验室推出了一款革新的多模态生成理解一体化的扩散语言模型 ——Lumina-DiMOO。基于离散扩散建模(Discrete Diffusion Modeling),Lumina-DiMOO 打破了多模态任务之间的壁垒,在同一离散扩散框架下,完成从 文本→图像、图像→图像、图像→文本的全栈能力闭环。
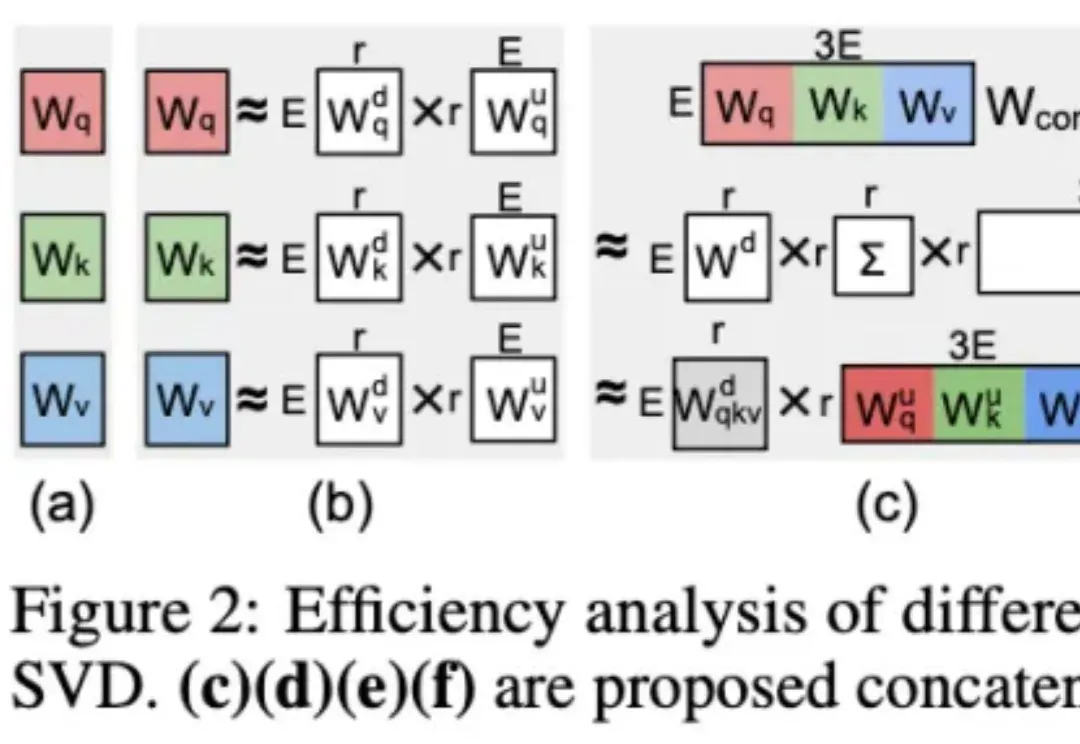
在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。
Transformer的火种已燃烧七年。如今,推理模型(Reasoning Models)正点燃第二轮革命。Transformer共同作者、OpenAI研究员Łukasz Kaiser预判:未来一两年,AI会极速跃升——瓶颈不在算法,而在GPU与能源。