哈佛Science重磅:AI急诊诊断准确率67%,超越资深主治!取代医生尚早(在新窗口打开)
哈佛研究登上Science:在76名真实急诊患者的双盲对决中,OpenAI o1诊断准确率67%碾压人类医生的50%,治疗方案得分89%对34%更是断崖式领先——但AI还看不见患者的脸色和痛苦,真正的变革不是「AI赢了」,而是急诊室正在走向「医生×患者×AI」三方共治的新范式。
共 1333 篇
哈佛研究登上Science:在76名真实急诊患者的双盲对决中,OpenAI o1诊断准确率67%碾压人类医生的50%,治疗方案得分89%对34%更是断崖式领先——但AI还看不见患者的脸色和痛苦,真正的变革不是「AI赢了」,而是急诊室正在走向「医生×患者×AI」三方共治的新范式。
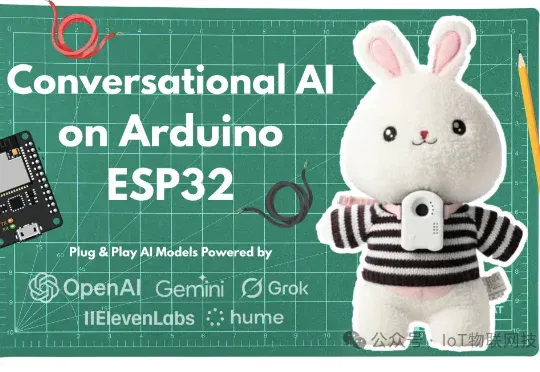
ElatoAI 是一个开源免费的实时AI语音交互系统,采用Arduino 编程,运行在乐鑫 ESP32 主控制器上,通过安全WebSocket连接至部署在Deno边缘函数构建的服务端,通过OpenAI Realtime API等技术实现低成本、长时长、跨设备的自然对话体验,支持多种AI模型,
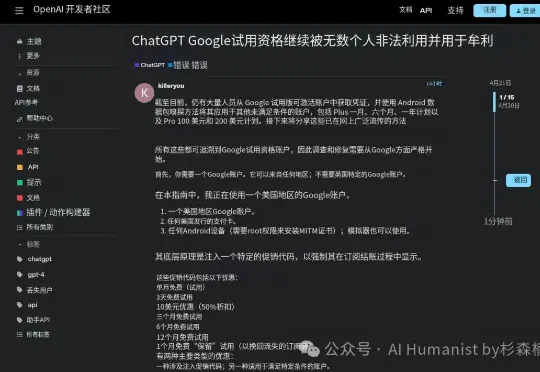
2026 年 4 月 21 日凌晨,OpenAI 开发者社区论坛上出现了一条帖子,Token 经济,人类史上「第一个叛徒」由此出现了:发帖的人叫 Killeryou。如果你混过中文技术社区,应该对这个名字不陌生。他过去两年一直活跃在 AI 工具的薅羊毛前线,属于那种既会写爬虫也会开店的角色。
相信大家都能感觉到,进入2月以来,“上下文工程”、“Vibe Coding”的热度已经让位给了一个新名词:"harness engineering"。
就在上周,OpenAI 的一名工程师创下了一个离谱的纪录:他在七天内消耗了 2100 亿个 Token。
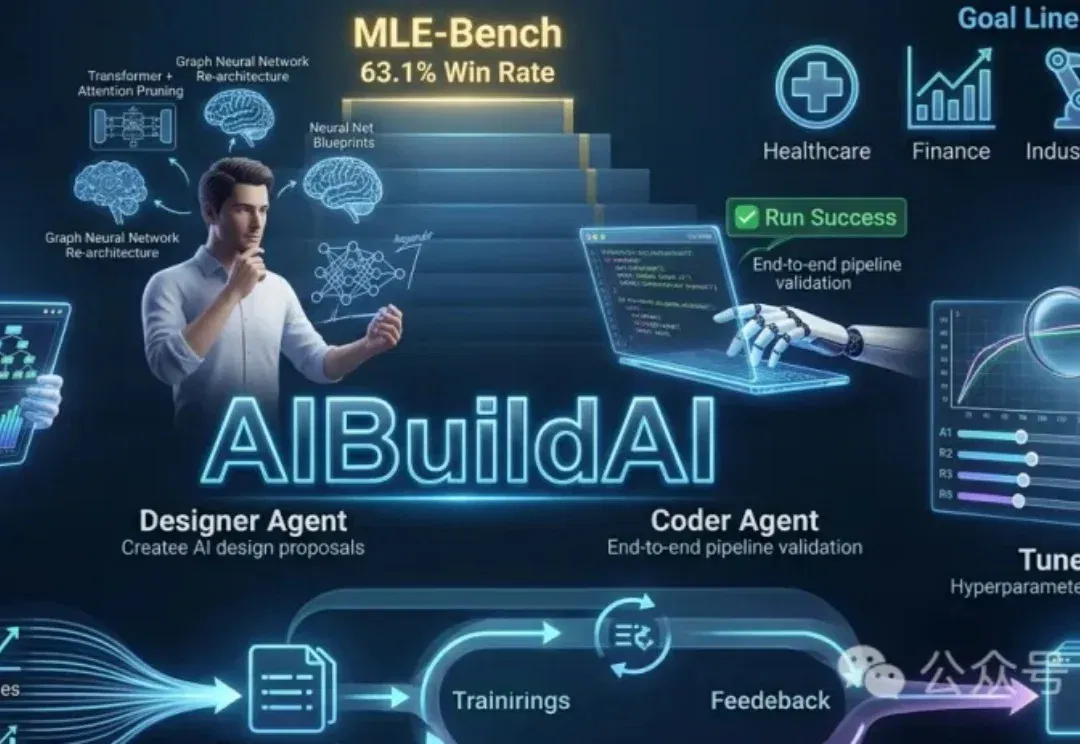
UCSD团队推出AIBuildAI智能体,无需编程,仅用自然语言描述任务,即可自动设计、编码、训练、调参并优化AI模型,分工协作,端到端完成AI开发。在OpenAI MLE-Bench测试中,AIBuildAI以63.1%的获奖率位居第一,性能媲美人类专家,推动AI开发迈向全自动化新时代。
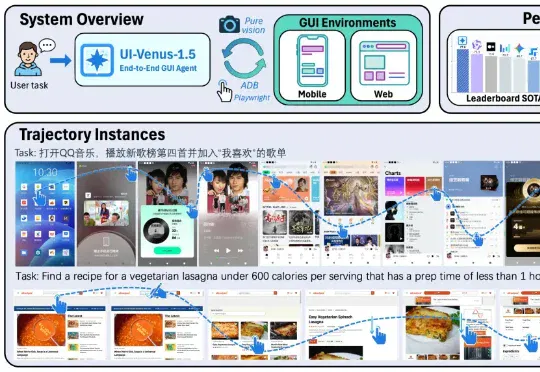
GUI 智能体最近卷到什么程度了?Claude、OpenAI Agent 及各类开源模型你方唱罢我登场,但若真想让 AI 成为 「能在手机和网页上稳定干活的助手」,仍绕不开三大现实难题:
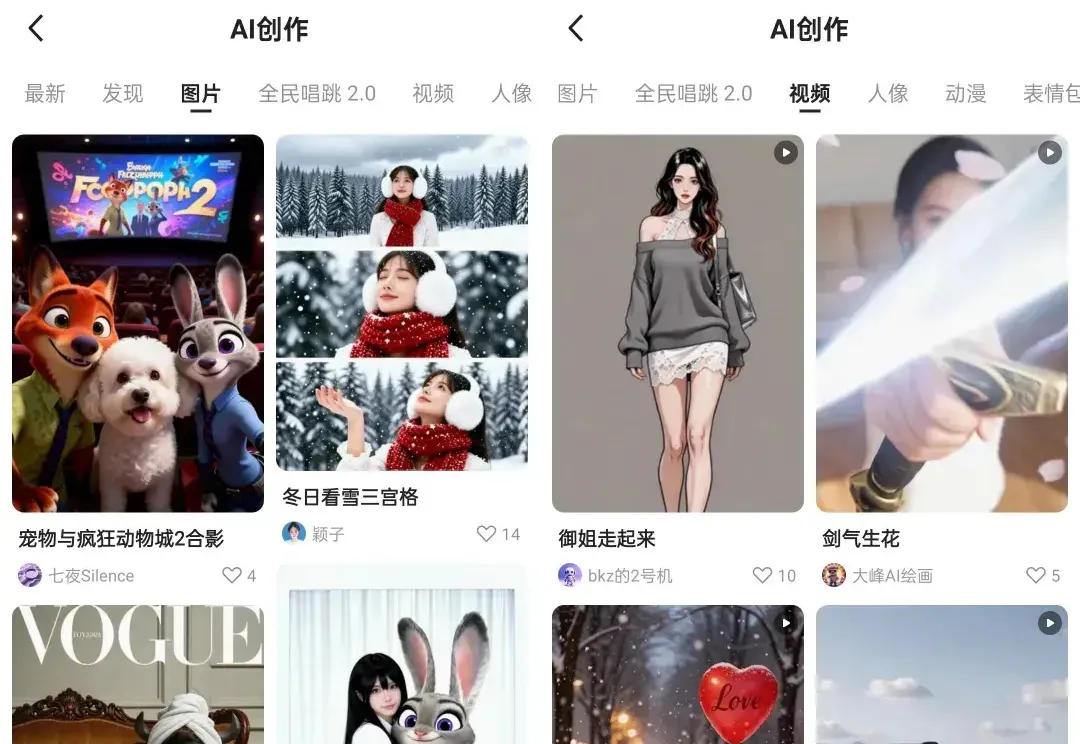
千问 App,大家都用上了吧? 这个被阿里委以重任的 AI 应用,今天迎来了一波史诗级更新:正式接入了阿里最强的两大视觉模型 —— Qwen-Image 和 Wan 2.5。 在 Hugging Face 等开源社区,Qwen-Image 系列模型长期霸榜,被全球开发者玩出了花;而 Wan 2.5 则是业内少有、具备「原生音画同步」能力的视频生成新贵。 但过去,想用上这些 SOTA 模型,你得会跑代码、部署 ComfyUI,或者苦等海外大厂的内测资格。 今天,门槛消失了。 千问 App 将这两大顶流模型深度整合,让普通用户在手机上也能拥有一座「掌上影像工作室」。 我们第一时间实测了这项更新,结
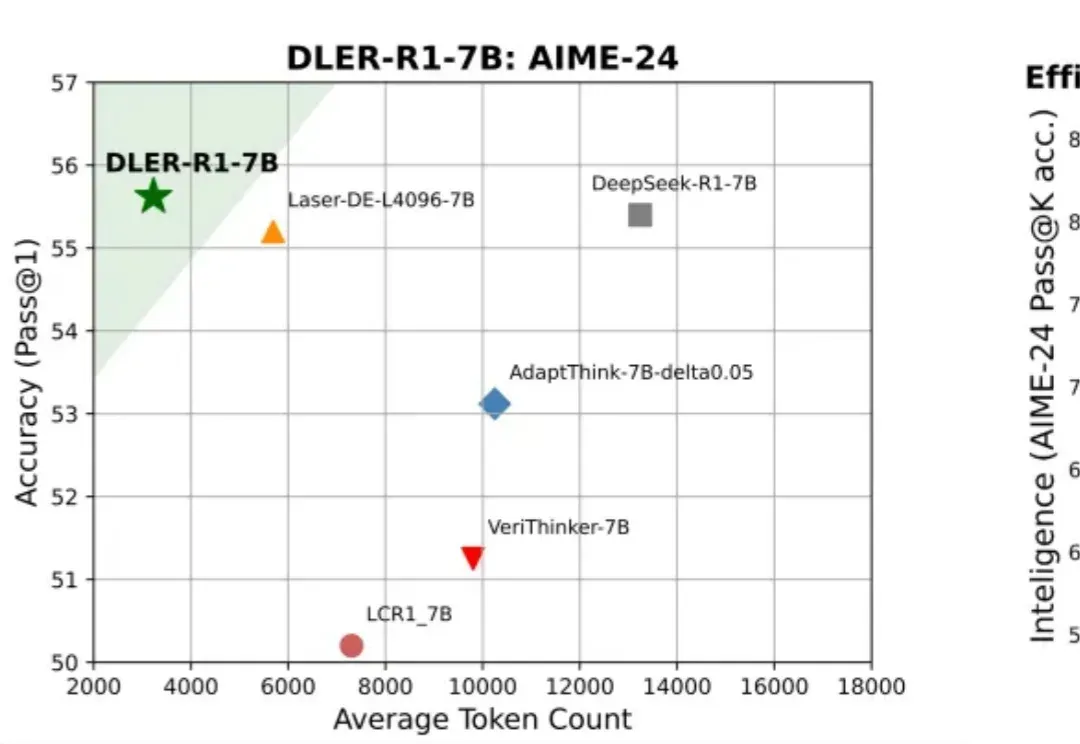
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
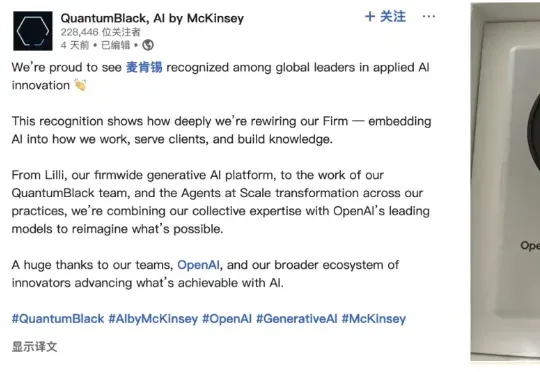
魔幻啊魔幻。 全球顶级咨询公司麦肯锡,居然收到了OpenAI最近给Tokens消耗大客户颁发的奖牌。 麦肯锡自己还怪自豪的,第一时间就把奖牌po到了领英上。