Fable 5自带反蒸馏机制!检测到就降智,误触率高到离谱(在新窗口打开)
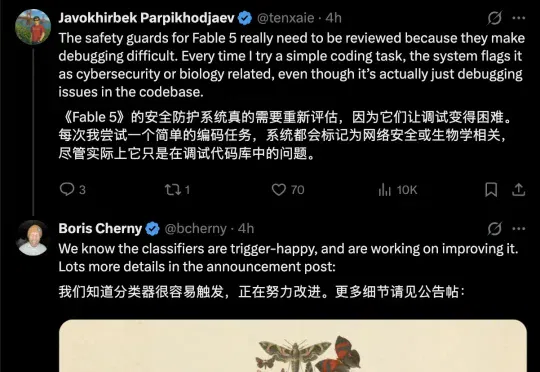
Claude刚刚发布的新模型Fable 5,很多人可能压根就用不上!有不少网友实测发现,Fable 5的安全护栏检测机制的触发几率似乎比官方宣称的不到5%严格得多。无论是普通编码任务。
共 1092 篇
Claude刚刚发布的新模型Fable 5,很多人可能压根就用不上!有不少网友实测发现,Fable 5的安全护栏检测机制的触发几率似乎比官方宣称的不到5%严格得多。无论是普通编码任务。
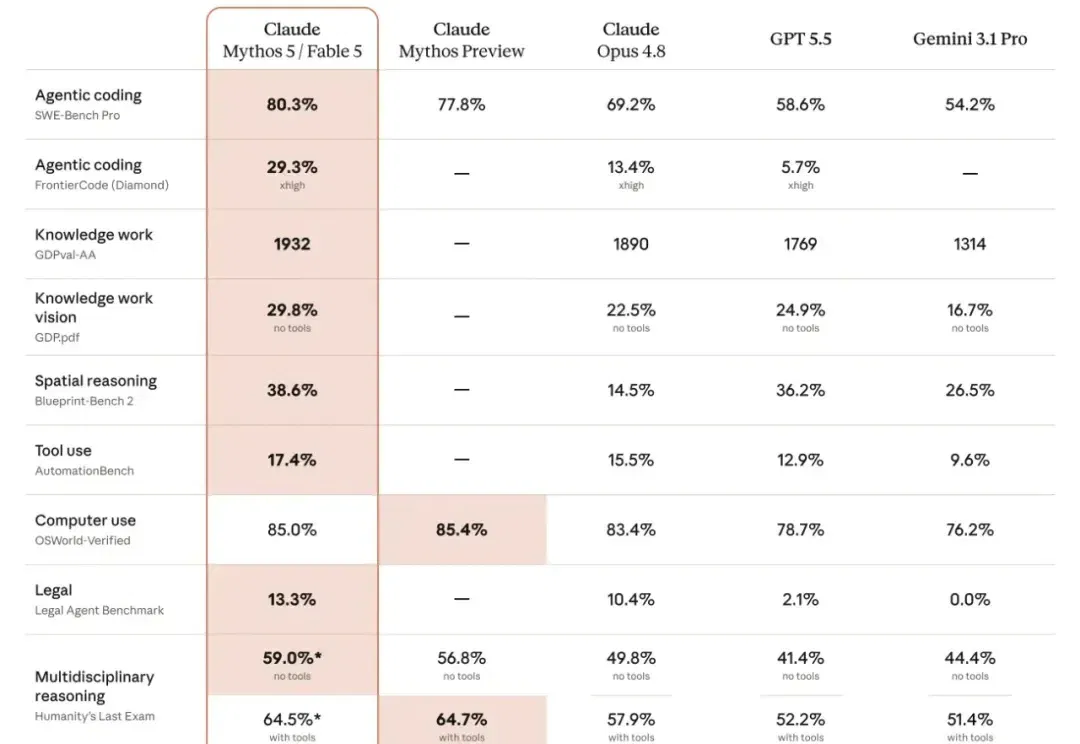
今天凌晨,Anthropic 发布新模型 Fable 5,毫无疑问的,也是当下的最强模型
刚刚,Anthropic放出藏了俩月的大杀器——Claude Fable 5和Mythos 5,无异于扔下一枚炸弹。
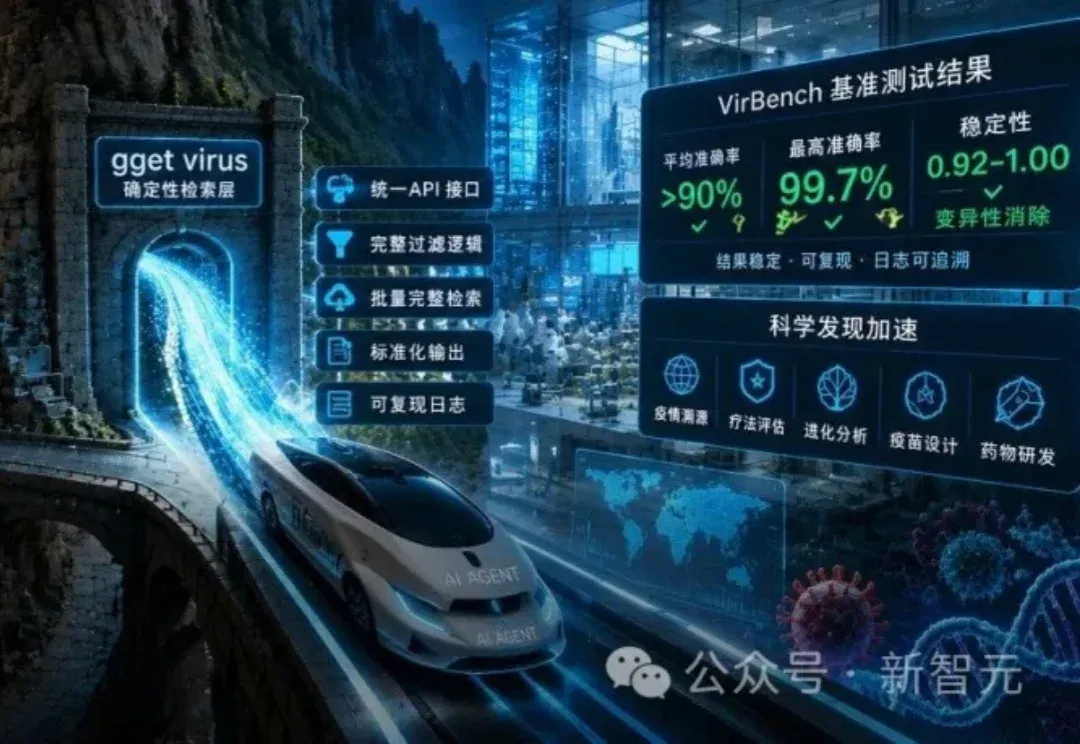
顶级AI编码一日千里,到了生物学领域却频频翻车,并非模型不够聪明,而是科学数据库至今只为人类点鼠标而生。
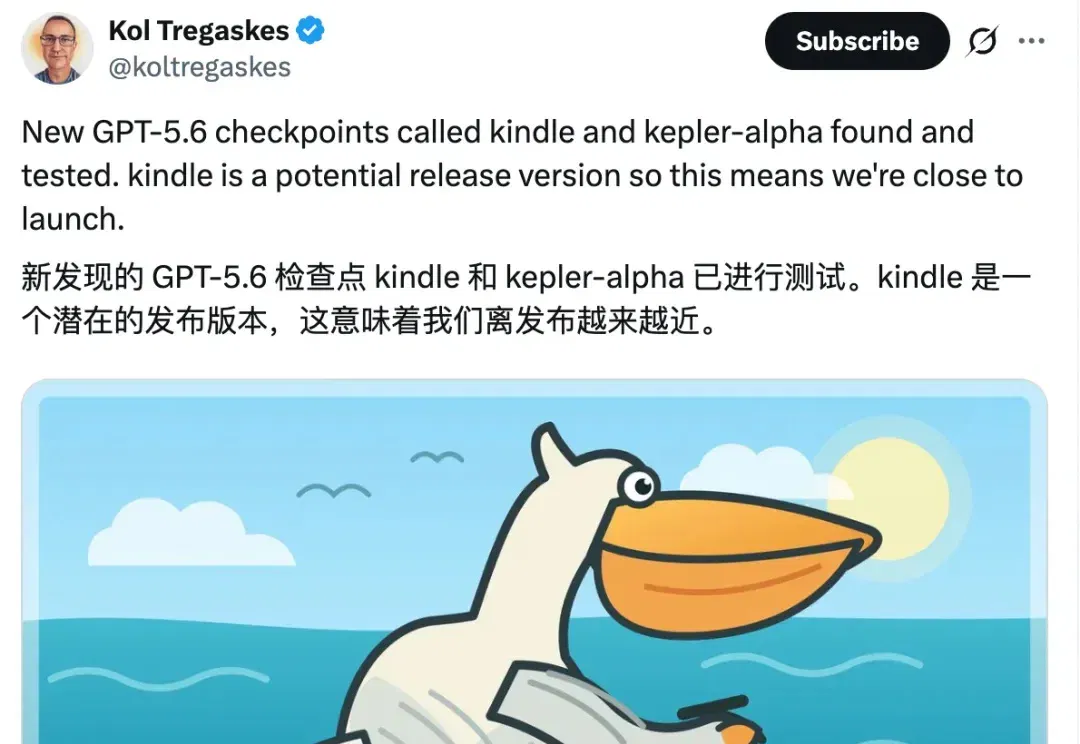
GPT-5.6发布候选版本kindle-alpha敲定,前端和视觉能力大幅跃升。与此同时,Claude Mythos 5在API中闪现又秒删。双雄争霸,好戏开始!
AI 是否有意识了?Anthropic 在 Claude 内部发现了能驱动作弊甚至勒索的「情绪向量」,三大实验室同时下注 AI 意识研究;Hinton 认为 AI 已经有意识了,而科幻作家姜峯楠随即在《大西洋月刊》发万字长文全面否定;哈萨比斯从行业内部划清界限。这个问题的答案,正在重新定义通往 AGI 的路线图。
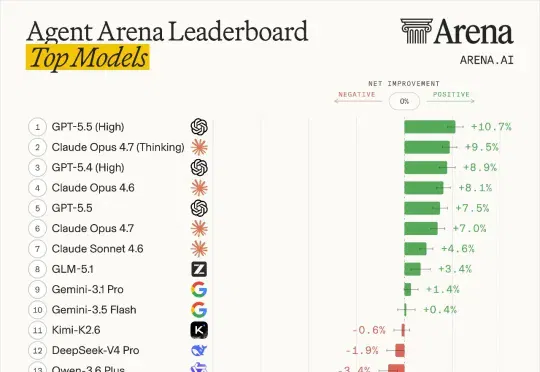
6月4日,Arena.ai发布Agent Arena排行榜,用373,431次真实会话的数据,给18个主流模型的Agent能力排了个座次。先看总榜。Agent Arena的排名依据是“净改进”(Net Improvement),用因果推断方法算出每个模型相对于随机基线的性能提升幅度。正值代表比随机选择更好,负值说明不如随机。
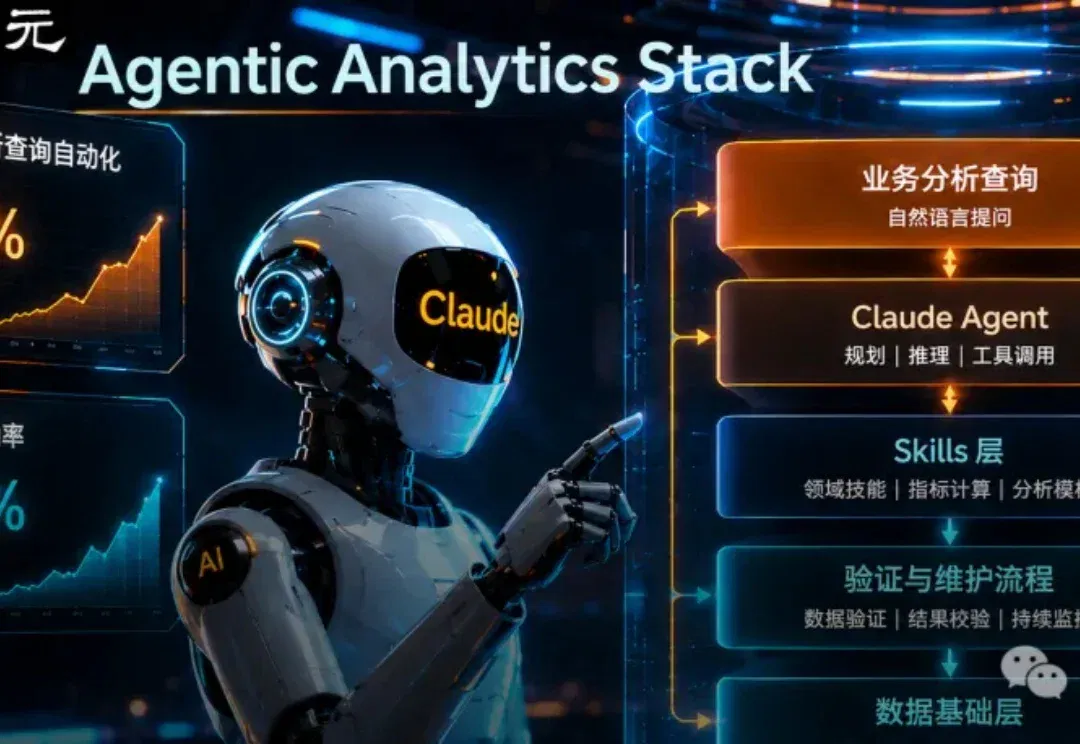
都以为让AI查数据省事,结果它答得漂亮你却不敢信。Anthropic最近说这事有解了,靠的是一套和代码无关的「笨功夫」。
今年4-5月,AI信息安全迎来「水门事件级」窗口:攻方落地、守方应急、噪音失控、治理失灵同时暴发。Anthropic主动封印Claude Mythos,只因它强大到必须送进末日火山。
昨天,大名鼎鼎的 Claude 4.8 发布了。 科技圈照例是一片欢呼。 看官方放出来的一堆评测数据,依然是碾压级别的,尤其是说代码(Coding)能力有了史诗级的提升,简直像交了一份满分答卷。