比 Gemini 更严谨,比 GPT 更靠谱:谷歌这个隐藏功能,太强了!(在新窗口打开)
今天,我想以一个 AI 实战派的身份,再次向大家推荐我目前心中“信息核查”的 No.1 工具——Google 搜索 AI 模式(Google Search AI Mode)。为什么是它?Gemini / ChatGPT 们做不到吗?
共 997 篇
今天,我想以一个 AI 实战派的身份,再次向大家推荐我目前心中“信息核查”的 No.1 工具——Google 搜索 AI 模式(Google Search AI Mode)。为什么是它?Gemini / ChatGPT 们做不到吗?
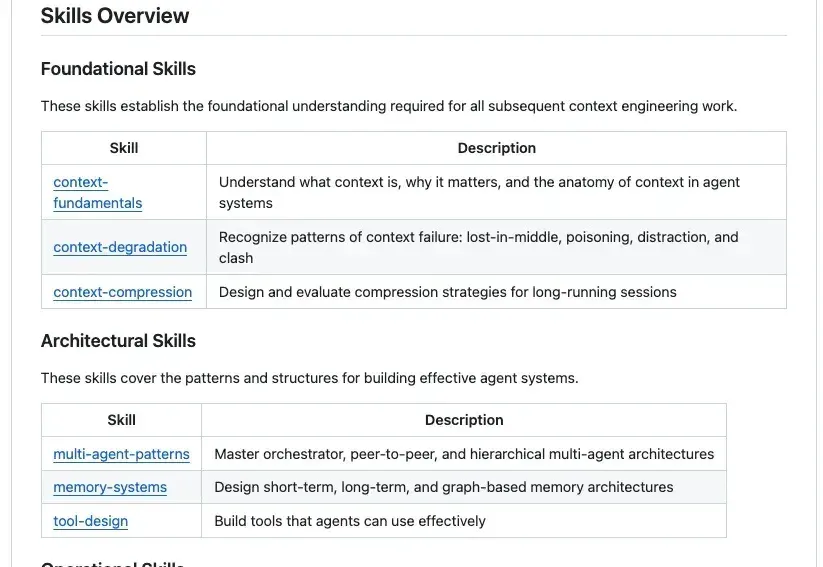
GitHub上最近出现了一个非常火的项目Agent-Skills-for-Context-Engineering,发布不到一周就斩获了2.3k Stars。为什么它能瞬间引爆社区?因为站在2025年末的节点上,我们已经受够了那些只存在于大厂白皮书里的Context Engineering(上下文工程) 理论。
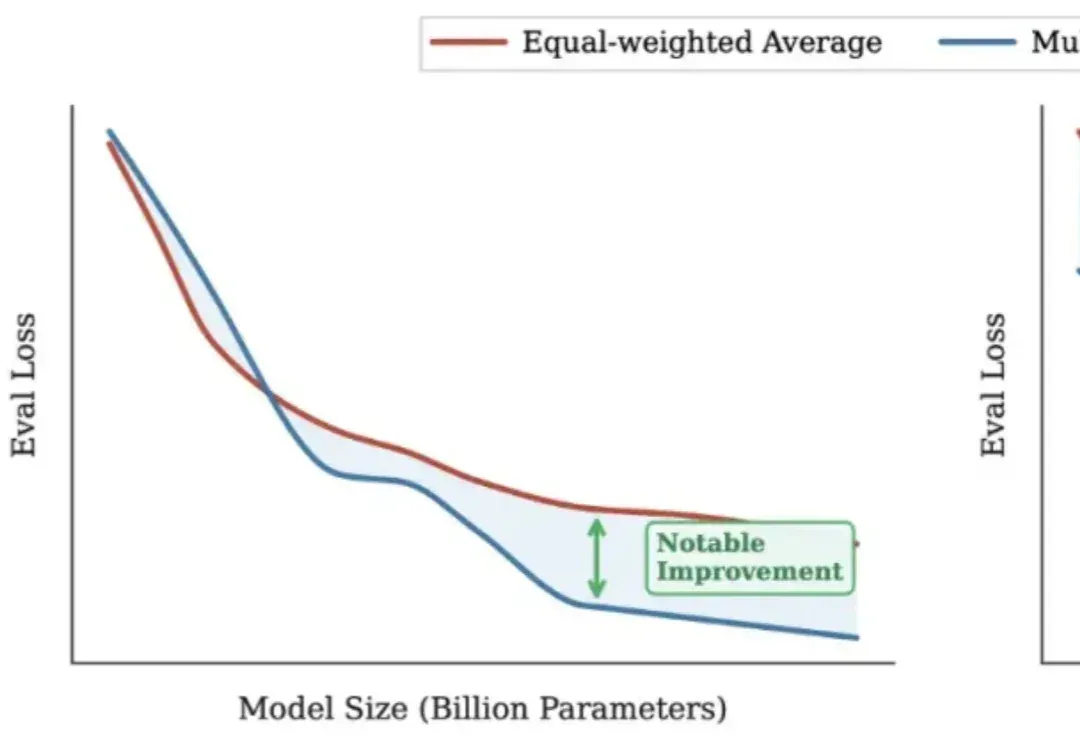
在代码大模型(Code LLMs)的预训练中,行业内长期存在一种惯性思维,即把所有编程语言的代码都视为同质化的文本数据,主要关注数据总量的堆叠。然而,现代软件开发本质上是多语言混合的,不同语言的语法特性、语料规模和应用场景差异巨大。
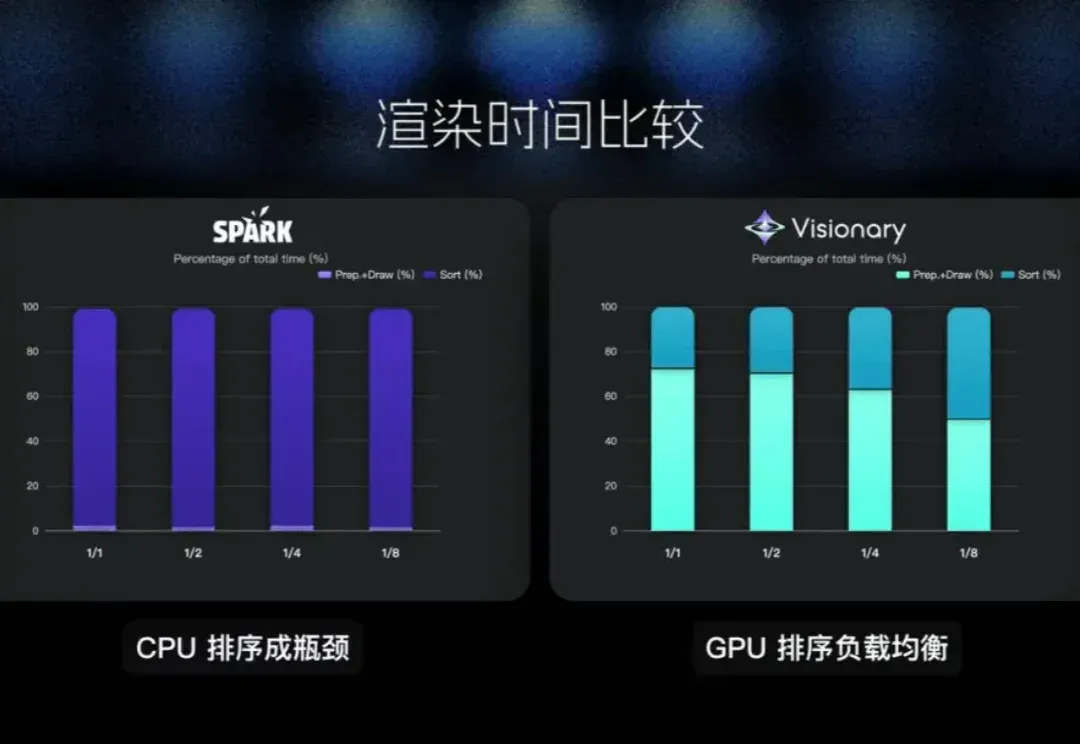
在李飞飞团队 WorldLabs 推出 Marble、引爆「世界模型(World Model)」热潮之后,一个现实问题逐渐浮出水面:世界模型的可视化与交互,依然严重受限于底层 Web 端渲染能力。
继 SAM(Segment Anything Model)、SAM 3D 后,Meta 又有了新动作。
AI竞技场开始清场。 就在刚刚,谷歌再次扣动扳机,正式推出了 Gemini 3 Flash。 这是继 Gemini 3 Pro 之后的又一次暴力输出。没有预告,没有任何铺垫,谷歌直接宣布 Gemini 3 Flash 现已成为 Gemini 应用中的默认模型,全面取代 2.5 Flash。这意味着,全球数亿用户无需支付任何费用,就能立刻体验到 Gemini 3 系列模型的推理能力。 如果说 Gemini 3 Pro 是为了尽情发挥 AI 算力的优势,那 Gemini 3 Flash 则打破了「高智」、「低成本」与「响应快」之间的不可能三角。 打开 Model Card,我们看到一组令人惊讶的数
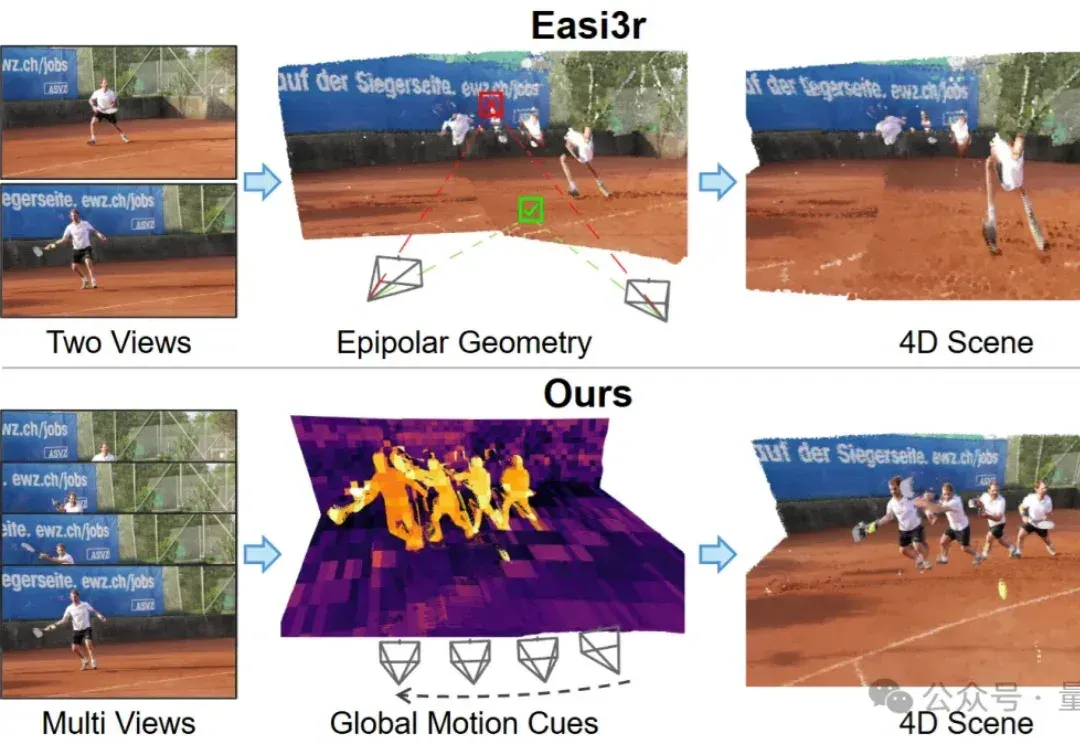
如何让针对静态场景训练的3D基础模型(3D Foundation Models),在不增加训练成本的前提下,具备处理动态4D场景的能力?
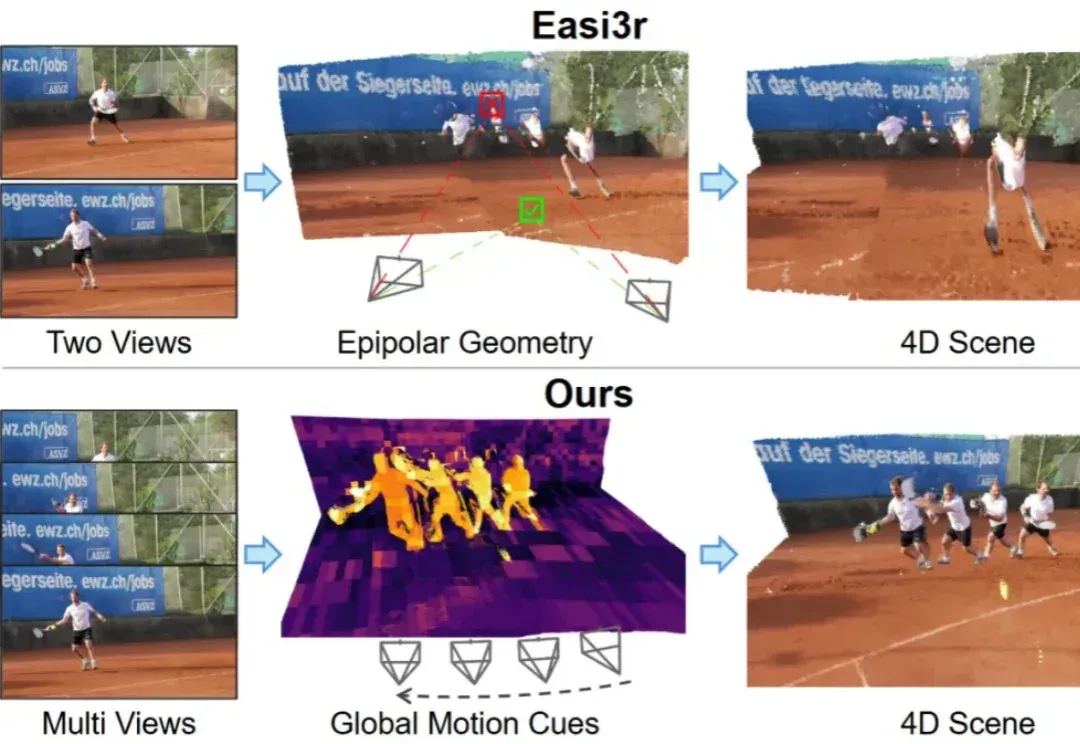
如何让针对静态场景训练的 3D 基础模型(3D Foundation Models)在不增加训练成本的前提下,具备处理动态 4D 场景的能力?
从 0 到上线,在OpenAI内部,安卓版 Sora经历的时间只有 28 天,而且期间只用了 2-3 名员工。
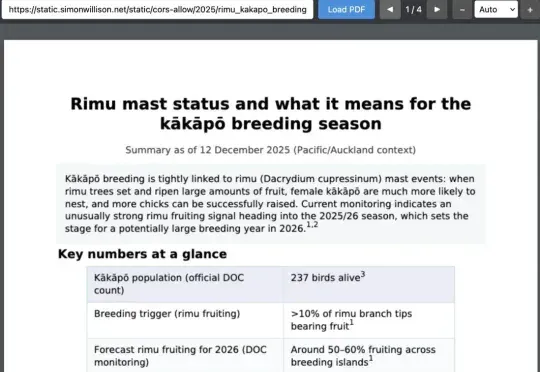
还在争论Skills是不是prompt?已经可以停下火了。因为,刚刚得到的消息消息,OpenAI已经悄悄地用上了Skills了。今天,知名博主、Django Web 框架联合创始人Simon Willson爆料: