Qwen又立功,全球最快开源模型诞生,超2000 tokens/秒!(在新窗口打开)
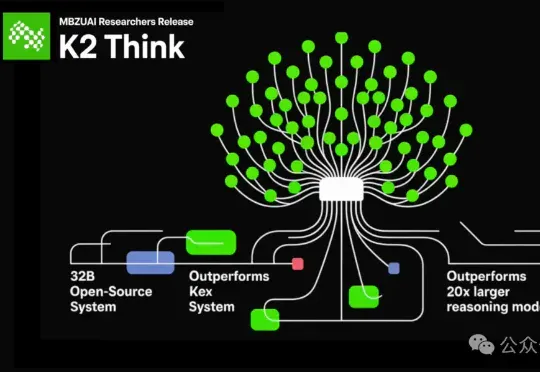
全球最快的开源大模型来了——速度达到了每秒2000个tokens! 虽然只有320亿参数(32B),吞吐量却是超过典型GPU部署的10倍以上的那种。它就是由阿联酋的穆罕默德·本·扎耶德人工智能大学(MBZUAI)和初创公司G42 AI合作推出的K2 Think。
共 1519 篇
全球最快的开源大模型来了——速度达到了每秒2000个tokens! 虽然只有320亿参数(32B),吞吐量却是超过典型GPU部署的10倍以上的那种。它就是由阿联酋的穆罕默德·本·扎耶德人工智能大学(MBZUAI)和初创公司G42 AI合作推出的K2 Think。
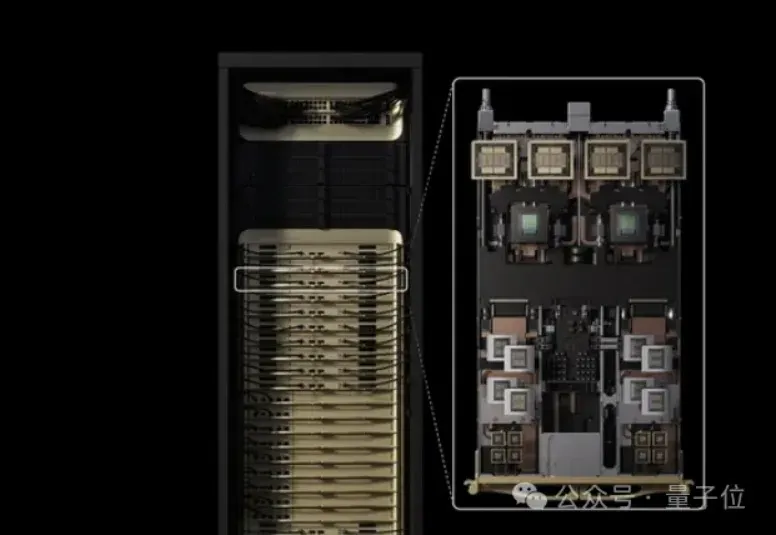
老黄对token密集型任务下手了。 刚刚,在AI Infra Summit上,英伟达宣布推出专为处理百万token级别的代码生成和生成式视频应用的全新GPU—— NVIDIA Rubin CPX GPU。 老黄表示:Rubin CPX是首款为超大上下文AI量身定制的CUDA GPU,可以让模型“一口气”推理数百万token。 而且,RubinCPX还能让你越用越省钱:每投资1亿美元,就能获得50亿美元的token收益。(50倍,你就赚吧,老黄说的) 对于“老黄画的饼”,Cursor、Runway、Magic等行业大佬也表示RubinCPX将分别在代码生产力、生成式影像创作、以及大模型自主代理上
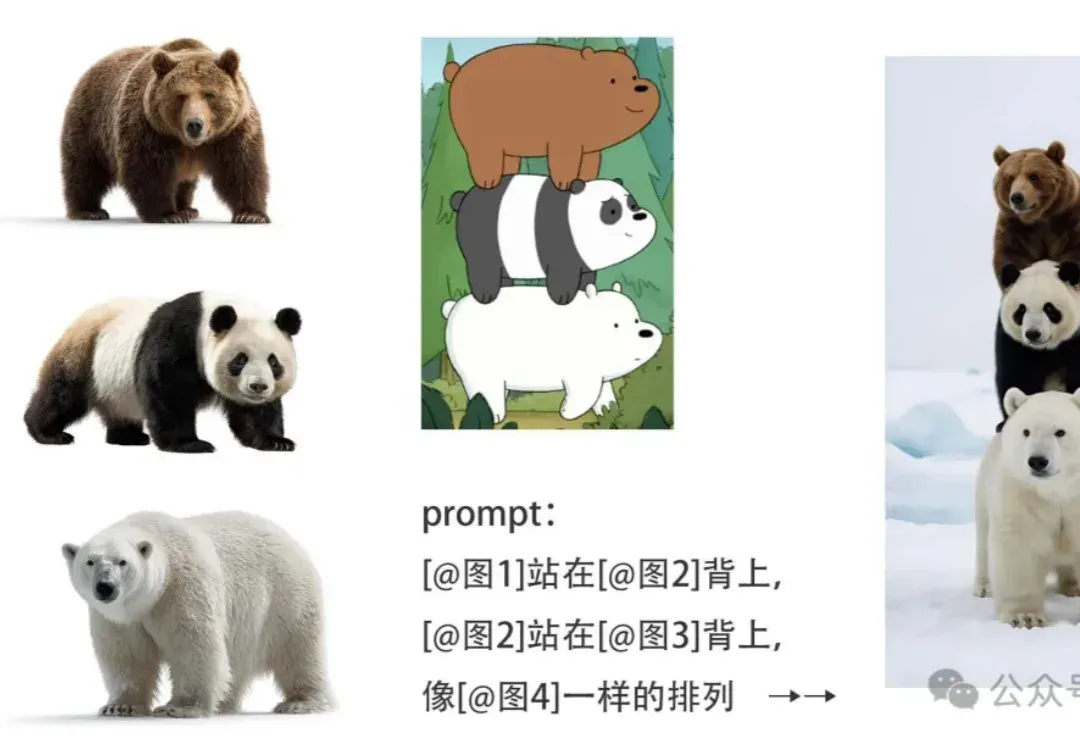
最近AI生图赛道简直卷疯了! 从Nano Banana的爆火,到即梦AI 4.0,豆包4.0接连上线,一直专注于视频大模型的Vidu也按捺不住了: Vidu Q1参考生图堂堂登场!同时支持7张参考。 主体一致性比起谷歌Nano Banana也毫不逊色。 (Nano Banana最多支持3张参考图) 量子位抢先实测了这款模型,它的表现相当不错——能够自由引用的7张参考图,带来了极高的可操作性。 用简单的自然语言描述即可。 或者是直接生成时尚大片,现场拍摄啥的都省了。 我们探索了很多有趣的玩法,提示词、图片都放在下面了,一起来看一下! 7张参考图,能怎么玩? 我们实测了几种玩法,比如让各种违和的元
过去几年,大语言模型(LLM)的训练大多依赖于基于人类或数据偏好的强化学习(Preference-based Reinforcement Fine-tuning, PBRFT):输入提示、输出文本、获得一个偏好分数。这一范式催生了 GPT-4、Llama-3 等成功的早期大模型,但局限也日益明显:缺乏长期规划、环境交互与持续学习能力。
继π0后,具身智能基座模型在中国也终于迎来了真正的开源—— 刚刚,WALL-OSS宣布正式开源!在多项指标中,它还超越了π0。如果你是搞具身的开发者,了解它的基本资料,你就一定不会想错过它:
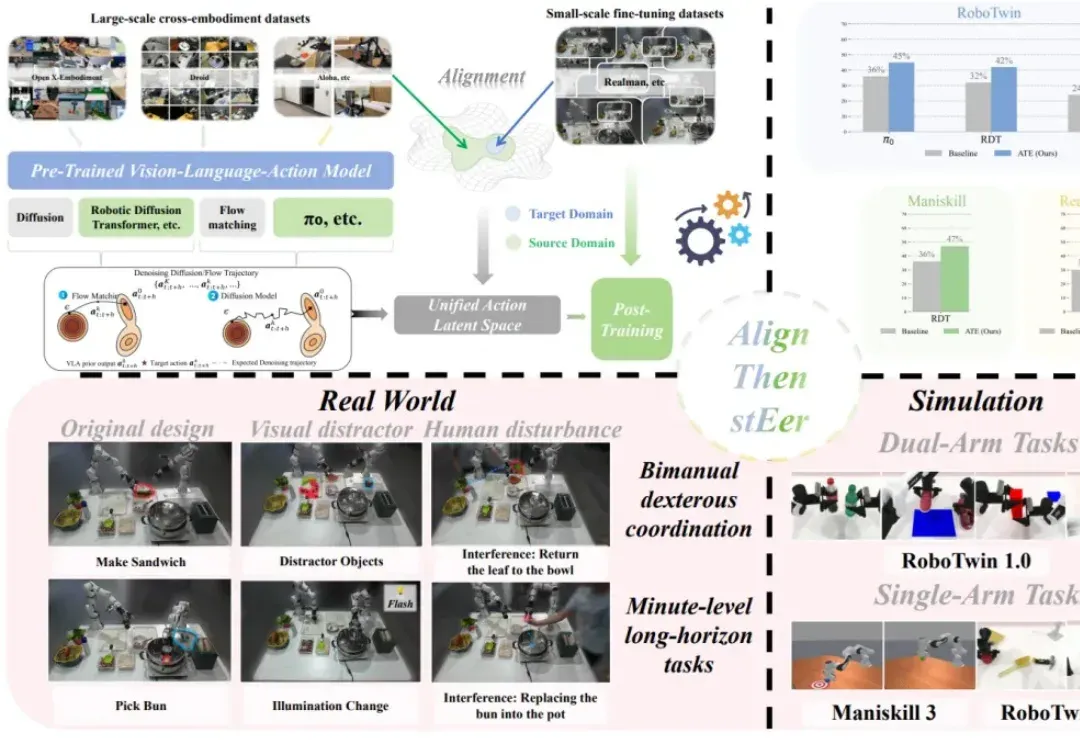
在多模态大模型的基座上,视觉 - 语言 - 动作(Visual-Language-Action, VLA)模型使用大量机器人操作数据进行预训练,有望实现通用的具身操作能力。
为了降低大模型预训练成本,最近两年,出现了很多新的优化器,声称能相比较AdamW,将预训练加速1.4×到2×。但斯坦福的一项研究,指出不仅新优化器的加速低于宣称值,而且会随模型规模的增大而减弱,该研究证实了严格基准评测的必要性。

机器人终于不用散装大脑了! 字节Seed一个模型就能搞定机器人推理、任务规划和自然语言交互。
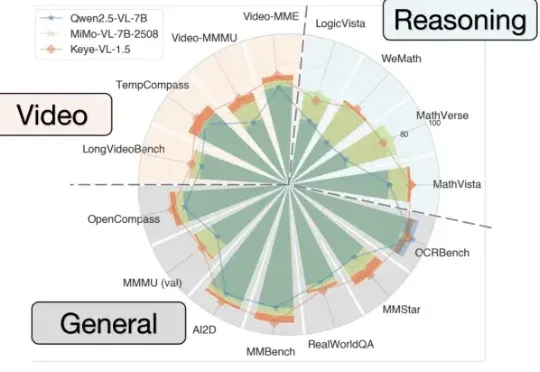
能看懂视频并进行跨模态推理的大模型Keye-VL 1.5,快手开源了。
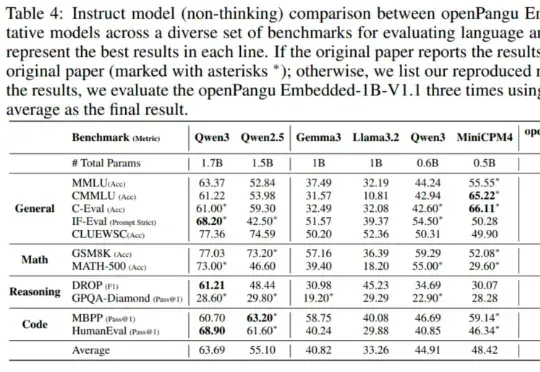
在端侧 AI 这个热门赛道,华为盘古大模型扔下了一颗 “重磅炸弹” 。