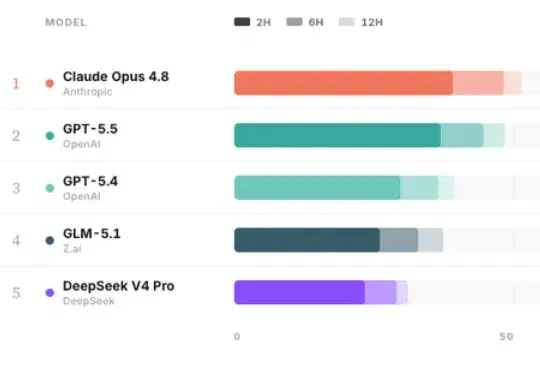
3.8万小时、狂烧天价token:字节发现Agent的 Scaling Law(在新窗口打开)
7月2日,字节 Seed 发布了一个 Agent评测项目 EdgeBench。看起来又是一个 benchmark,但它问了一个其他榜单不问的问题。EdgeBench 的切口就是把盲区里的东西放进评测,解答一个问题:把Agent扔进一个陌生环境,12小时后,你能变强多少?
共 163 篇
7月2日,字节 Seed 发布了一个 Agent评测项目 EdgeBench。看起来又是一个 benchmark,但它问了一个其他榜单不问的问题。EdgeBench 的切口就是把盲区里的东西放进评测,解答一个问题:把Agent扔进一个陌生环境,12小时后,你能变强多少?
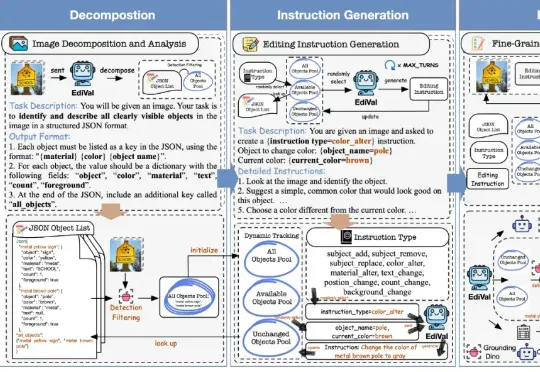
在 AIGC 的下一个阶段,图像编辑(Image Editing)正逐渐取代一次性生成,成为检验多模态模型理解、生成与推理能力的关键场景。我们该如何科学、公正地评测这些图像编辑模型?
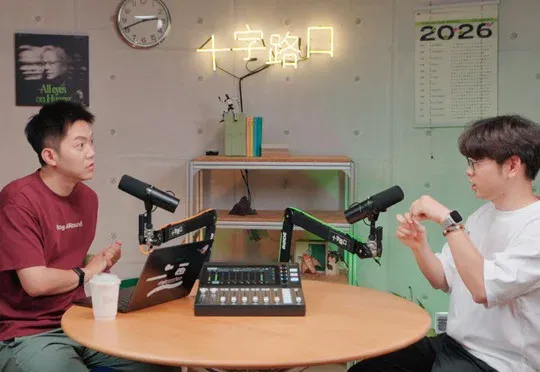
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
“这些人在往哪跑?为什么跑” “大模型浪潮狂飙三年半,国内AI人才也经历了三波大迁移。”资深科技猎头赵捷告诉雷峰网。 前两年,大家抢的是预训练人才,先是百度文心团队被疯抢,然后是AI六小虎人才遭遇瓜分,紧接着又是阿里、DeepSeek、字节、腾讯之间的人才大混战。 而现在,大家又开始抢推理、Agent等后训练人才;最近一年不少预训练人才,如Qwen Code负责人惠彬原、混元大语言模型预训练负责人姚星丞、混元多模态理解预训练负责人彭厚文,字节Seed核心专家顾全全等陆续离职,要么创业,要么流向更纯粹的AI研究团队。 是什么促成了这一轮轮AI人才大迁徙?这背后又藏着哪些AI行业更深层的逻辑转变?
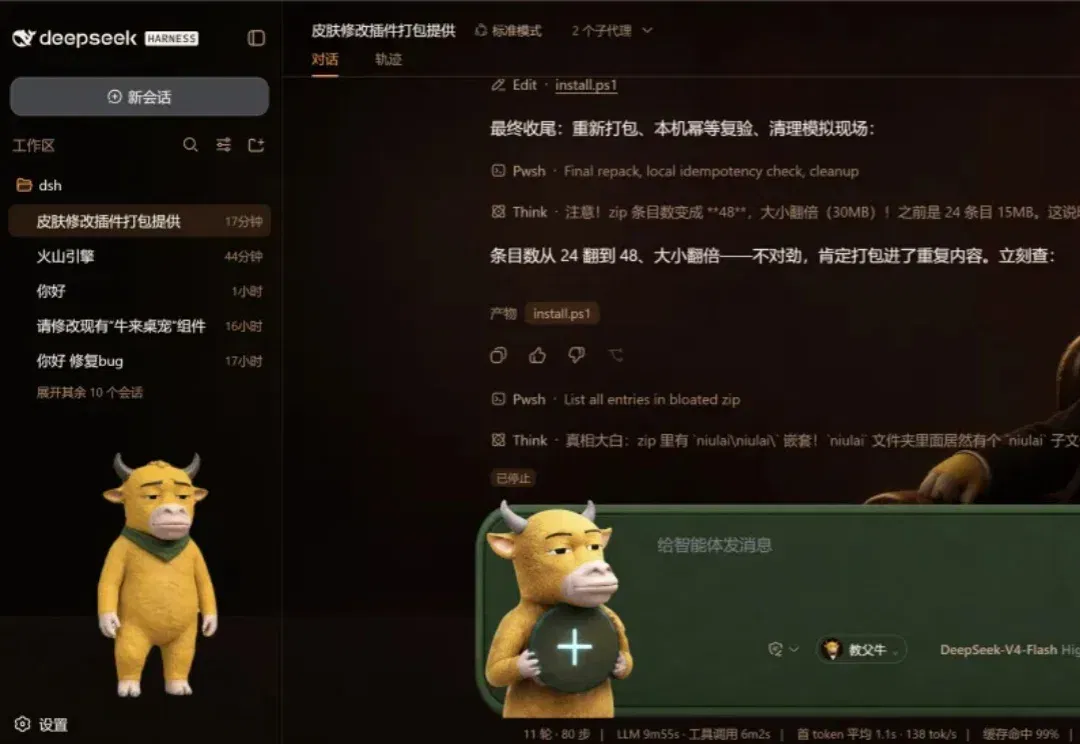
上两天肝的视频上了热搜 + 热门,使用插件,针对 ds 模型可以提升不小的性能。
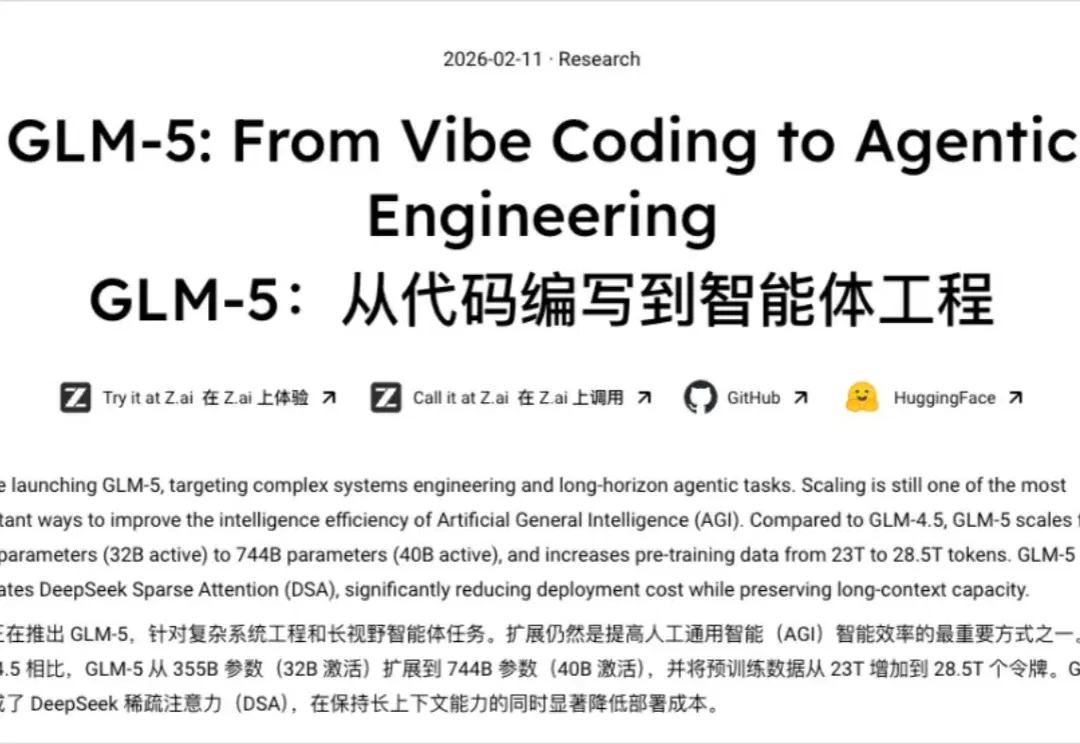
深夜,GLM-5来了。 还是老样子,发布即开源。 而且前几天,OpenRouter平台不是有一个Pony Alpha的匿名模型很火吗。 大家一度在猜是DeepSeek V4还是GLM-5,结果今天基本答案也揭晓了。 这大马,基本就是明示了。 到了今天,2026年的主旋律我觉得真的就已经就定下了,无论是国内还是海外。 Coding与视频齐飞,人类共AI一色。 这应该就是2026年AI领域最核心的两个主航道了,在这两之上,其实就是Agent。 这几天真的感觉过年一样,太热闹了,上周GPT-5.3 codex和Claude Opus 4.6中门对狙,后脚Seedance 2.0席卷全球,而现在,战场
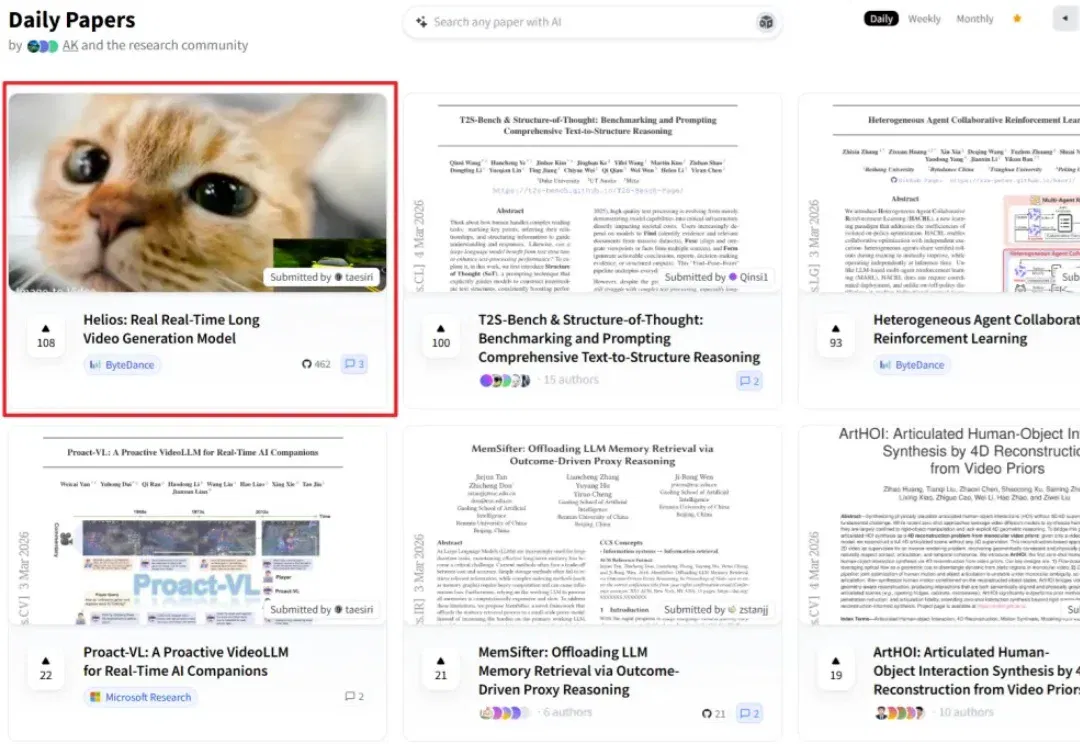
春节期间, Seedance 2.0 爆火,堪称现象级,这也再次把视频生成推上风口。前两天,字节跳动又携手北大、安努智能和 Canva 共同开源了具备实时生成能力的视频模型 Helios 家族。该系列包含了 Helios-Base、Helios-Mid 与 Helios-Distilled 三个版本,全面覆盖了 T2V、I2V、V2V 以及交互式生成任务。
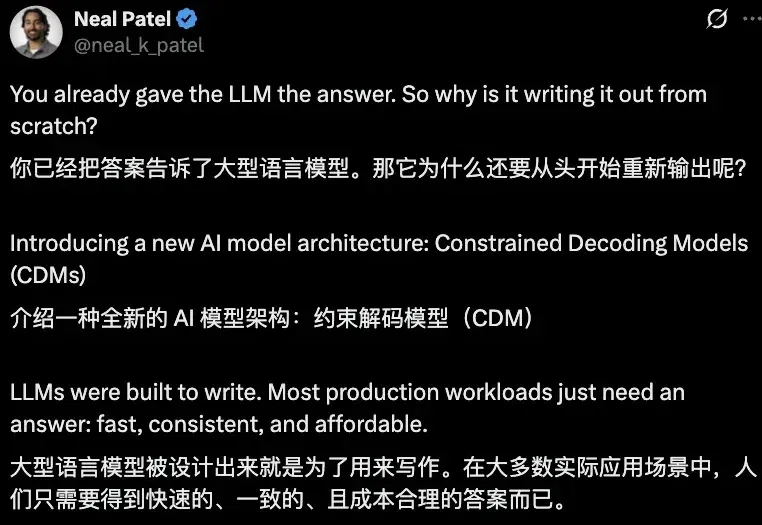
AI圈真是风水轮流转! Jev爆火之后,更多传统NLP技术翻红了。 而且吧,还真有人愿意掏钱。 专门做任务型小模型的创业公司Fastino,此前拿下1750万美元种子轮融资,加上此前的700万美元Pre-seed轮,累计融资约2450万美元。 领投方Khosla Ventures,还是OpenAI的早期投资方。 现在,ScaleDown也来凑热闹了,刚刚全新的CDM约束解码模型架构,一口气上线分类、实体提取、摘要三款模型。 NLP老三样直接组团复出。 相比前沿大模型API,其新模型最高快200倍、成本低467倍,还能处理100万Token的多模态输入。 每百万输入Token只要0.05美元,输
Runta 是 Agent Infra 领域的硅谷明星创业公司,刚完成由 a16z 投资的 2000 万美元 Seed 轮;Jeff Dean、李飞飞等也以个人天使身份参与投资。在创立 Runta 之前,冠兰在云计算与基础设施领域深耕十余年:曾任 Cloudflare Edge 边缘云核心技术负责人,后在作为早期核心成员加入 Kong ,担任工程总监,负责云原生网关和 AI 网关的研发。
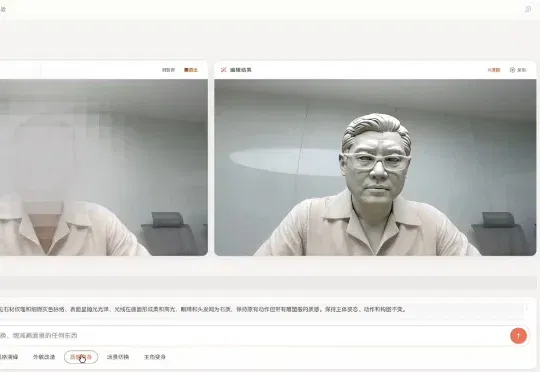
新智元报道 这个 8 月,AI 视频赛道的军备竞赛又升级了。 字节跳动发布 Seedance 2.5,把单次视频生成时长从 15 秒翻倍到 30 秒。同一天 MiniMax H3 开源,价格只要闭源旗