梁文锋署名新论文,DeepSeek V4架构首曝?直击Transformer致命缺陷(在新窗口打开)
深夜,梁文锋署名的DeepSeek新论文又来了。这一次,他们提出全新的Engram模块,解决了Transformer的记忆难题,让模型容量不再靠堆参数!
共 108 篇
深夜,梁文锋署名的DeepSeek新论文又来了。这一次,他们提出全新的Engram模块,解决了Transformer的记忆难题,让模型容量不再靠堆参数!
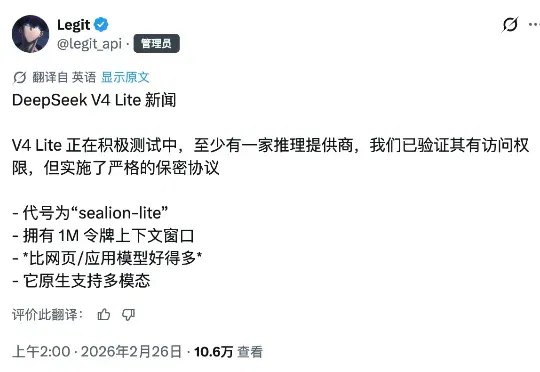
科技账号 Legit 率先披露,V4 的轻量版本代号为「sealion-lite(海狮轻量版)」,目前已在至少一家推理服务商处展开内测,相关方均签署了严格的保密协议。
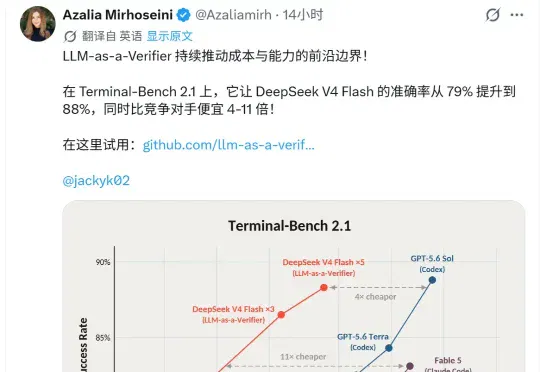
同样的模型,同样的任务,让它执行五遍,再让他自己挑一遍最稳的,效果能有多大提升?斯坦福把这套玩法用在了AI身上,DeepSeek V4 Flash在Terminal-Bench 2.1的成绩从79%一路涨到88%,反超了尖子生Fable 5。而且连做五遍加挑选这一通折腾,价格依然比Fable 5便宜了4-11倍。
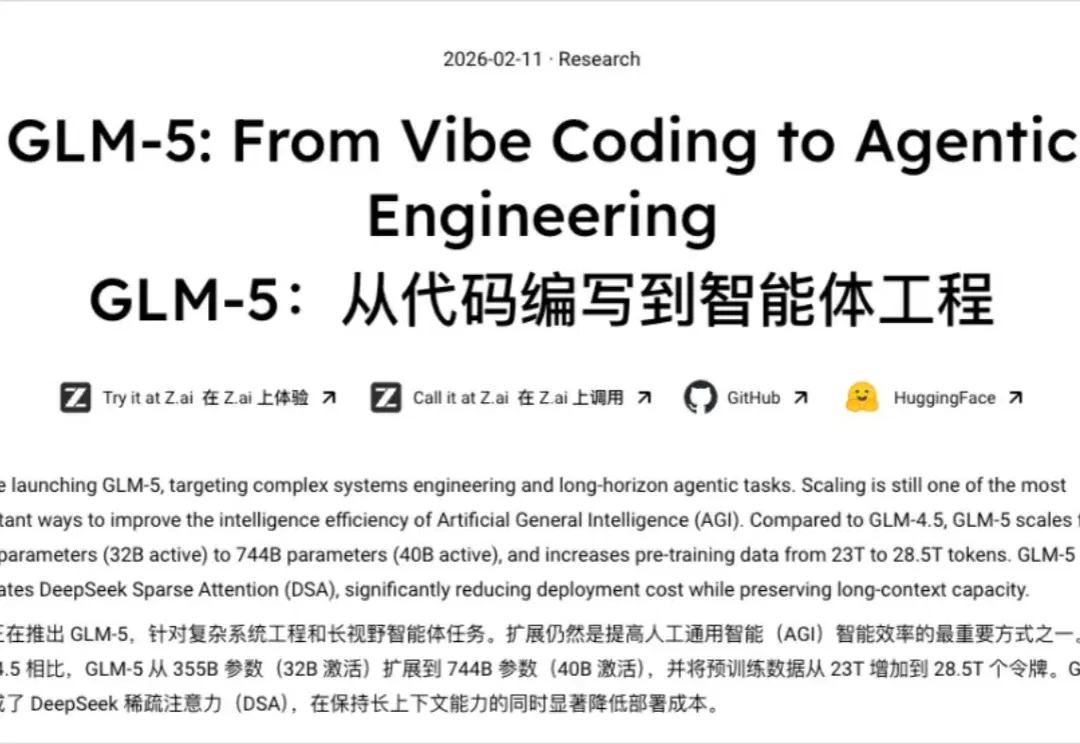
深夜,GLM-5来了。 还是老样子,发布即开源。 而且前几天,OpenRouter平台不是有一个Pony Alpha的匿名模型很火吗。 大家一度在猜是DeepSeek V4还是GLM-5,结果今天基本答案也揭晓了。 这大马,基本就是明示了。 到了今天,2026年的主旋律我觉得真的就已经就定下了,无论是国内还是海外。 Coding与视频齐飞,人类共AI一色。 这应该就是2026年AI领域最核心的两个主航道了,在这两之上,其实就是Agent。 这几天真的感觉过年一样,太热闹了,上周GPT-5.3 codex和Claude Opus 4.6中门对狙,后脚Seedance 2.0席卷全球,而现在,战场
春节还没到,「过年的气氛」已经渗入科技圈每个人的毛孔。单说 AI 大模型这一块,刚刚发布的有 kimi 2.5 和 Step 3.5 Flash,即将发布的据说还有 DeepSeek V4,GPT-5.3、Claude Sonnet 5、Qwen 3.5,GLM-5,说不定一觉醒来,现有的技术就要被颠覆。
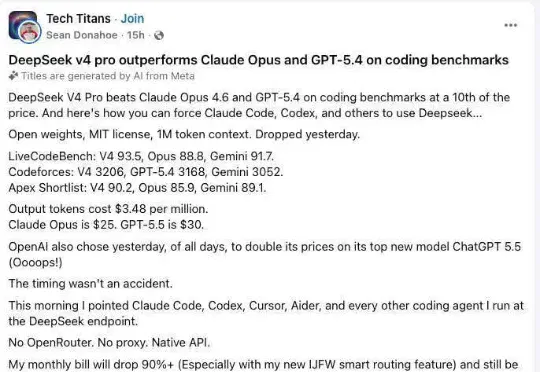
科技博主兼 AI 系统架构师 Sean Donahoe 在今天凌晨发了一条帖子。他写道:这条帖子实际上有两个看点。第一,发帖人是重度 AI 编程用户,却几乎一夜之间完成迁移,月账单会从几千美元降到几百美元。第二,他不只是说便宜,还强调效果没有变差,反而更好:“输出质量提高了,而不是下降,这一点已经通过内部测试以及多个公开基准验证”。
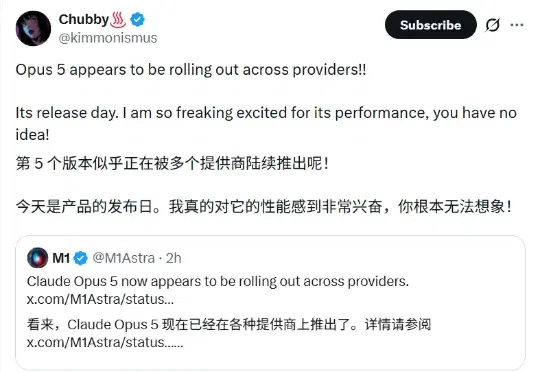
大家还没等来DeepSeek V4的发布消息,Anthropic家Claude Opus 5今夜即将推出的消息,已经先把全网开发者的热情点燃了。一句"性能强得超乎想象,各大平台正陆续上线"的传闻,将全网的目光再次聚焦在Anthropic上。
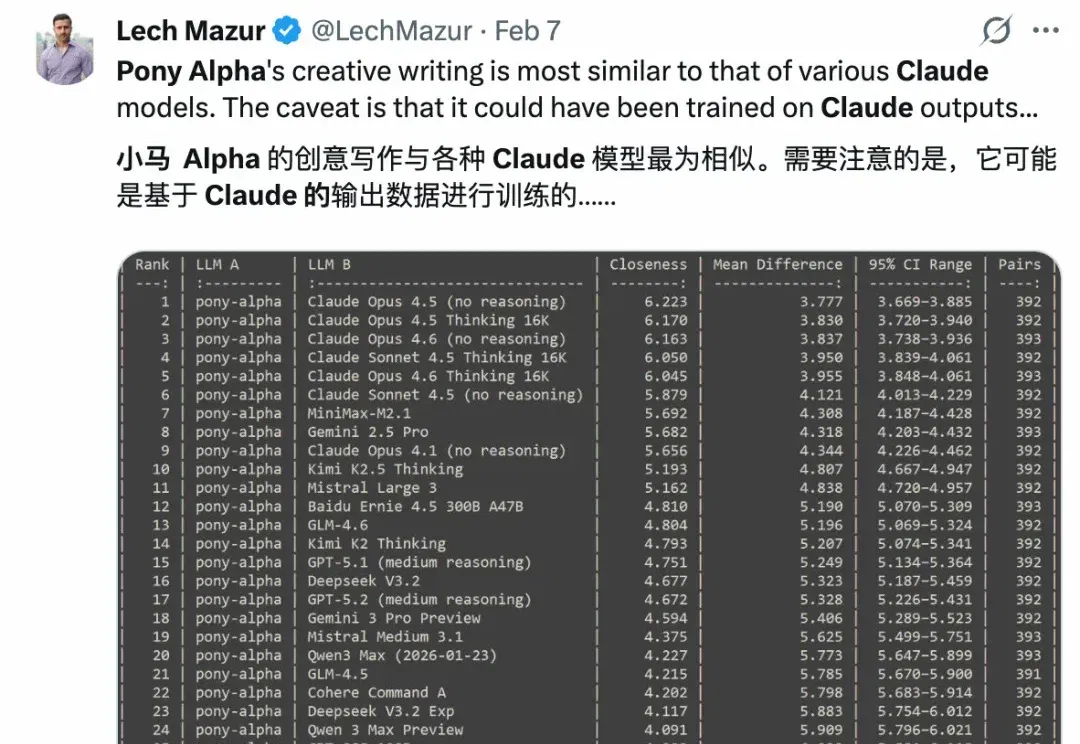
马年未至,春节档新模型已经蓄势待发。 OpenRouter就已悄然上线了一款强大的神秘模型“Pony Alpha”,几天之内引发了一大波网友的无奖竞猜! 有人猜它是Claude新模型: 有人猜它是Codex 4.6: 还有人猜它是xAI并入SpaceX后推出的Grok 4.2: 甚至Llama 5都出来了…… 根据OpenRouter官方说法,这款神秘模型主打编码、推理和角色扮演,它针对智能体工作流进行了优化,具有很高的工具调用准确率。 经过几天的发酵,目前的备选答案满天飞,各家模型都被提了一遍。不过基于即将到来的马年春节,大多数网友认为这很可能是一款中国模型。 DeepSeek-V4和GLM
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存
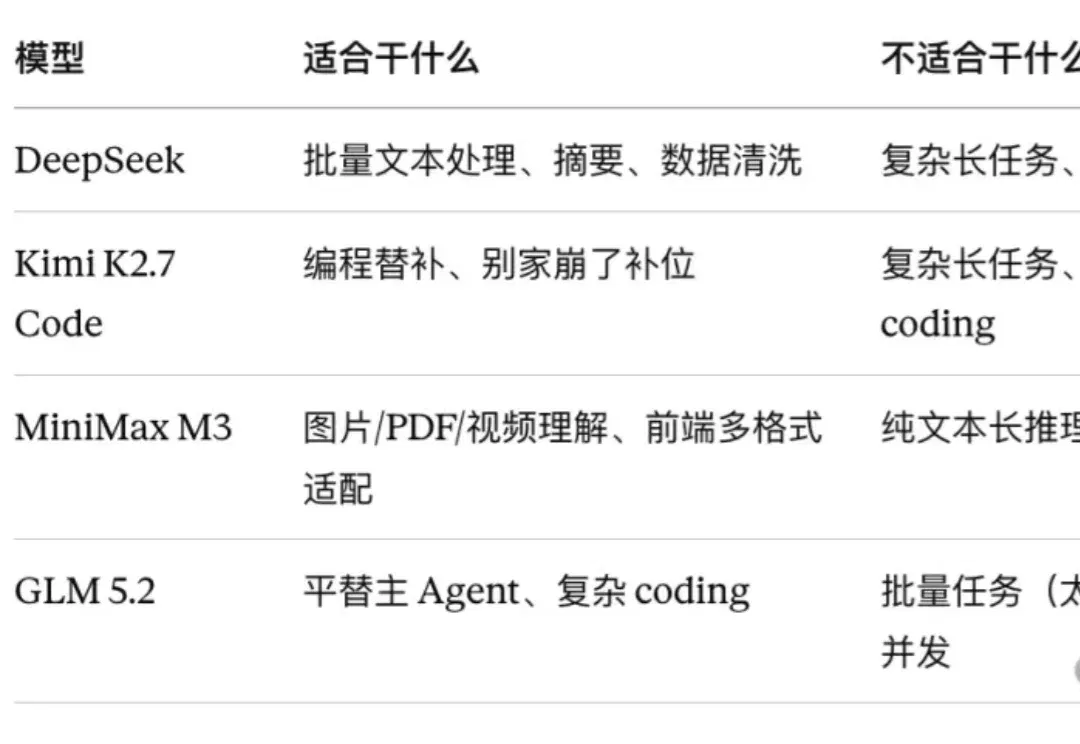
最近,Kimi 2.7 Code 和 GLM 5.2 接连发布,一周双发,国产模型又崛起了。