Transformer开始构建三维世界:开源模型几张图片秒级生成可探索3D场景(在新窗口打开)
从 2D 像素到 3D 场景 Query,影溯正在尝试把三维内容生产推向可规模化调用的新阶段。
共 126 篇
从 2D 像素到 3D 场景 Query,影溯正在尝试把三维内容生产推向可规模化调用的新阶段。
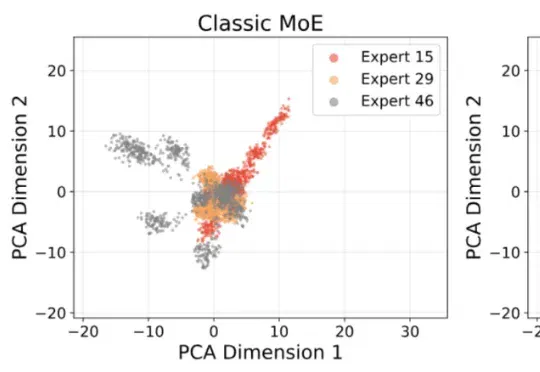
近年来,Mixture-of-Experts(MoE)已经成为大模型扩展的重要架构之一。相比稠密 Transformer,MoE 通过稀疏激活机制,在每个 token 上只调用少量专家,从而在控制计算成本的同时扩大模型容量。然而,一个长期存在的问题是:专家越多,并不意味着专家真的学得越 “专”。
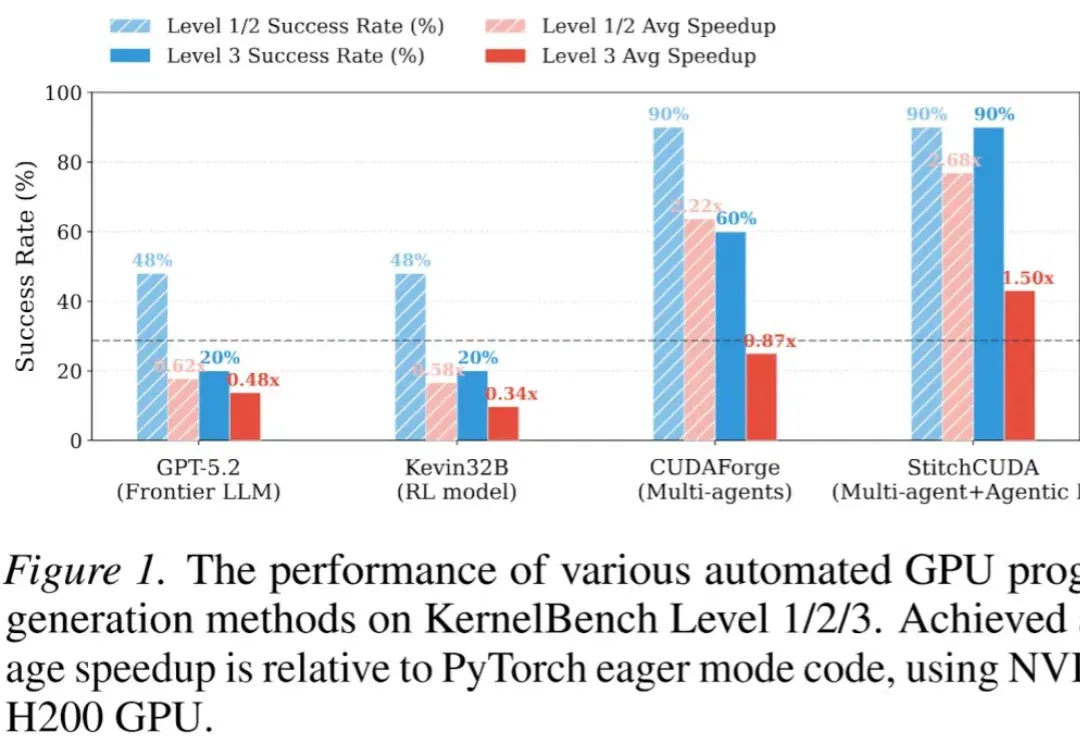
现有的 LLM 自动化 CUDA 方法大多只能优化单个 Kernel,面对完整的端到端 GPU 程序(如整个 VisionTransformer 推理)往往束手无策。
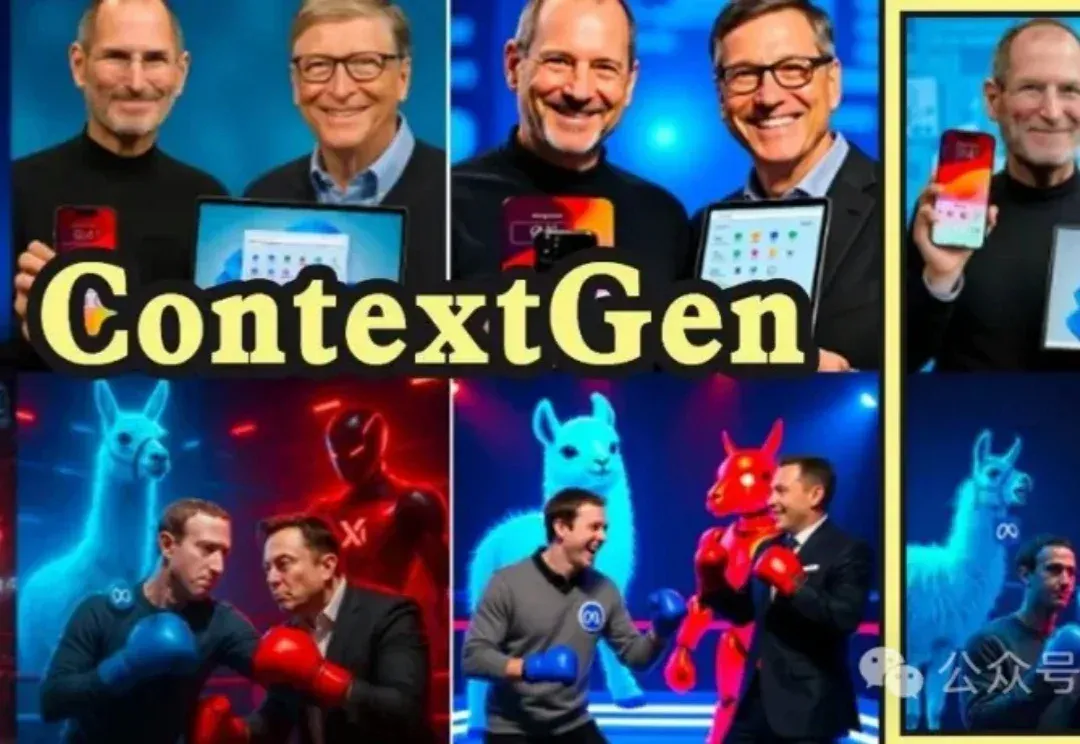
浙江大学ReLER团队开源ContextGen框架,攻克多实例图像生成中布局与身份协同控制难题。基于Diffusion Transformer架构,通过双重注意力机制,实现布局精准锚定与身份高保真隔离,在基准测试中超越开源SOTA模型,对标GPT-4o等闭源系统,为定制化AI图像生成带来新突破。
谷歌花27亿美元(约192亿人民币)挖来的Transformer“贡献最大”作者Noam Shazzer,现在点燃了火药桶。
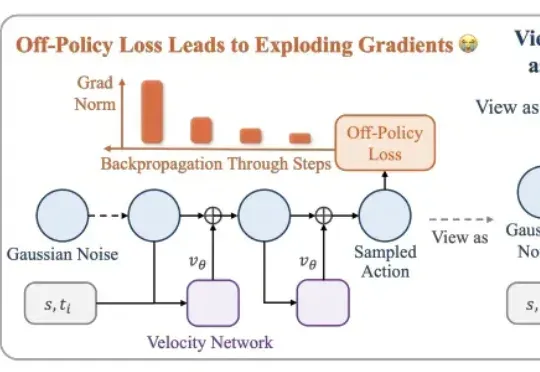
本文介绍了一种用高数据效率强化学习算法 SAC 训练流策略的新方案,可以端到端优化真实的流策略,而无需采用替代目标或者策略蒸馏。SAC FLow 的核心思想是把流策略视作一个 residual RNN,再用 GRU 门控和 Transformer Decoder 两套速度参数化。
训练大模型,能不能不用反向传播? 这事一直有人琢磨。只是反向传播太成功了:过去这些年,反向传播一直是训练神经网络的唯一主流算法。我们今天所有的架构、优化器、甚至 GPU 硬件,某种意义上都是围着它长出来的。 但一直有人不信这个邪:反向传播要求整个网络处处可微,这其实是个很强的限制,不可微的模块、离散的计算、外部程序,统统进不了训练回路。 那么,如果算力足够便宜,能不能干脆不「算」梯度了,改用一种最原始的思路 —— 随机把网络改一改,看它变好还是变坏,变好的方向就保留,变坏的就扔掉。这种办法笨是笨,但胜在什么都不挑:不管网络内部长什么样、可不可微,它都能用。 一家叫 Q Labs 的小型研究实验
这篇文章彻底颠覆了人工智能领域的认知,引发了广泛的猜测,Sam Altman 还公开表达了赞赏。
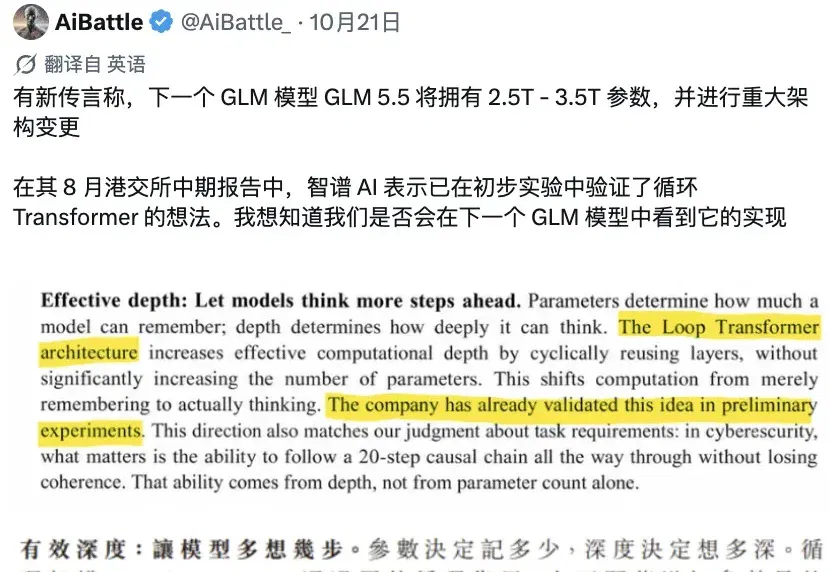
GLM-5.5,真的马上就来了?! 这不嘛,网上有GLM Coding Plan用户收到官方补偿通知,原因是此前部分用户遭遇了模型「降智」问题。 但比补偿本身更有看头的,是智谱在公告里留下的一句话—— 新模型发布后,还会额外赠送一次额度重置机会哈! 好啊好啊,一份补偿通知,竟然顺手把下一代模型给剧透了。(doge) 而且巧了,最近关于GLM-5.5的爆料,也开始一波接一波冒出来了。 有小道消息称,GLM-5.5的参数规模可能达到2.5万亿—3.5万亿,比此前传闻的1.6万亿还要大上一截! 还有友友猜测,智谱此前初步验证的循环Transformer架构,会不会也用在下一代GLM上??? 这...
机器之心报道 编辑:泽南、杨文 现在,只需要一个简单的、用深度光线表示训练的 Transformer 就行了。 这项研究证明了,如今大多数 3D 视觉研究都存在过度设计的问题。 本周五,AI 社区最热