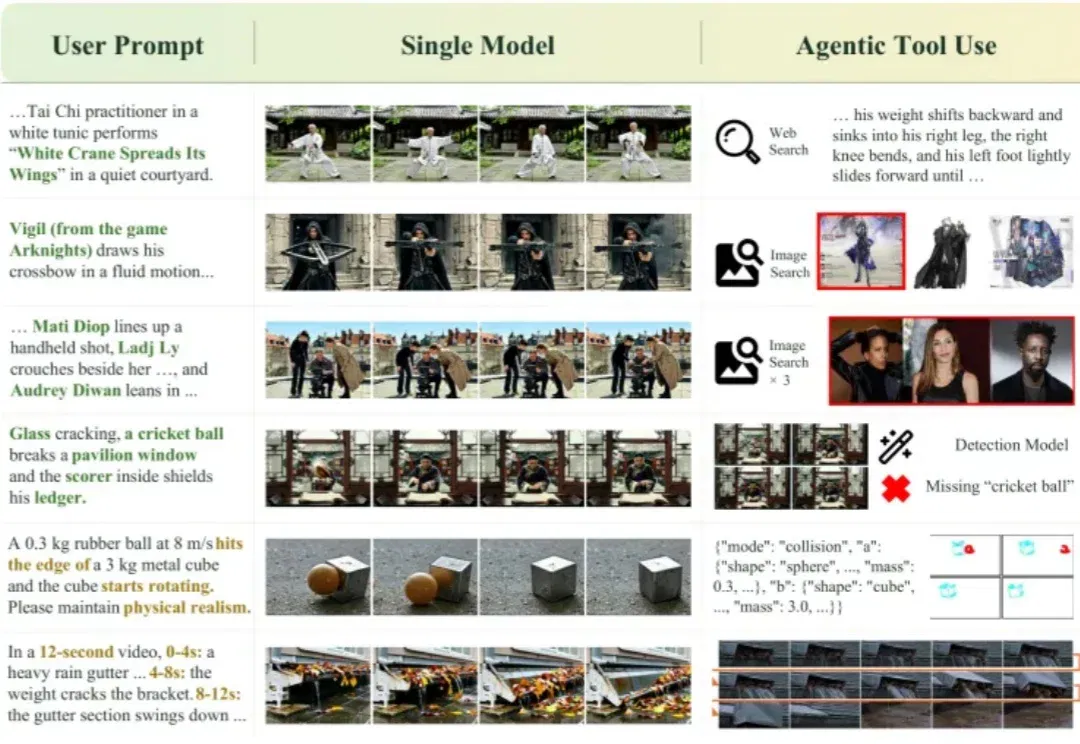
视频生成也能查资料、做模拟:8B智能体学会自主调用工具(在新窗口打开)
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
共 198 篇
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
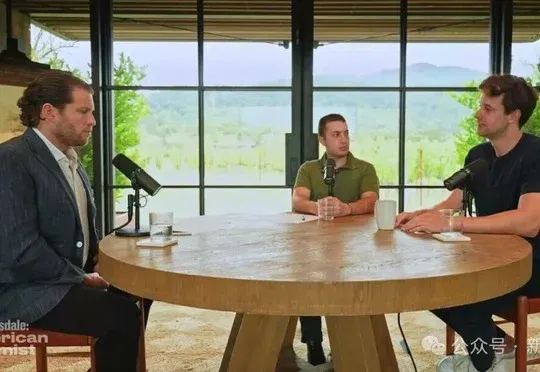
Anthropic强化学习技术负责人Sholto Douglas预测,能力等于甚至超过所有人类的AGI可能在未来几年内出现,2028年AI年度资本开支或达4万亿美元,而研究员Nick Marwell对AI无需人类搭档后的后果表示紧张。
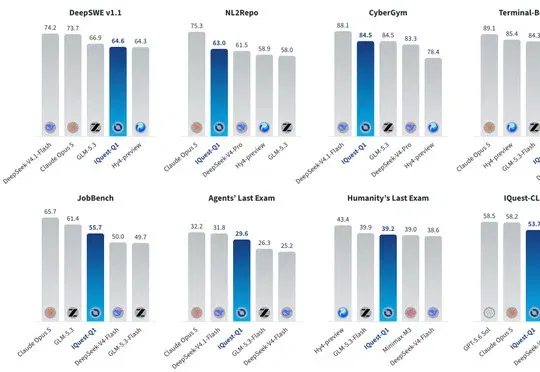
至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。
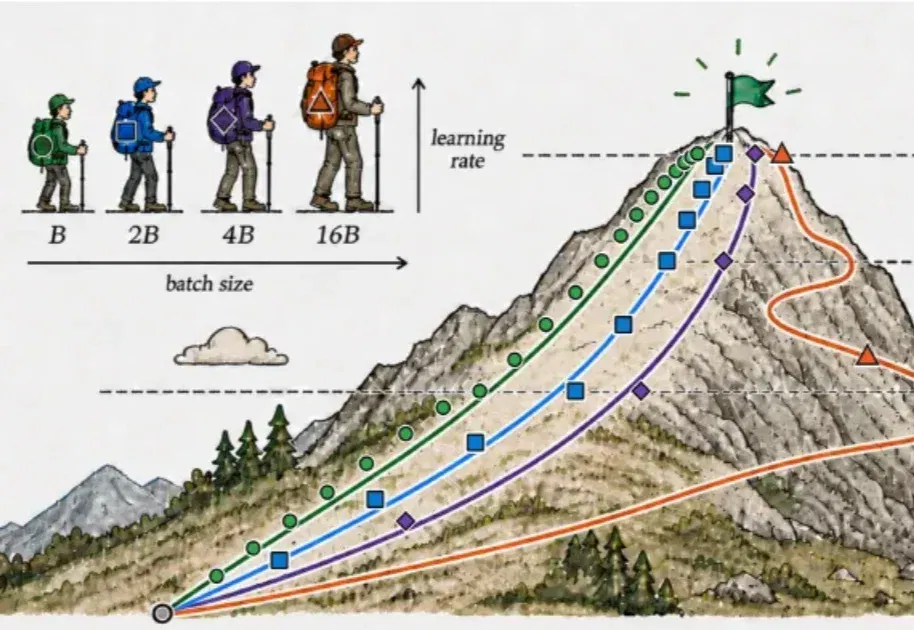
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
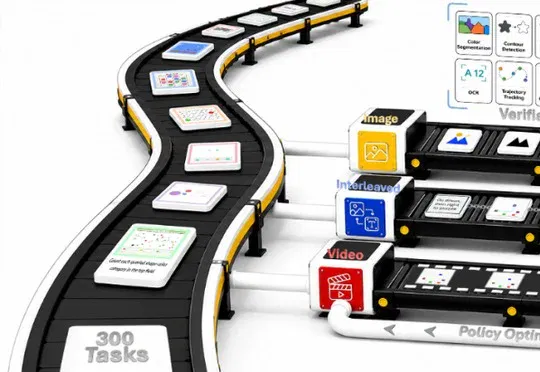
NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。
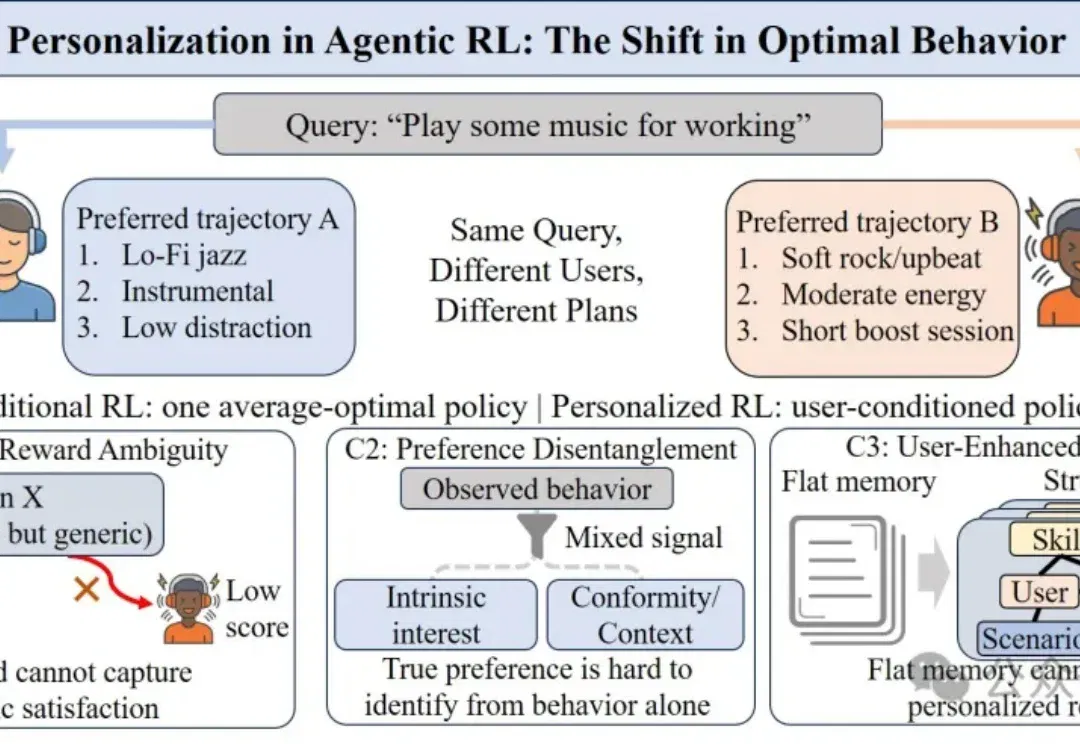
当个性化Agentic RL遇上现实用户平台场景时,一直存在一个常见难点:面对同样的query,不同用户往往偏好不同的规划策略、工具调用和最终表达。
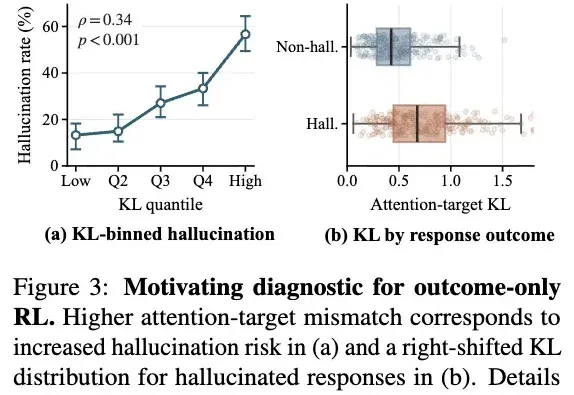
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
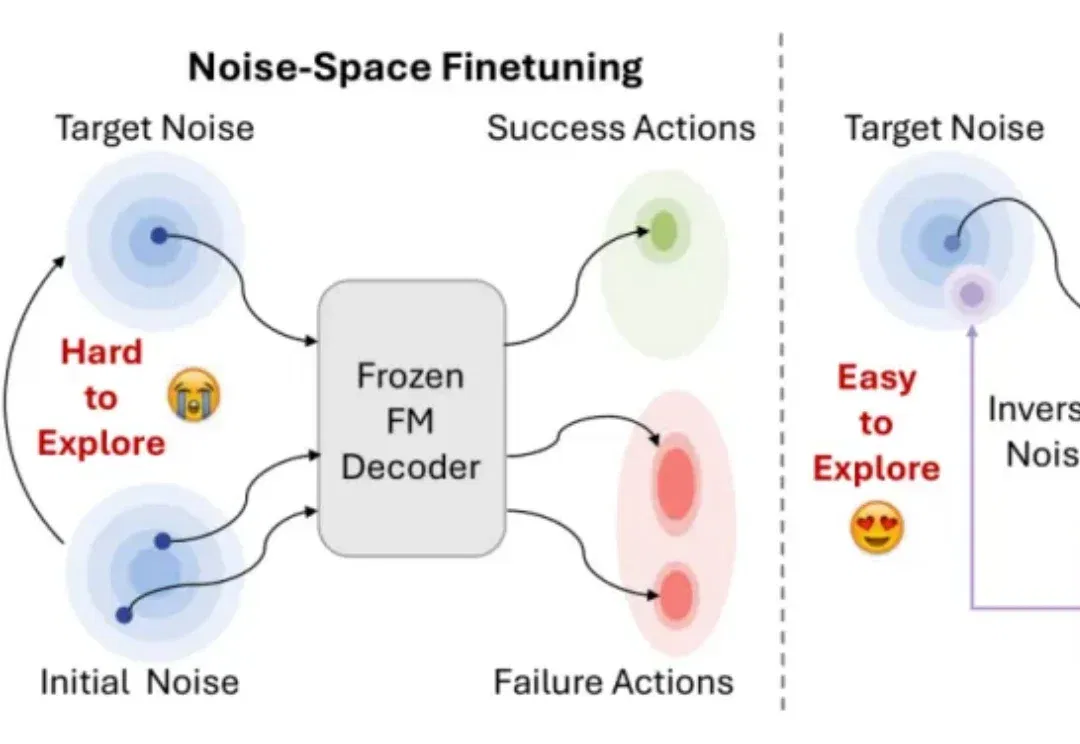
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
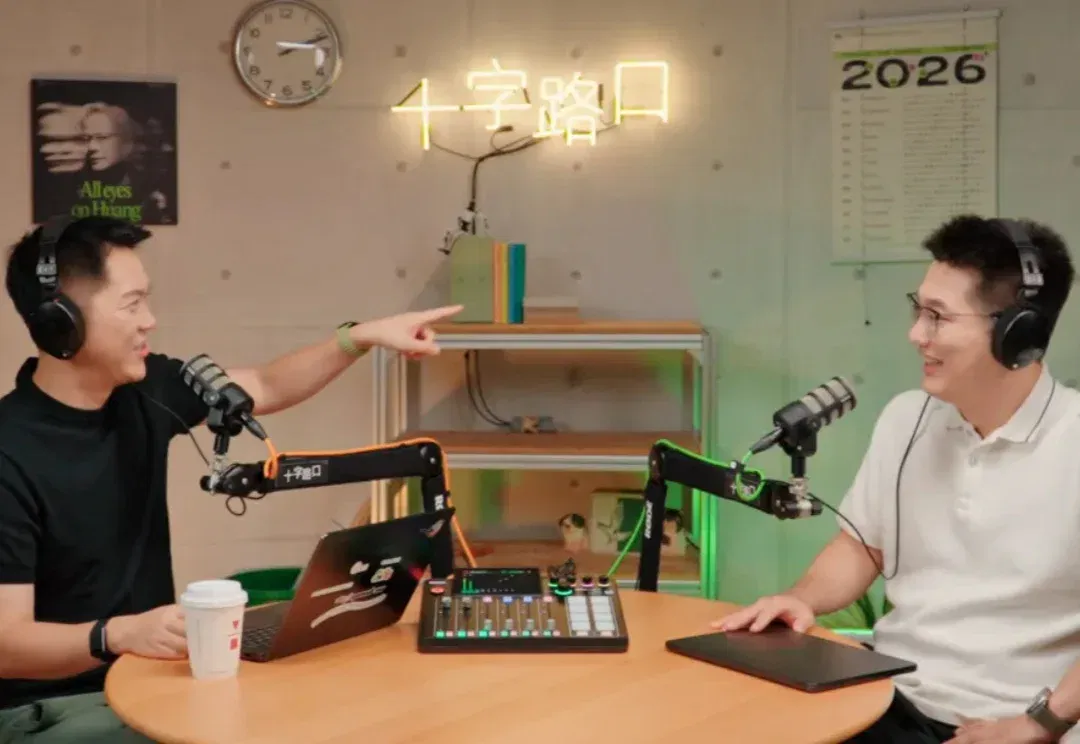
本周「十字路口」的嘉宾是 Pyromind 创始人 / CEO Kevin Ding。Pyromind 所在的赛道,常被称作 RL as a Service,也就是强化学习即服务、或后训练即服务。公司前不久完成天使轮融资,投资方包括高瓴、百度风投、蓝驰、Atypical 等机构。