Claude 如何做回答后的安全自评估?新模型传闻之外的监测机制(在新窗口打开)
Anthropic 介绍在回答后复用上下文进行安全自评估,用结构化风险信号辅助后续调查和复核。这种离线筛查与实时拦截、自动封号并非一回事;报道同时提到的 Fable 5.5 测试与路由信息仍是传闻,不能仅凭模型回答识别后台版本。
共 1092 篇
Anthropic 介绍在回答后复用上下文进行安全自评估,用结构化风险信号辅助后续调查和复核。这种离线筛查与实时拦截、自动封号并非一回事;报道同时提到的 Fable 5.5 测试与路由信息仍是传闻,不能仅凭模型回答识别后台版本。
报道介绍 Mithril Medicine 由全职创始人、科学顾问、外部实验室与 Claude 协作推进研发的案例,以及 Anthropic 公布的药企合作进展。相关候选药与实验成果主要处于临床前阶段,不能等同于疗法已经验证或上市。
太好笑了,薅羊毛最狠的那批人,这回被精准薅了回去!
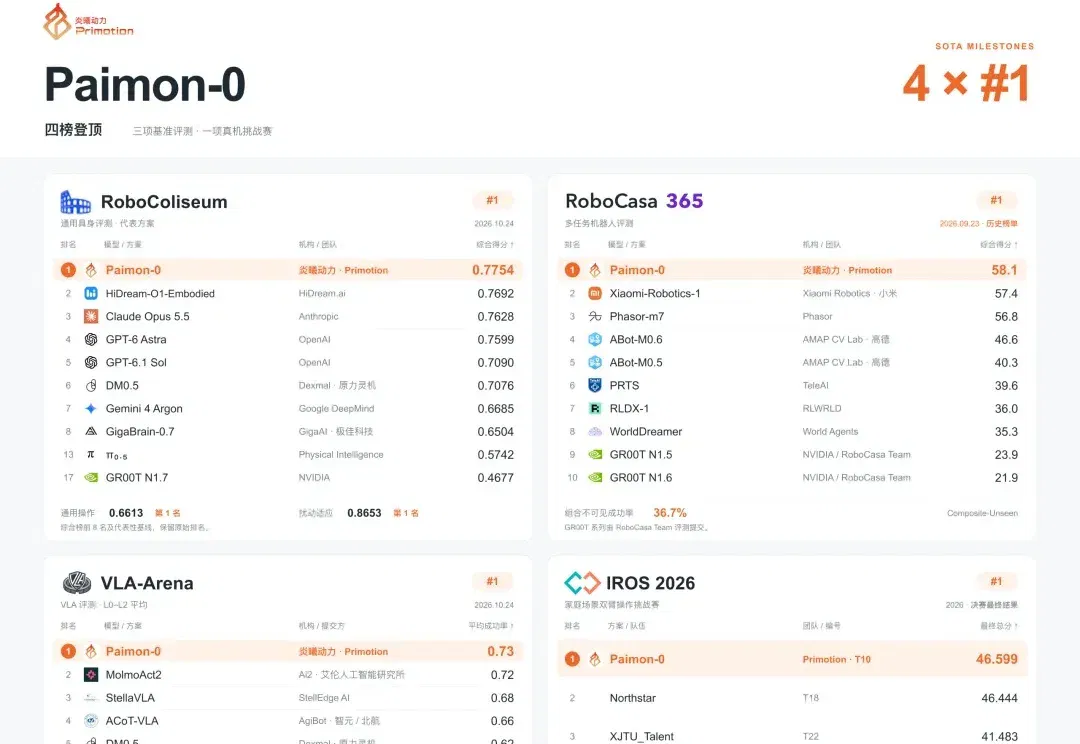
太反差了。 一家在深圳成立刚满三个月的公司,明明给自己的定位是做具身芯片,可它对外拿出的第一份成果,却是一个名叫Paimon的具身基座模型(系列)。 然后这个系列里的首款模型Paimon-0初次亮相,就直接拿下了四项第一: 先看含金量最高的RoboColiseum,这个由 Hugging Face、NVIDIA、清华大学等全球近 20 家高校、企业、科研机构共建的榜单,最近在具身圈热度居高不下;Paimon-0 以 0.7754 分排在第一。 要知道,这个榜最近可是刚把GPT-6 Astra、Claude Opus 5.5、Gemini 4 Argon这些通用多模态大模型请进场同台比试的: 虽
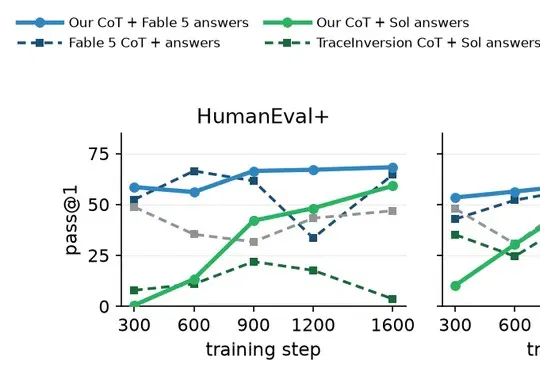
王琰在 TraceForge 技术报告中提出用同族模型合成原生思维链,在 Qwen3.5-9B-Base 实验中超过直接蒸馏 Claude Fable 5 思维链的方案,动摇闭源模型以隐藏思维链构筑的能力护城河。
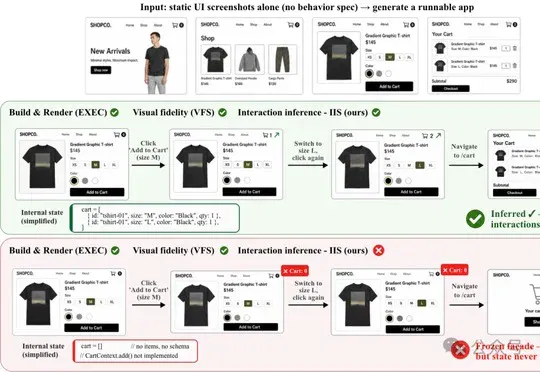
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
独立开发者借助Claude约4小时做出网页游戏1 in 8 Billion,支持按172个国家和地区的统计数据随机投胎并模拟一生,随后在韩国和日本社交平台传播。
如今,AI正式杀入物理世界! 在具身能力方面,语言模型到底谁能称王? 更残酷的问题是,机器人公司耗费数年苦练的本领,会被通用LLM直接碾压吗? 就在今天,GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5 以及 Gemini 4 Argon 等全球最顶尖的多模态大模型齐聚一堂。 在常态化具身智能仿真评测平台 RoboColiseum(机器人角斗场) 上,它们展开了一场真刀真枪的「肉搏战」。 这份榜单不仅彻底炒热了具身智能圈,更无情地揭露了当前顶尖大模型在控制机器人时的「隐藏命门」! 揭榜时刻:四模型大乱斗,结果令人意外 本次测试,所有的顶尖模型都接入了统一的控制框架
AI 制药的故事,终于从计算机里的分子结构,走到了实验室的试管里……
硅谷「御三家」AI决战,十月彻底引爆! 就在今天,X上有人爆料称,Anthropic的终极王牌Fable 5.5,很可能明天就要突袭上线! 几乎同一时间,The Information曝出猛料,Anthropic的新模型已经在测试者手里跑起来了。 用过它的人透露,下一代神话级Claude的跃升,集中在「推理深度、直觉判断、读懂人类意图」三大能力上。 最可怕的是,它炼出了强大的「读心术」,即便你没说出明确需求,它也能get到你真正想要什么。 你只让它修1个Bug,它能把背后一整类问题全揪出来! Anthropic这张牌还没正式亮出来,OpenAI和谷歌也坐不住了。谷歌Gemini 4 Carbo