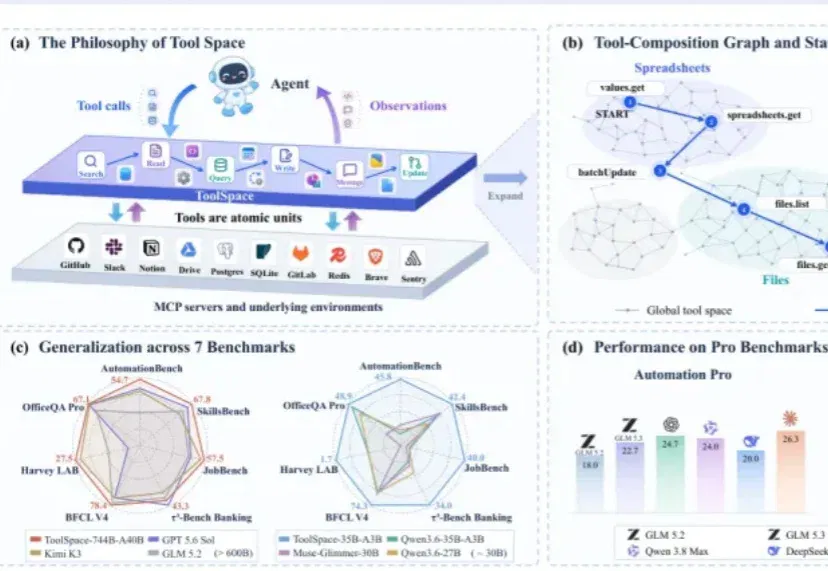
ToolSpace从工具依赖合成跨环境任务,报告长程智能体训练收益(在新窗口打开)
人大、复旦等团队提出ToolSpace,从执行轨迹构建工具组合图并合成可验证任务。744B模型在论文所列七项基准的平均分达到56.6,与所列Claude Opus 5平均成绩持平。
共 1092 篇
人大、复旦等团队提出ToolSpace,从执行轨迹构建工具组合图并合成可验证任务。744B模型在论文所列七项基准的平均分达到56.6,与所列Claude Opus 5平均成绩持平。
APPSO介绍可见参会、实时笔记与白板协作,并讨论通知、外部访客、数据保留和摘要如何影响团队讨论。
VulnCheck 追踪报告讨论候选漏洞与公开修复记录的差距。Anthropic 公布的审核和上游补丁数据采用不同口径,不能直接等同。
Bingjie Tang 的个人主页确认,她已加入 Anthropic。报道回顾其在数据采集、策略训练和真机部署方面的经历,并介绍 Claude 的机器人测试。
Anthropic 发布两款新旗舰,并披露 RoboDojo、既有数学证明形式化及实验设计的测试结果。Fable 与 Mythos 的开放方式和安全限制各有不同。
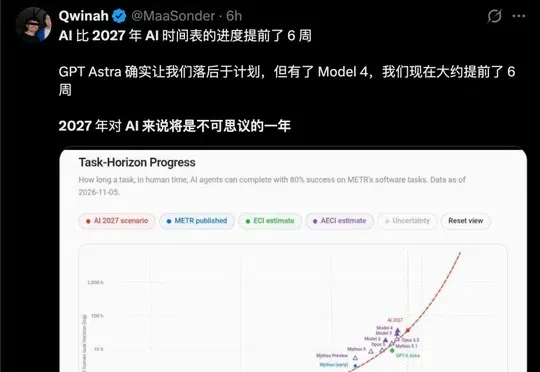
报告结合 Claude 使用记录和学者问卷,估计广泛采用现有工具可能分担 27% 至 52% 的研究工时。更高的产出倍率来自非实操任务自动化的假设情景。
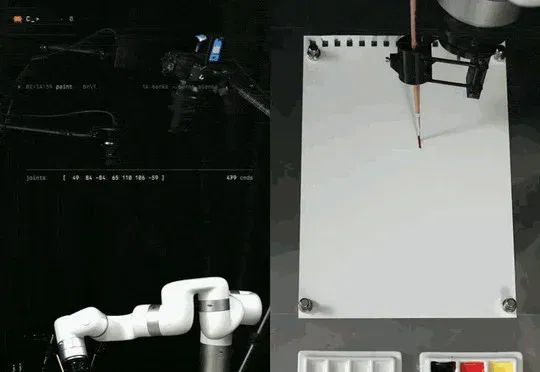
开发者称,系统在绘制《秋之冠》时发现缺少过渡色,用相机检查配色后继续绘制。案例依赖路径规划、碰撞检查和确定性执行器。
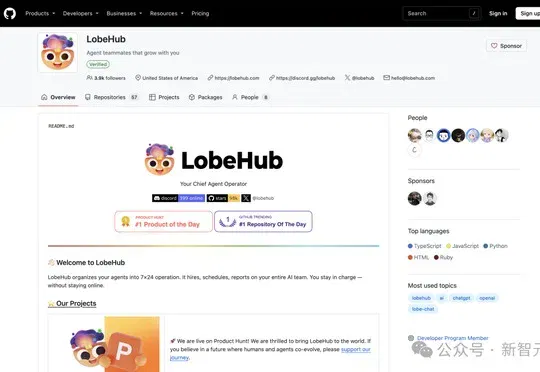
报道让 Claude 与 ChatGPT 分别负责撰稿和审阅,记录团队分派、异步执行和人工验收,并介绍 LobeHub 内部跟进代码变更的案例。
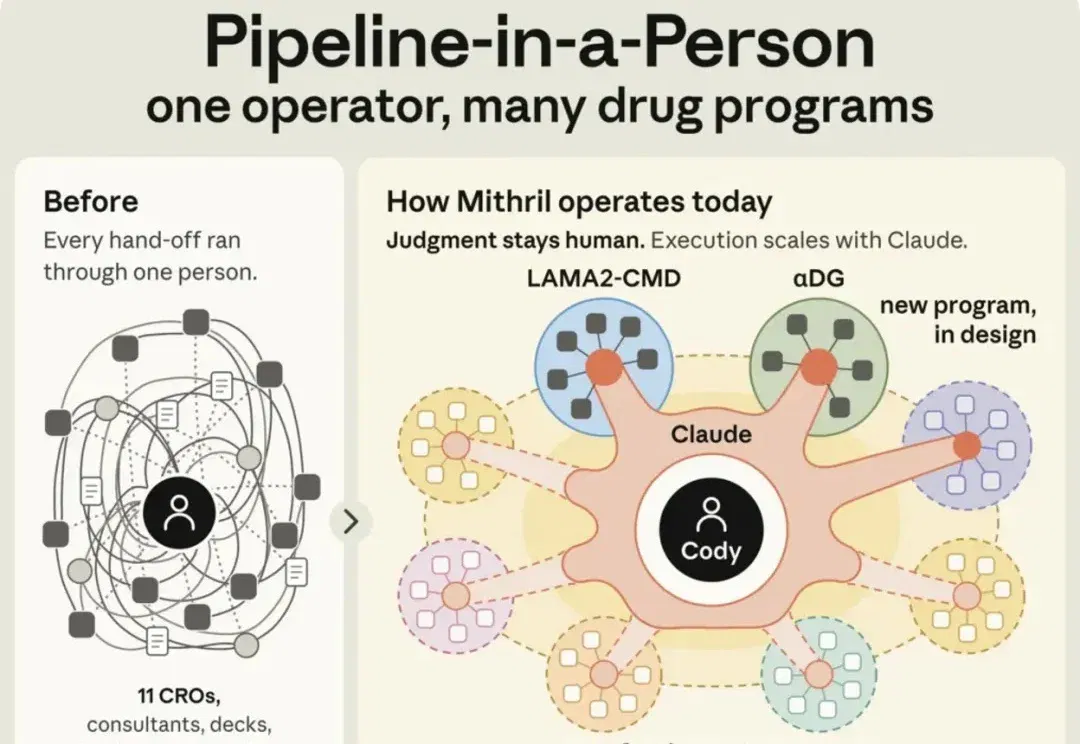
文章介绍 Anthropic 收购 Mithril Medicine 的研究背景:创始人借助 Claude 协调外部实验室,推进两项罕见病项目。已有结果仍处于早期动物实验阶段,尚不能证明对人体有效;案例也暴露出数据审核和跨机构沟通中需要人工复核的风险。
量子位报道,曾参与 Claude 与 Cowork 设计的 Jenny Wen 已转向 Cursor,其社交简介也出现 Grok Bot。文章回顾她从 FigJam 到通用智能体的工作经历,以及对设计流程、快速试错和用户控制的看法;是否能改善新产品体验仍要看后续交付。