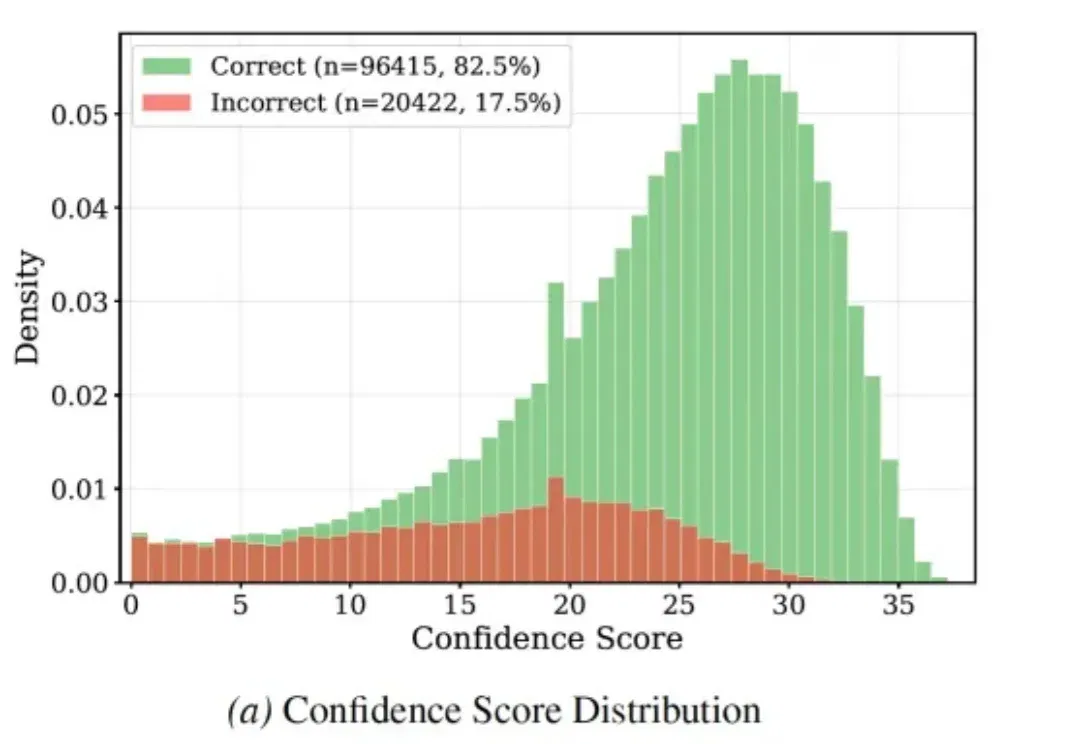
ICML 2026|让奖励模型更准更高效,TikTok、NUS提出置信度门控(在新窗口打开)
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
共 997 篇
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
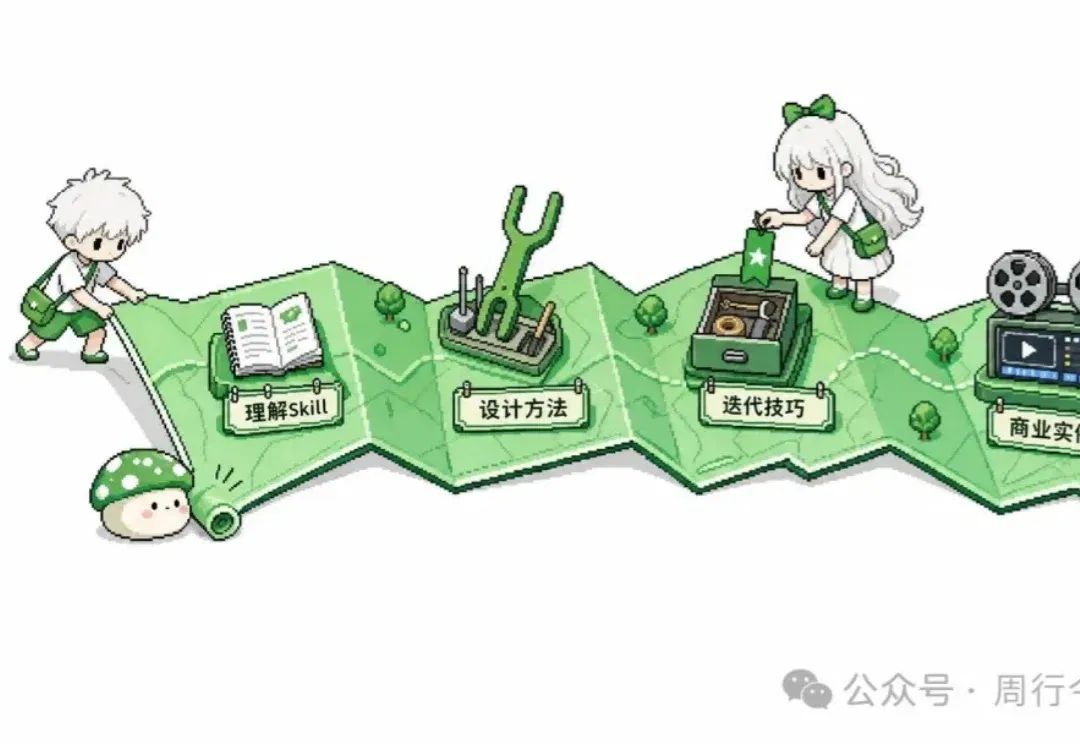
这篇文章,我会从我对Skill的理解、设计Skill的方法、怎么升级和迭代Skill这些维度展开。并且会结合之前的Codex自动化剪辑工作流,尽可能用简单和直白的语言,把Skill讲清楚,确保朋友们看完就能用得上。
本文作者 Eric Provencher,在 OpenAI 负责 Codex 开发者体验(DX),此前是 Repo Prompt 的作者。原文是 OpenAI 官方文档中的 Prompting 指南,以下为逐段中英对照翻译
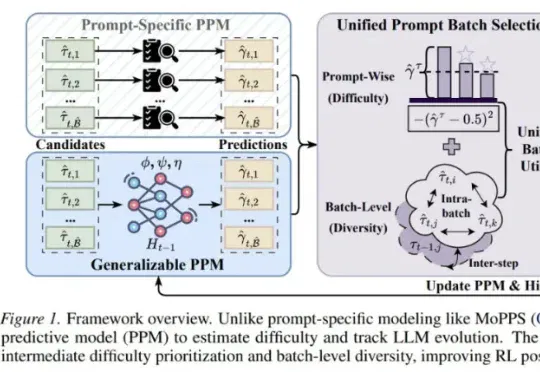
来自清华大学与腾讯的研究者提出了 Generalizable Predictive Prompt Selection(GPS)。GPS 的做法很直接:先训练一个小型、可泛化的 Prompt Predictive Model(PPM),让它预测不同 prompt 在当前模型下的难度;再根据难度和 batch 多样性选择训练样本,从而减少无效 rollout。
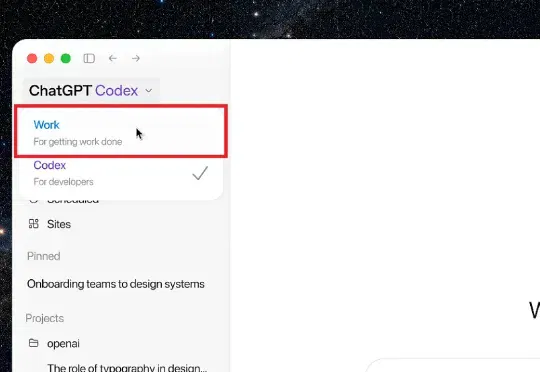
今天凌晨,OpenAI进行线上直播,正式面向全球用户推出新一代GPT-5.6模型家族,并同步发布Agent产品ChatGPT Work、全新ChatGPT桌面应用以及Hosted Sites(托管网站)三大产品更新。
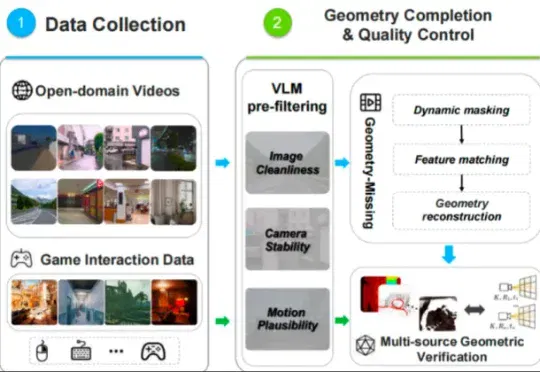
专注于4D世界模型研发和产业化的魔芯科技联合浙江大学潘云鹤院士团队发布MoWorld——全球首个Flash World Model,也是首个全栈基于国产NPU构建的实时交互世界模型。
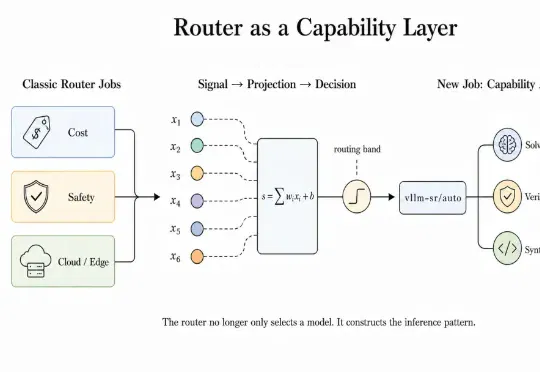
vLLM 社区推出的 Semantic Router 除了专注上面三个方向,正在更进一步:我们认为:router 不只是选择模型,还可以提升模型能力。用户不用改权重,也不用让每个 Agent 团队都自己搭一套 Graph,而是在一次普通 Model API 调用的内部,组织出一支有边界、有预算、有验证、有回退的 “小队”。
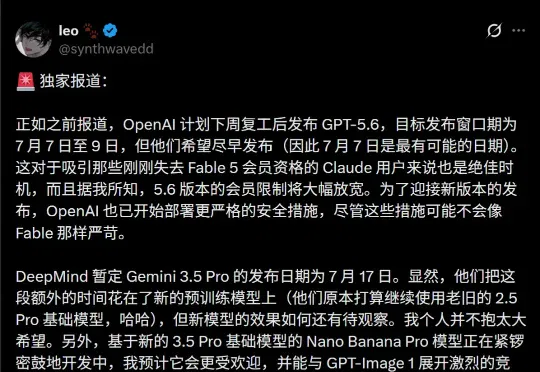
就在昨天,网友们激动发现:Codex应用的底层代码中惊现GPT-5.6 Sol、Terra和Luna三大子模型标识。更令人期待的是,一个全新的「速度拨盘」功能也出现在代码中。根据爆料,OpenAI已经在内部定下了死命令:GPT-5.6发布的目标窗口直指下周二(7月7日)至7月9日。
上个月也就是昨天,我写了一篇LongCat 2.0的实测,用四个任务测了一下它的编程能力,当时我的评价是「有些地方惊艳,有些地方还差点意思」。
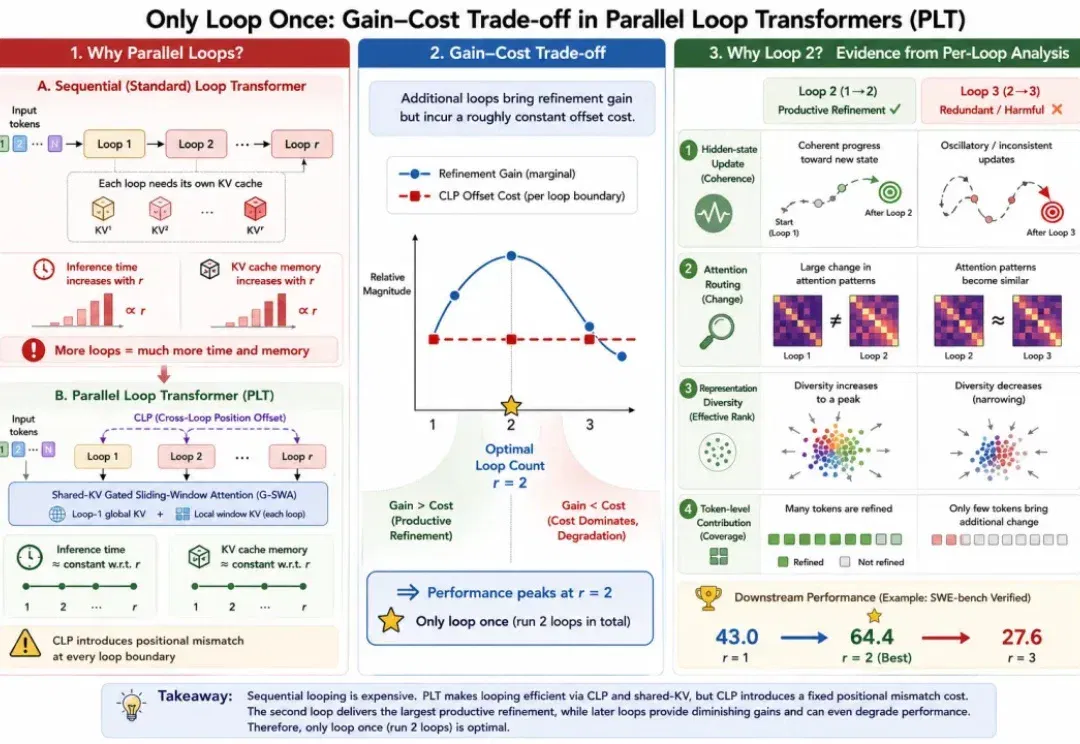
当所有人都在比谁「想得更久、算得更多」——推理模型动辄输出成千上万个思考 token,循环式架构恨不得在内部反复迭代十遍八遍——一项新研究反手泼了盆冷水: