超10万亿Tokens的高质量数据集是怎么炼成的?专访中国电信天翼AI阮宜龙(在新窗口打开)
正所谓“得数据者得天下”,这家央企算是把高质量数据集给玩明白了——超过10万亿tokens的通用大模型语料数据,以及覆盖14个关键行业的专业数据集,总存储量高达350TB!
共 8400 篇
正所谓“得数据者得天下”,这家央企算是把高质量数据集给玩明白了——超过10万亿tokens的通用大模型语料数据,以及覆盖14个关键行业的专业数据集,总存储量高达350TB!
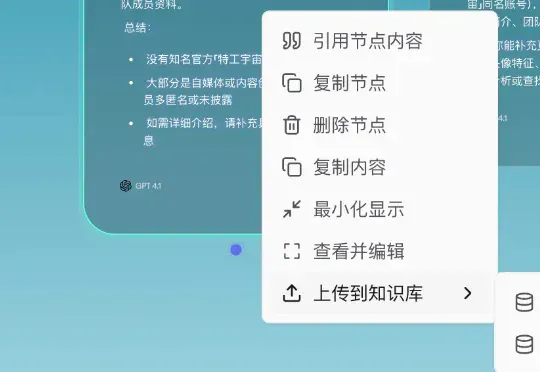
最近 flowith 推出了全新画布,交互形态全新升级,现在 AI 生成的任意内容,都可以被很方便的右键点击节点,存入任意知识库,后续工作都可以调用。说实话,flowith 是一款上手门槛比较高的产品,它不像一般对话式的 ChatBot 那样简单,
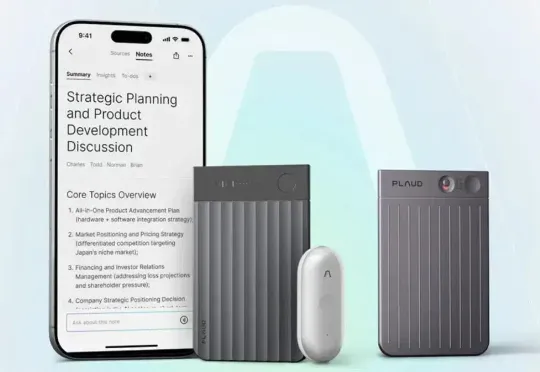
Plaud 没那么需要融资,它是全世界最成功的 AI 硬件 Startup。约 150 美金的录音卡片,卖给了全球超过 100 万人,引来大厂效仿,甚至还有美国团队跑来中国找供应商。你不好奇吗?为什么?
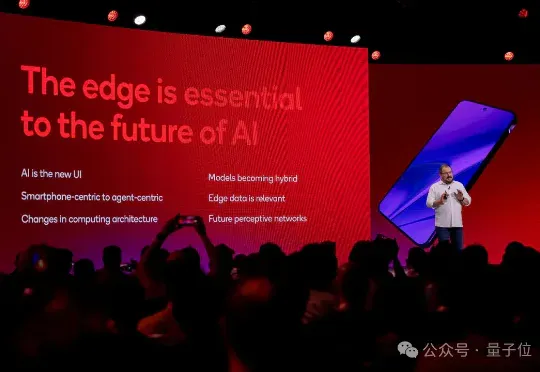
手机PC等终端芯片,在Agent变革面前也要被重塑了。面向PC,高通首次推出专为超高端PC打造的骁龙X2 Elite Extreme,目标是“轻松驾驭智能体AI体验”;
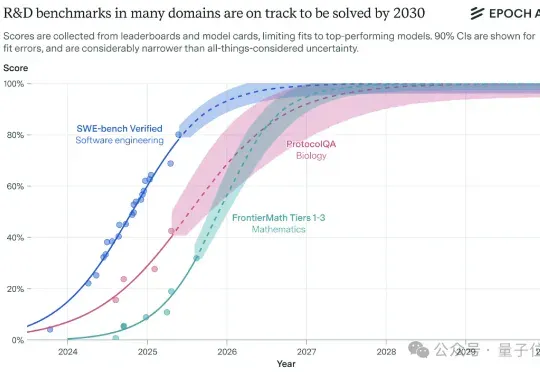
2030年的人工智能将会是什么样子?受谷歌DeepMind委托,Epoch发布新报告,从算力、数据、收入等方面进行了详细剖析。
刚刚,Meta FAIR推出了代码世界模型!CWM(Code World Model),一个参数量为32B、上下文大小达131k token的密集语言模型,专为代码生成和推理打造的研究模型。这是全球首个将世界模型系统性引入代码生成的语言模型。
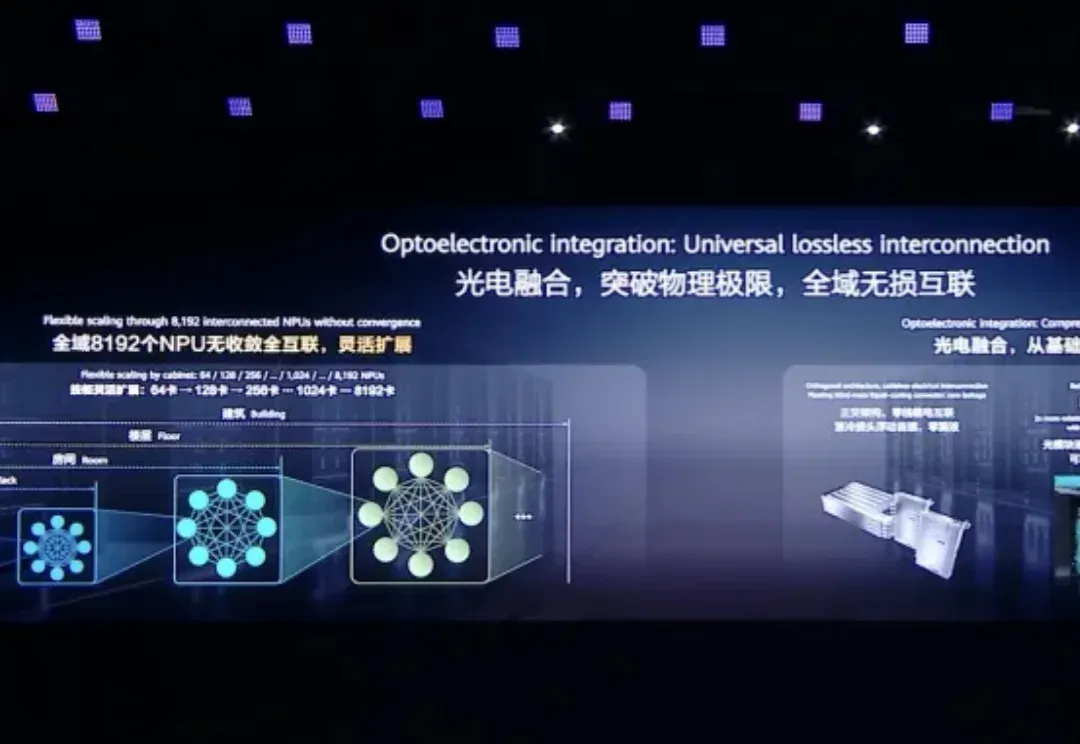
上周,华为全联接大会集中展示了华为最新最强的一系列创新。
答案或许渐渐清晰。李飞飞团队与斯坦福 AI 实验室正式官宣:首届 BEHAVIOR 挑战赛将登陆 NeurIPS 2025。这是一个为具身智能量身定制的 “超级 benchmark”,涵盖真实家庭场景下最关键的 1000 个日常任务(烹饪、清洁、整理……),并首次以 50 个完整长时段任务作为核心赛题,考验机器人能否在逼真的虚拟环境中完成真正贴近人类生活的操作。
9月24日,在杭州召开的云栖大会上,阿里巴巴集团CEO、阿里云智能集团董事长兼CEO吴泳铭发表主旨演讲,他认为实现通用人工智能AGI已是确定性事件,但这只是起点,终极目标是发展出能自我迭代、全面超越人类的超级人工智能ASI。
真正在乎软件的人,应该去制造属于自己的硬件。