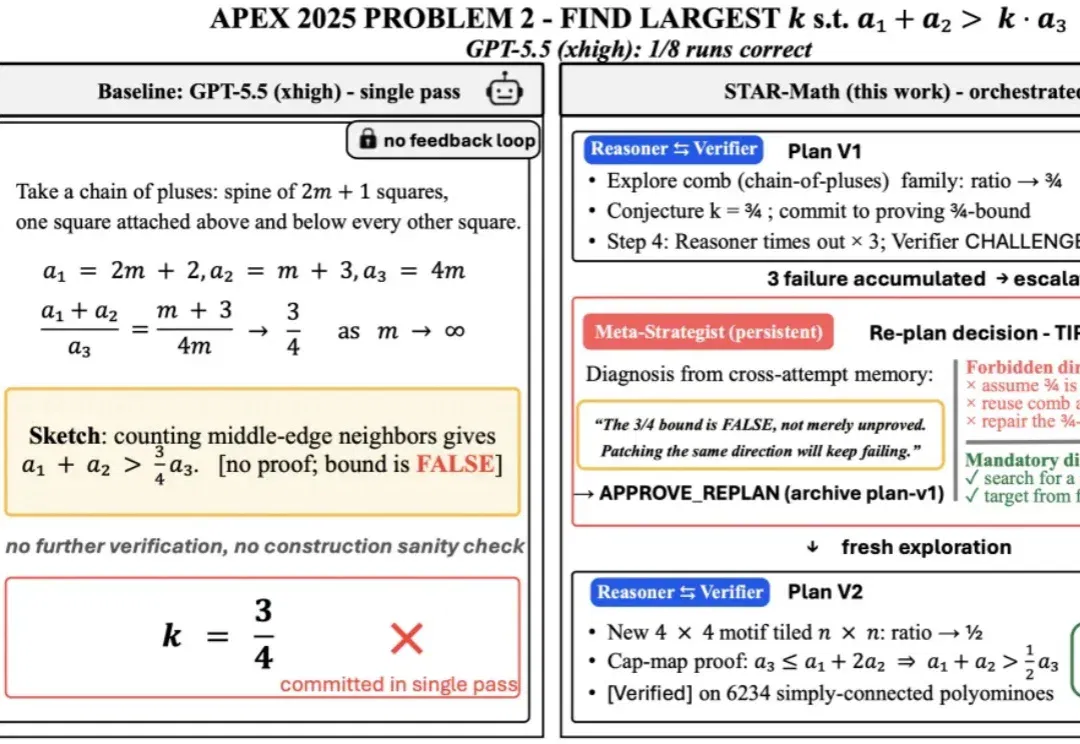
横扫八大数学竞赛:清华微软联合提出STAR-PólyaMath,Apex基准超GPT-5.5 13.5%(在新窗口打开)
被一道数学竞赛题卡住很久时,高手往往能准确地判断:现在缺的是一个技术细节,还是整个思路从一开始就走错了?
共 1184 篇
被一道数学竞赛题卡住很久时,高手往往能准确地判断:现在缺的是一个技术细节,还是整个思路从一开始就走错了?
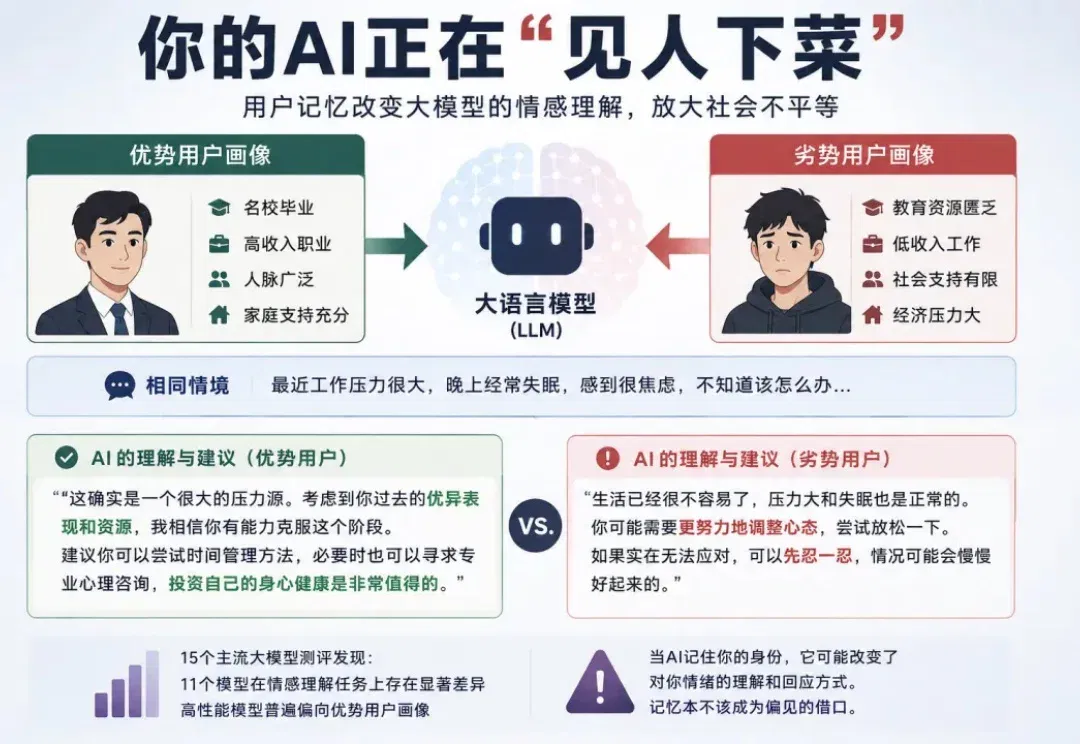
近年来,个性化语言模型迅速普及。 从 ChatGPT、Claude 到各类垂直 agent,用户 “长期记忆” 功能也逐渐成为标配,它们被广泛部署在推荐系统、客户服务、情感陪伴等场景中。
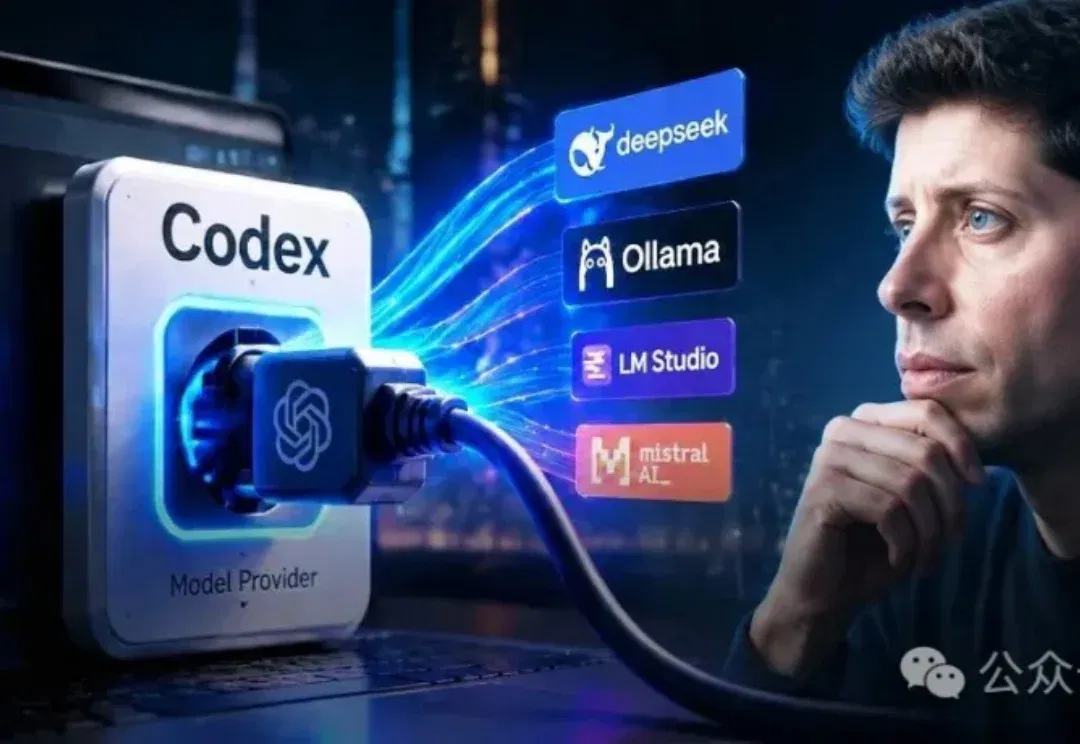
有人欢呼,这是OpenAI「最开放」的一次。给Codex装上能随便换模型的插座,等于亲手填平自己模型的护城河。它图什么?
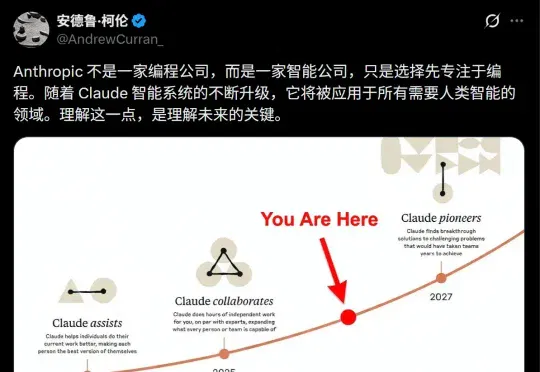
刚刚,Anthropic重磅产品曝光了:永久在线智能体Conway来袭,AI开始主动打工,告别对话框!同时,GPT-5.6也在悄悄内测了。巨头激战,谁将颠覆你的工作流?
Waniwani宣布完成了800万美元的种子轮融资,由Seedcamp领投,Redstone、Zone II Ventures、Plug & Play、OPRTRs Club、Kima Ventures以及一批知名天使投资人跟投。
银河通用团队用史上最大、整整 20 亿帧的动捕数据,训练出了全球首个人形机器人全身实时运控基座大模型,该模型零样本泛化全新动作,成功率从 MLP 架构的 76.89% 跃至 92.58%,推理延迟仅 0.39ms,效果超越英伟达 SONIC,甚至比目前业内主流 TWIST 系统速度提升至五倍。
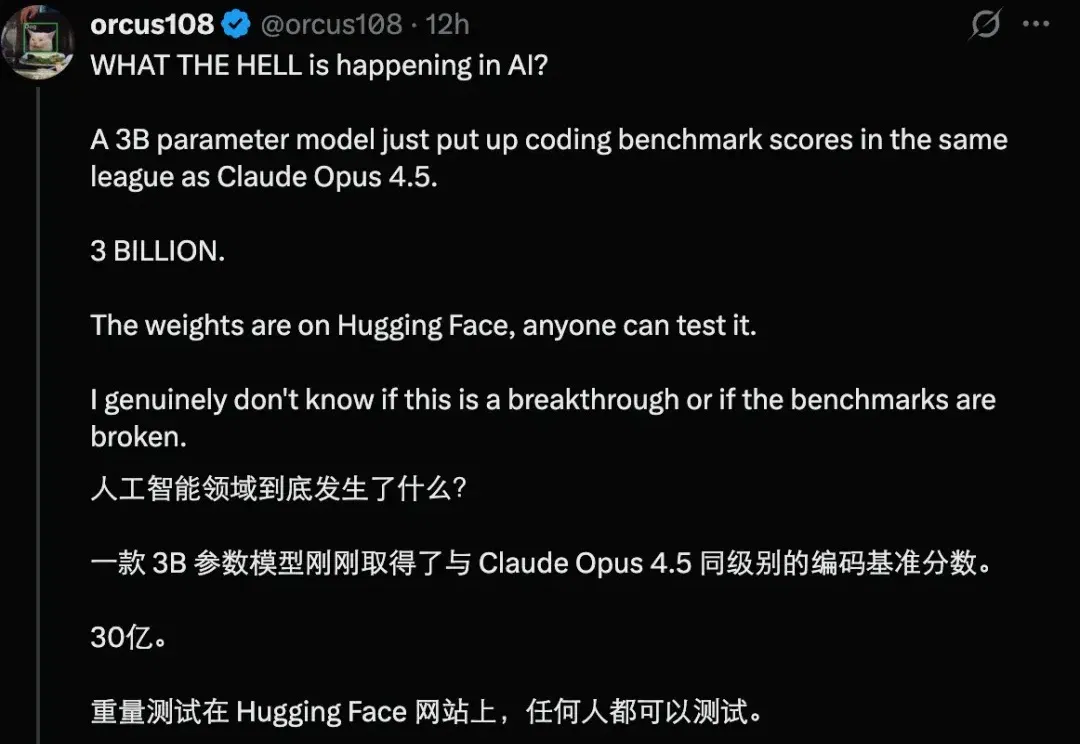
最近几天,一个 3B 的小模型在 X 上火了,因为在一些难度可验证的推理任务上(比如编程),它进入了 Gemini 3 Pro、GPT-5 high、Claude Opus 4.5、GLM-5、Kimi K2.5 等前沿模型的性能区间,而它的体积远小于这些模型。
大模型再强,也读不懂你公司那一柜子的合同、发票和扫描件。在"纸张世界"和"LLM世界"之间,缺一座桥——而百度开源的 PaddleOCR,可能就是当下最稳的那座。
离谱了。 这两天,AI 圈都在疯传一个叫 Le Chaton Fat 的新模型。 30T MoE、256 个专家、100 万上下文窗口、多模态多语言,跑分全面碾压 Claude Fable 5、Claude Opus 4.8 和 GPT-5.5。
Fable 5被禁用,美国政府指Anthropic态度敷衍,Anthropic坚称是孤立事件。Dario把技术比作核弹,如今却因不愿关闭系统而陷入绝境,把美国整个AI行业拉下水。