JoyAgent这个 AI 工作流工具的路子对了(在新窗口打开)
可能很多人还不知道,京东云早就做了类似字节 Coze 这样的产品,并且已经 100% 开源。目前市面上同类产品有不少,京东云 JoyAgent 主打的一个亮点就是它在京东内部的场景中验证过,更贴合企业严肃商业场景的需求。今天,我做个记录,也把操作流程和经验分享给大家。
共 8400 篇
可能很多人还不知道,京东云早就做了类似字节 Coze 这样的产品,并且已经 100% 开源。目前市面上同类产品有不少,京东云 JoyAgent 主打的一个亮点就是它在京东内部的场景中验证过,更贴合企业严肃商业场景的需求。今天,我做个记录,也把操作流程和经验分享给大家。
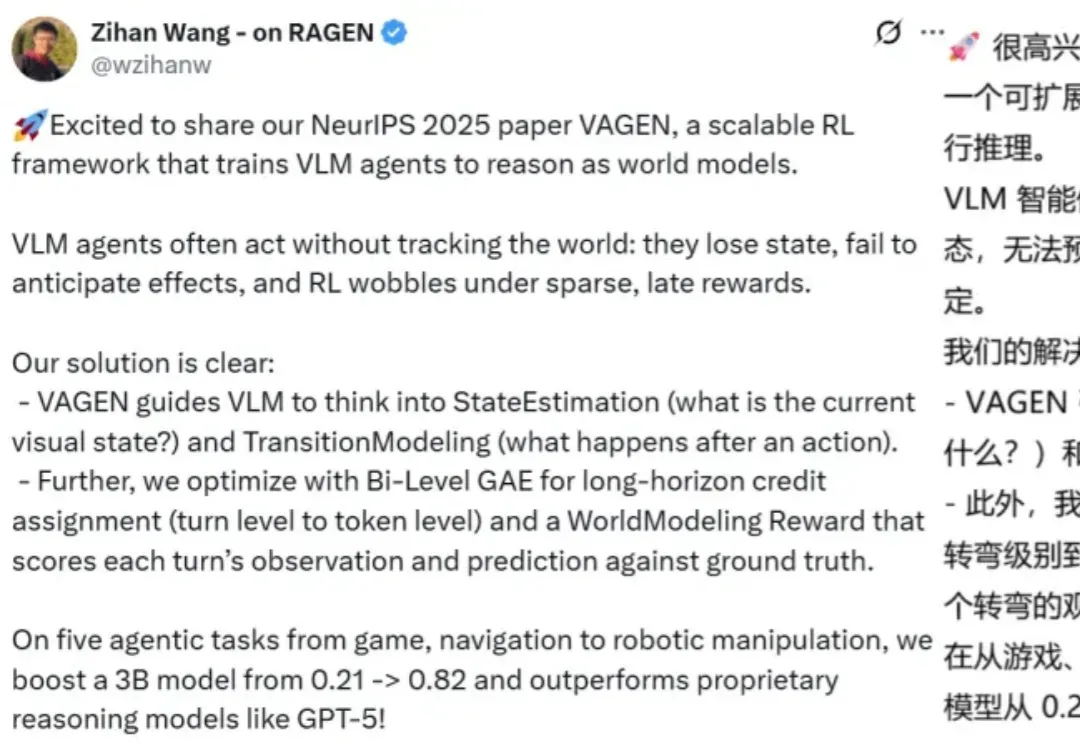
当今的 AI 智能体(Agent)越来越强大,尤其是像 VLM(视觉-语言模型)这样能「看懂」世界的智能体。但研究者发现一个大问题:相比于只处理文本的 LLM 智能体,VLM 智能体在面对复杂的视觉任务时,常常表现得像一个「莽撞的执行者」,而不是一个「深思熟虑的思考者」。
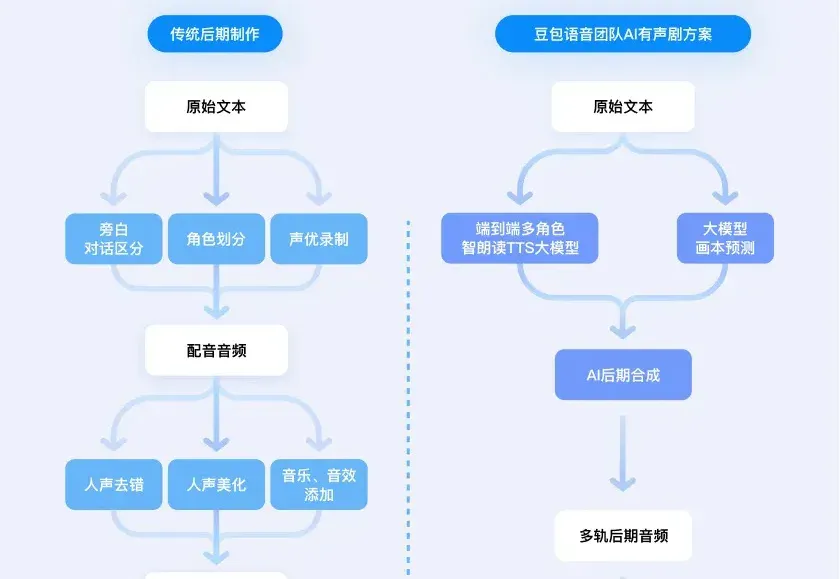
「东州市第一监狱,犯人屠国安被狱警带到了招待室。 门一开,他看到有人背对着他,对方短发,身形纤瘦,姿态挺拔,在他的记忆里,并没有这样的熟人。」
马斯克的终极设想,正在成形。今天,特斯拉放出了「世界模拟器」震撼演示。一个神经网络,每天狂吞500年人类驾驶经验,并在无限的虚拟世界中自我进化。同款AI大脑,擎天柱也可共用。
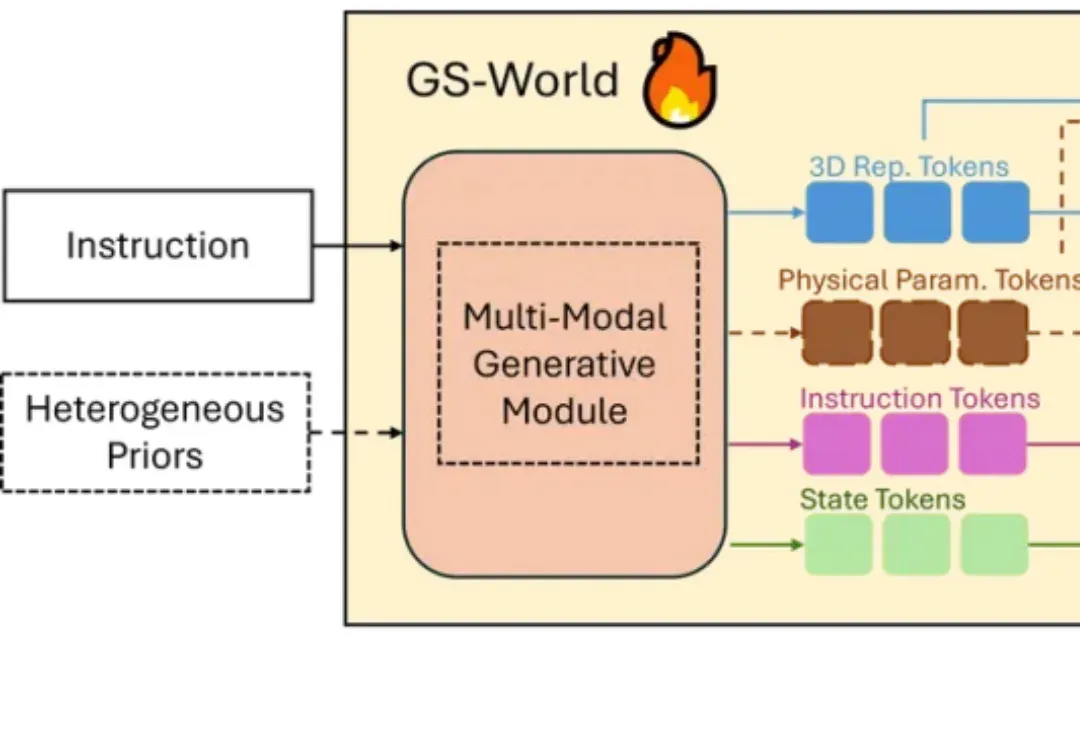
2025 年秋的具身智能赛道正被巨头动态点燃:特斯拉上海超级工厂宣布 Optimus 2.0 量产下线,同步开放开发者平台提供运动控制与环境感知 SDK,试图通过生态共建破解数据孤岛难题;英伟达则在 SIGGRAPH 大会抛出物理 AI 全栈方案,其 Omniverse 平台结合 Cosmos 世界模型可生成高质量合成数据,直指真机数据短缺痛点。
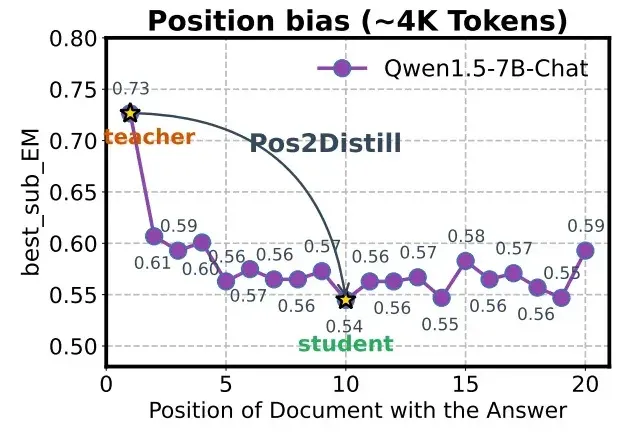
语言模型遭遇严重的位置偏见,即模型对不同上下⽂位置的敏感度不⼀致。模型倾向于过度关注输⼊序列中的特定位置,严重制约了它们在复杂推理、⻓⽂本理解以及模型评估等关键任务上的表现。
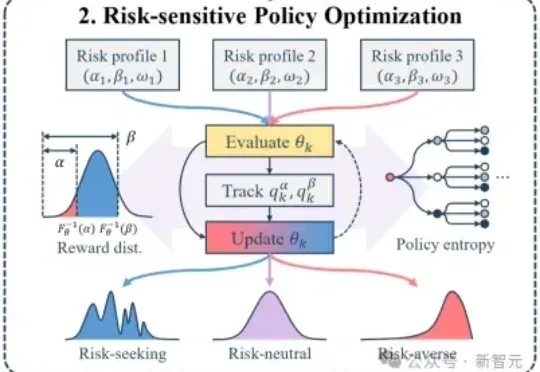
大模型后训练的痛点:均值优化忽略低概率高信息路径,导致推理能力停滞。RiskPO双管齐下,MVaR目标函数推导梯度估计,多问题捆绑转化反馈,实验中Geo3K准确率54.5%,LiveCodeBench Pass@1提升1%,泛化能力强悍。
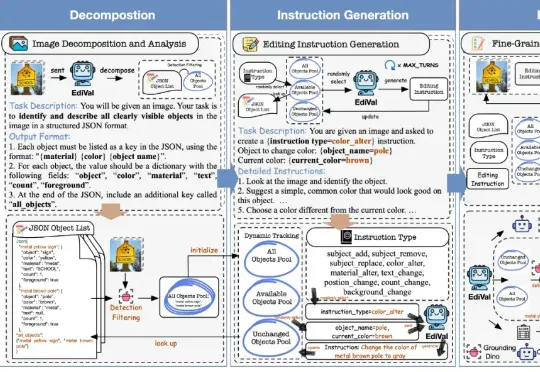
在 AIGC 的下一个阶段,图像编辑(Image Editing)正逐渐取代一次性生成,成为检验多模态模型理解、生成与推理能力的关键场景。我们该如何科学、公正地评测这些图像编辑模型?
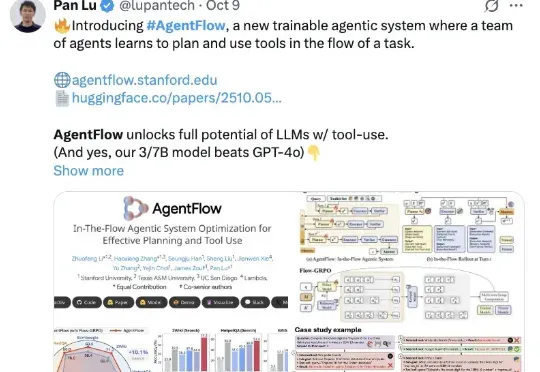
斯坦福等新框架,用在线强化学习让智能体系统“以小搏大”,领先GPT-4o—— AgentFlow,是一种能够在线优化智能体系统的新范式,可以持续提升智能体系统对于复杂问题的推理能力。
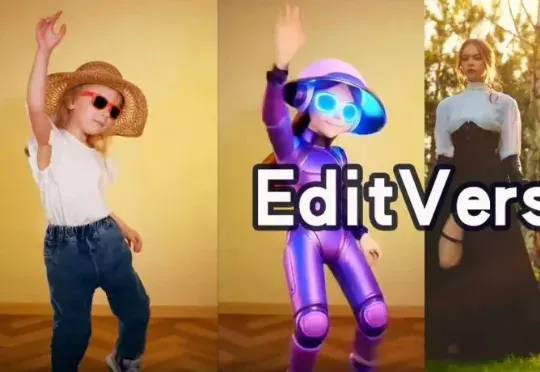
全新AI工具EditVerse将图片和视频编辑整合到一个框架中,让你像P图一样轻松P视频。通过统一的通用视觉语言和上下文学习能力,EditVerse解决了传统视频编辑复杂、数据稀缺的问题,还能实现罕见的「涌现能力」。在效果上,它甚至超越了商业工具Runway,预示着一个创作新纪元的到来。