以「图」破局,HyperOffload定义超节点存储管理新范式(在新窗口打开)
随着生成式 AI 迈入万亿参数时代,大语言模型(LLM)的推理与部署面临着前所未有的“显存墙”挑战。如何在超节点(SuperNode)复杂的异构存储架构下,实现海量张量的高效管理和调度,已成为大模型落地的胜负手。
共 1519 篇
随着生成式 AI 迈入万亿参数时代,大语言模型(LLM)的推理与部署面临着前所未有的“显存墙”挑战。如何在超节点(SuperNode)复杂的异构存储架构下,实现海量张量的高效管理和调度,已成为大模型落地的胜负手。
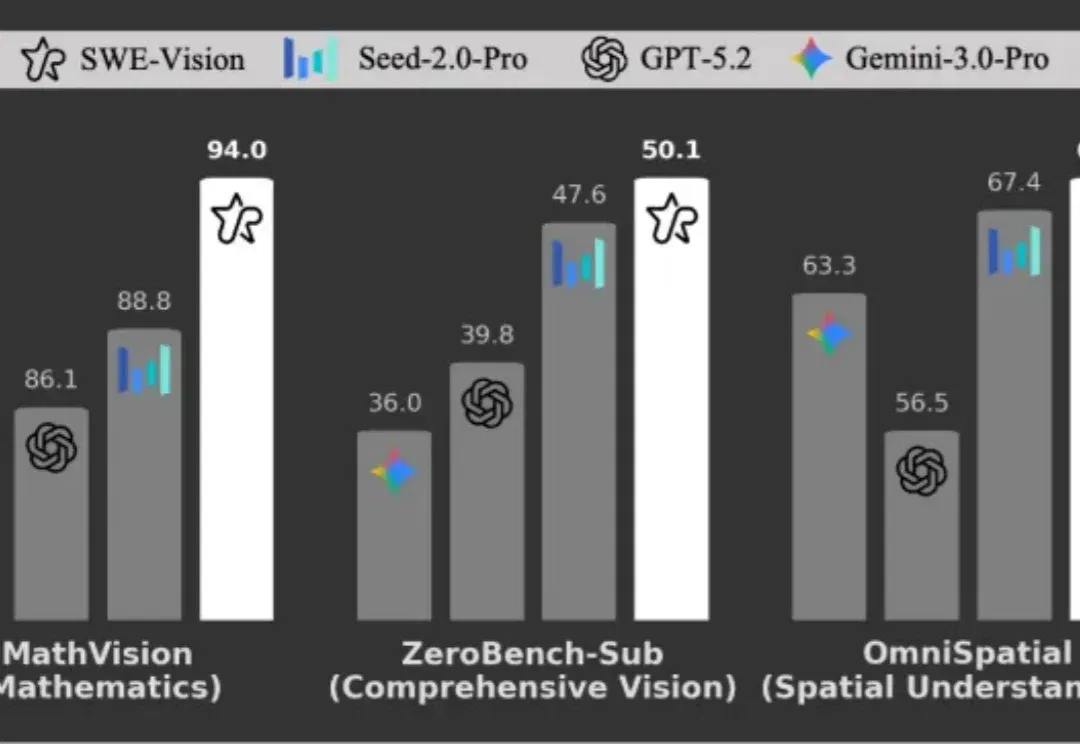
多模态大模型在代码能力上进步惊人,但在基础视觉任务上却频繁失误。UniPat AI 构建了一个极简的视觉智能体框架 ——SWE-Vision,让模型可以编写并执行 Python 代码来处理和验证自己的视觉判断。在五个主流视觉基准测试中,SWE-Vision 均达到了当前最优水平。
在大模型狂飙突进的叙事里,算力是入场券,而那些曾亲手拆解过全球顶级模型“黑盒”、并见证其从阵痛到翻盘的核心人才,才是真正的胜负手。
今天刷到一张梗图,逗得我嘎嘎乐: 这阵子,OpenClaw 把大家搞得很上头,但 token 花钱如流水,月薪两万养不起一只「小龙虾」。 终于,腾讯 基于 OpenClaw 开源生态推出了一键安装版本 ——QClaw,主打简单、零门槛部署,无需准备服务器、无需输入命令行、无需额外配置 IM 工具,下载就能直接用。 咱们普通人也能玩上「龙虾」了。 和 OpenClaw 一样,它可以让人们通过对话聊天的方式操控自己的电脑,无需复杂配置,即可直连 DeepSeek、Kimi、MiniMax 等主流大语言模型。 若选择「自定义大模型」,千问、混元、豆包等也是随便选,但需要提供 API Key。 QCl
LyapLock首次让大模型在上万次知识更新中稳住旧记忆、精准学新知。它用「虚拟队列」实时监控遗忘风险,动态平衡新旧知识,理论保证长期不崩盘,编辑效果比主流方法提升11.89%,还能赋能现有模型,让AI真正学会「持续成长」。
如果你在过去一年关注过大模型训练的技术,大概率听过 Muon 这个名字 —— 这个在月之暗面 K2 模型的相关讨论中走红的优化器,被视为是可能挑战 Adam 的新秀。它的思路很直接:对动量矩阵进行正交化,让各个奇异方向上的更新速率一致,提升训练效率。
这两年,大模型大厂之间堪比军备竞赛。不论开源还是闭源阵营,为了在指标上领先对手,都在疯狂地卷 Scaling Law,卷算力,卷参数量,已经达到了近乎离谱的程度。
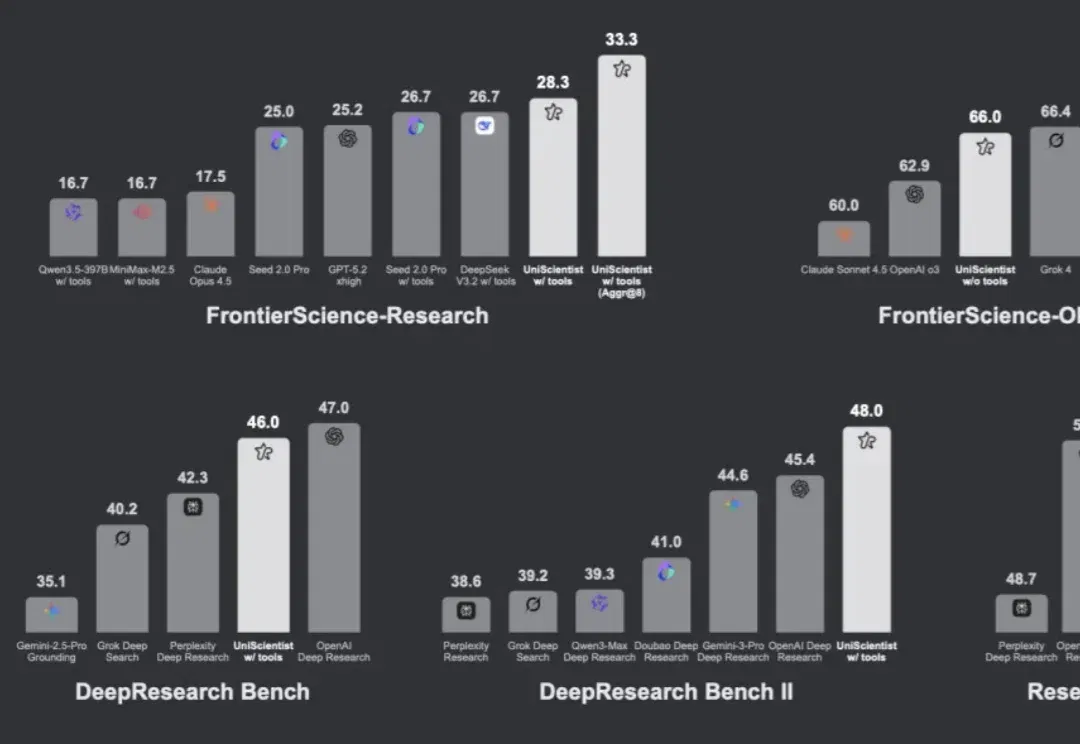
多数大模型能生成 “看起来像” 研究的文本,但极少数能真正做研究 —— 提出假设、收集证据、执行可复现的推导、迭代验证直至结论成立。
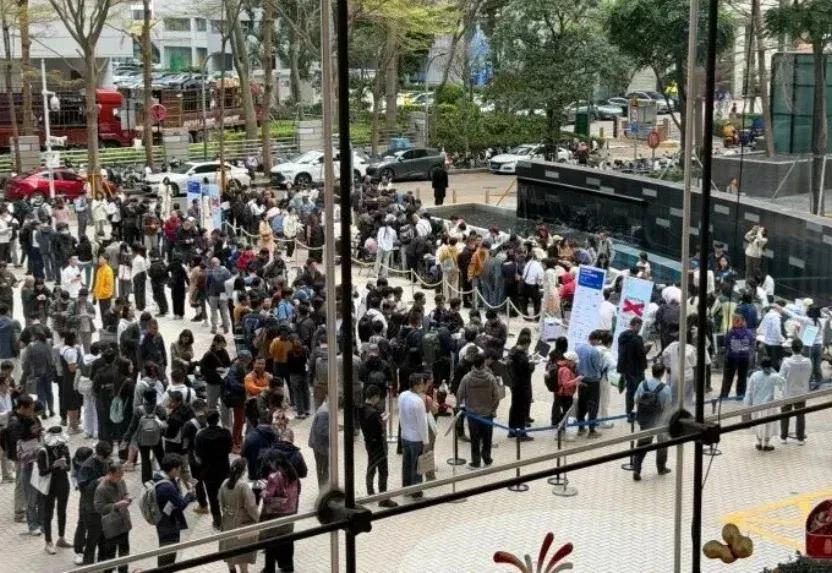
你现在养了几只龙虾? 这就是现在打招呼最常见的问题,上周腾讯深圳总部排起龙等着免费装 OpenClaw,真是一代人有一代人的鸡蛋。 连黄仁勋也盛赞 OpenClaw 为「有史以来最重要的软件发布」,认为它已经证明了 AI 在高度个性化环境中,能够完美复刻人类的复杂工作流。 养龙虾太过火爆,也终于出现专门针对 OpenClaw 的基准测试 PinchBench,用于评估大语言模型在 OpenClaw 任务中的表现。 PinchBench 评分方式也很硬核,有的任务看代码能不能跑通(自动化检查),有的看写得好不好(Claude Opus 当评委),还有的是两者结合。所有题目和答案都开源在 GitH
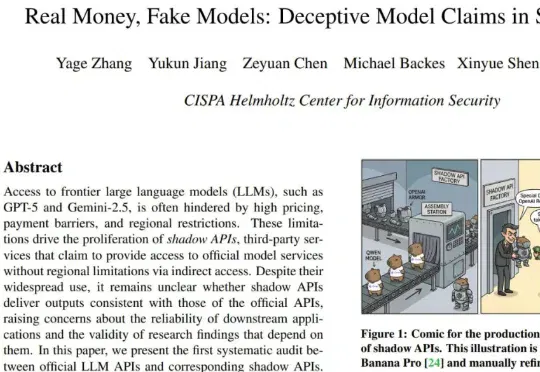
现在,一篇来自 CISPA 亥姆霍兹信息安全中心的最新论文《Real Money, Fake Models: Deceptive Model Claims in Shadow APIs》为我们揭开了一点谜底:那些你花真金白银购买的「第三方 API」,有可能偷偷把前沿大模型换成了廉价的替代品。