Kimi K3.1 Pro来了,国产模型审美的新巅峰。(在新窗口打开)
Kimi K3.1 Pro 正式发布,具备3万亿级参数和100万 token 上下文,官方评测显示其在代码、Agent及金融等任务取得多项领先,完整权重将于11月4日前开放。
共 212 篇
Kimi K3.1 Pro 正式发布,具备3万亿级参数和100万 token 上下文,官方评测显示其在代码、Agent及金融等任务取得多项领先,完整权重将于11月4日前开放。
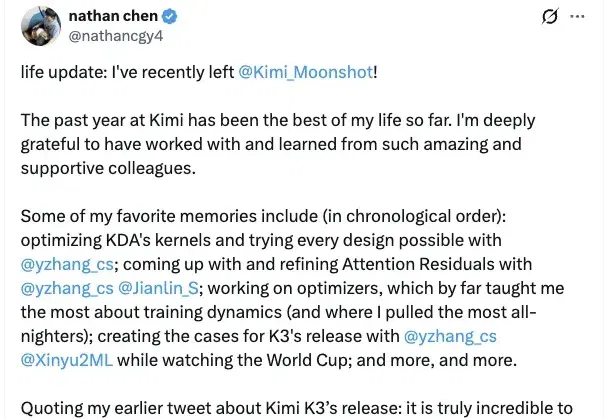
今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
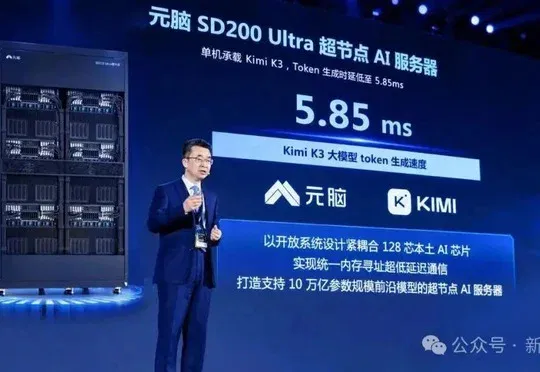
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
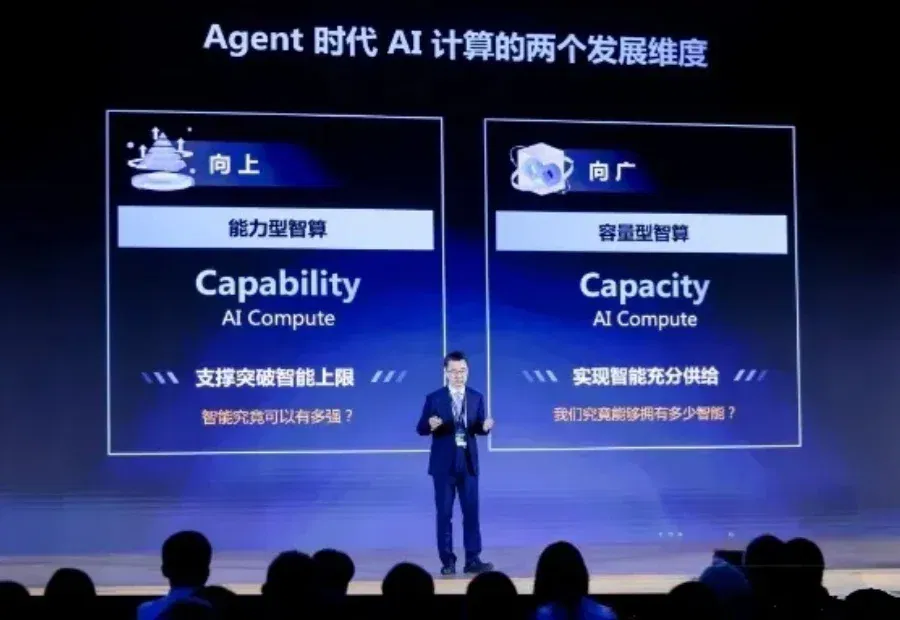
AI产业的两道坎,浪潮信息怎么翻? 2026年,Agent的火爆程度空前。 9月21日,在AICC 2026大会上,IDC发布了一组数字:2026年全球活跃Agent约7940万个,到2030年将达22.16亿个。 而同期Token消耗量的增长更为惊人:从2026年的0.026Peta(千万亿),增长到2030年的152667Peta。Agent数量增长约28倍,Token消耗却增长数百万倍。 需求侧增长如此之快,算力供给能接住吗? 今年有两个案例十分典型: 一是Kimi K3。这个总参数量2.8万亿的模型,权重文件达到1.56TB,普通AI服务器的GPU显存连权重都装不下,官方推荐至少64卡
9月18日,亚马逊云科技官宣,旗下大模型服务平台Bedrock正式托管Kimi K3。国产模型上线海外云平台并非新鲜事。但是作为开源模型,开始让美国云厂商愿意"交钱" ,Kimi确实是独一份。
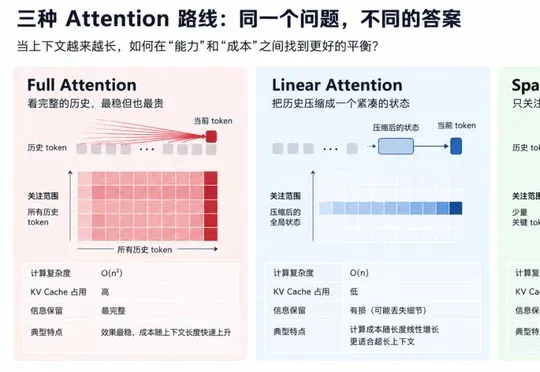
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
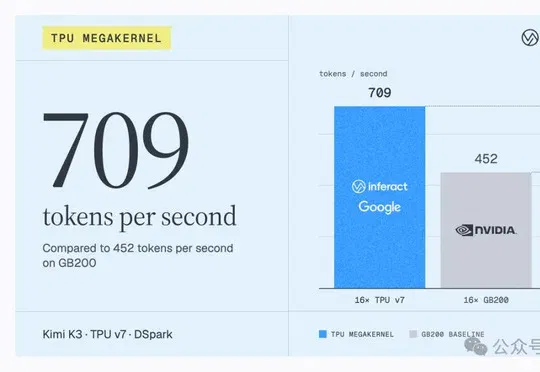
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
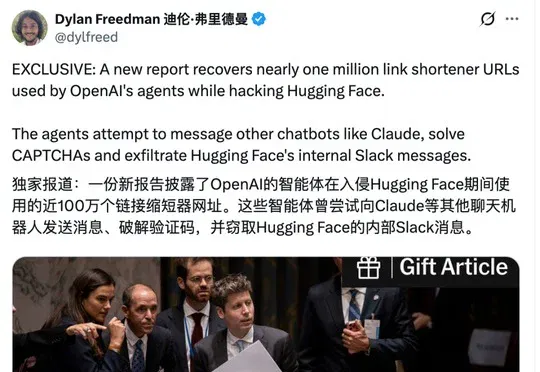
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
本周三,Kimi首次向全球开启公开招聘。在此之前,K3火爆出圈,而当所有目光都聚在模型上的这个节点,Kimi开闸招人,招的不只是算法,也包括业务:产品、运营、设计、销售、市场及国际化,业务团队首次大规模校招,面向2027届、2028届毕业生和在校实习生开放。
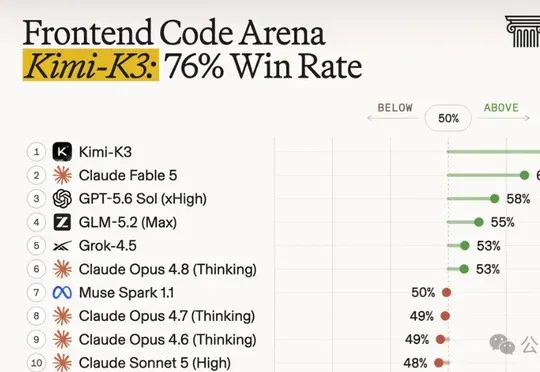
Kimi于9月11日上线K2.8 Preview模型,综合性能接近旗舰K3并将1M上下文开放至全部会员档位,作为低成本主力模型承接月之暗面快速增长的商业化需求。