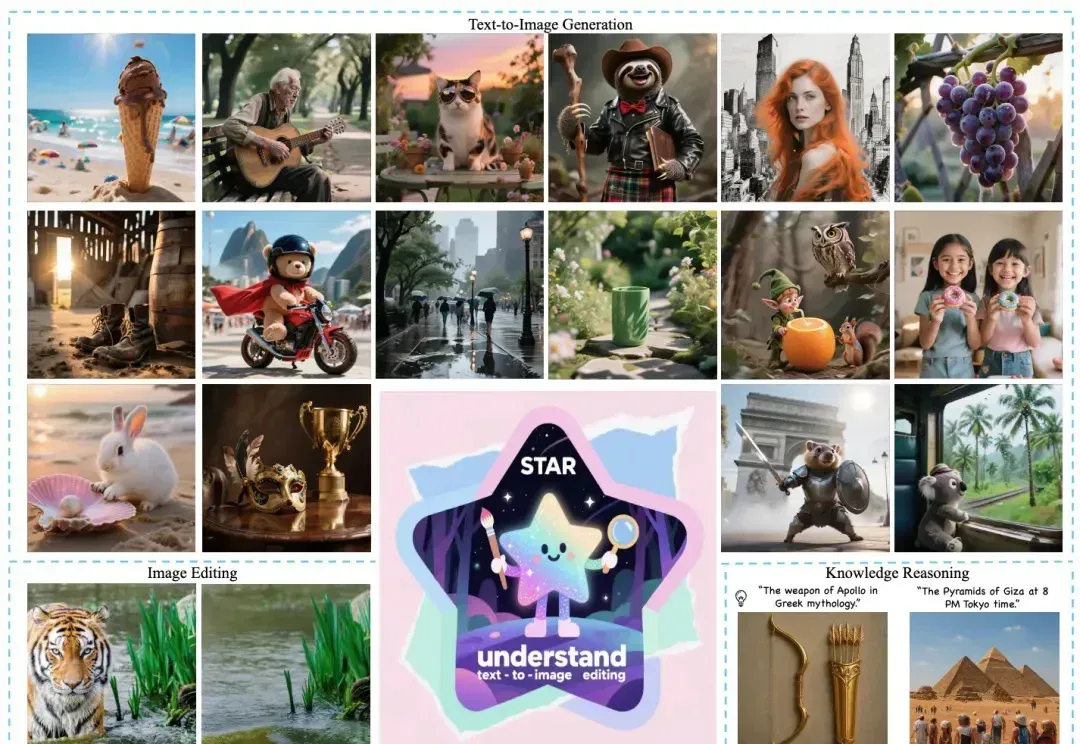
美团提出全新多模态统一大模型STAR,GenEval突破0.91,破解“理解-生成”零和困局(在新窗口打开)
近日,美团推出全新多模态统一大模型方案 STAR(STacked AutoRegressive Scheme for Unified Multimodal Learning),凭借创新的 "堆叠自回归架构 + 任务递进训练" 双核心设计,实现了 "理解能力不打折、生成能力达顶尖" 的双重突破。
共 145 篇
近日,美团推出全新多模态统一大模型方案 STAR(STacked AutoRegressive Scheme for Unified Multimodal Learning),凭借创新的 "堆叠自回归架构 + 任务递进训练" 双核心设计,实现了 "理解能力不打折、生成能力达顶尖" 的双重突破。
提起马卡龙,你会想到什么?是橱窗里的精致甜点,一种“少女心”的味觉象征?还是代表了温柔优雅的时尚配色?当一个AI产品也被命名为“马卡龙”,这份联想便悄然发生了偏移:从舌尖的甜,转向科技的未知,却又奇妙地保留了那一份色彩与气质。
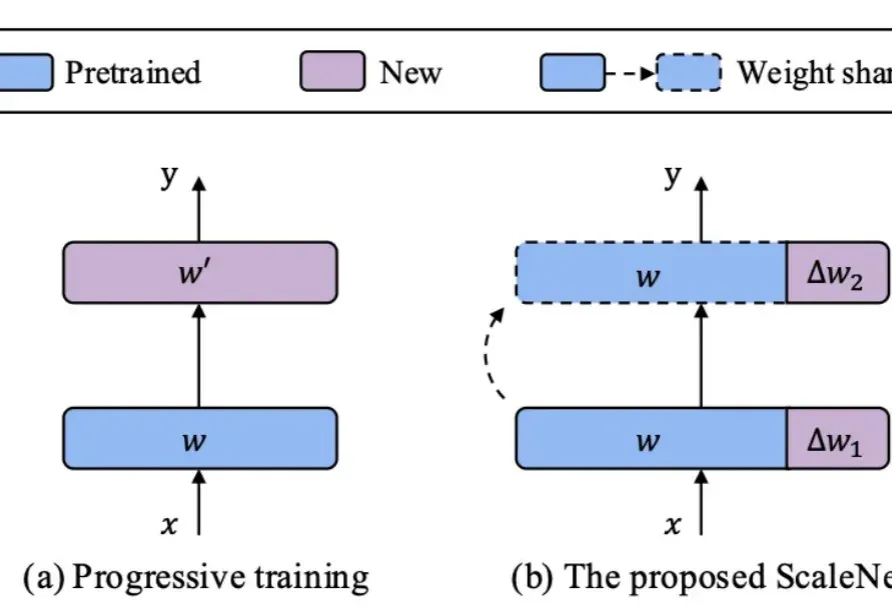
在基础模型领域,模型规模与性能之间的缩放定律(Scaling Law)已被广泛验证,但模型增大也伴随着训练成本、存储需求和能耗的急剧上升。如何在控制参数量的前提下高效扩展模型,成为当前研究的关键挑战。
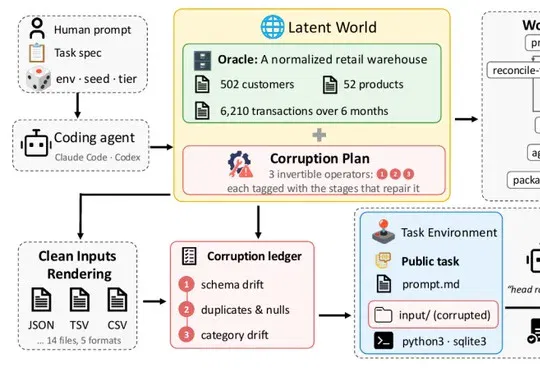
Adobe Research与UCLA提出Tev,构建含1170个环境、覆盖7个领域的Tev-Gym并提出进度势能奖励塑形(PPRS),训练出的Tev-27B在ALE-CM的Pass@5达0.28,与GPT-6 Astra、Claude Opus 5持平。
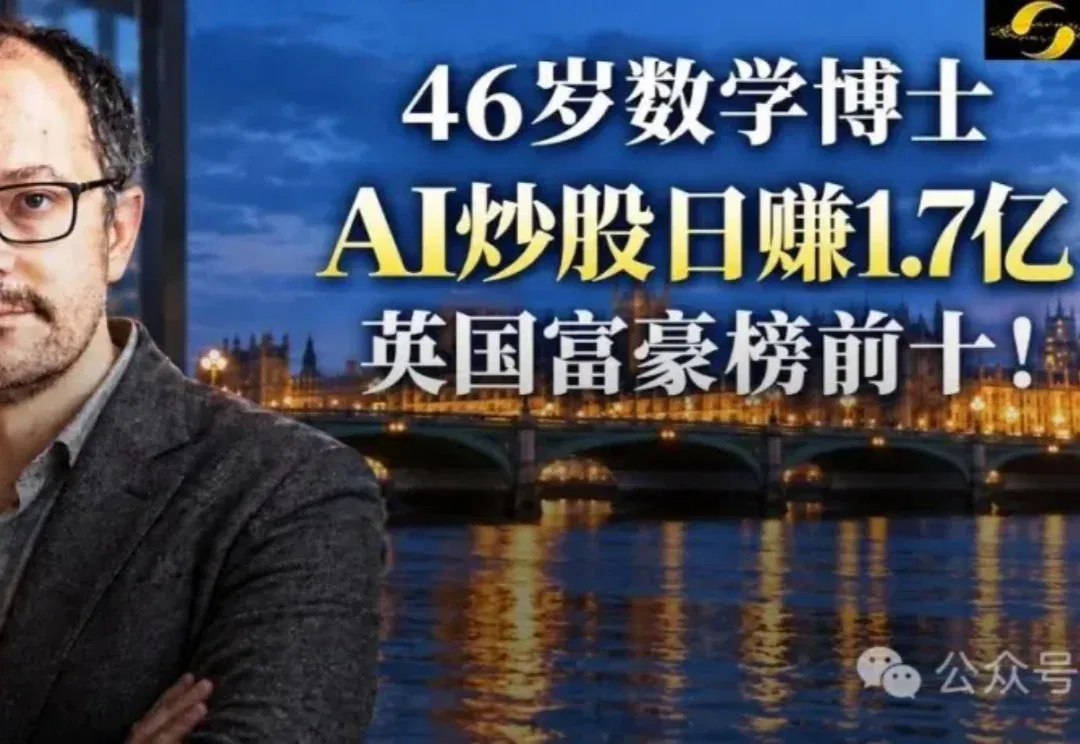
刚刚,用AI最会赚钱的英国人出现了! 据《星期日泰晤士报》最新发布的2026英国富豪榜,46岁的莫斯科国立大学数学博士Alex Gerko,以160.06亿英镑(约1417亿元人民币)的惊人身家,强势杀入英国富豪榜前十,位列第八! 过去短短一年,他的财富暴增了643亿元人民币——相当于平均每天睁开眼,就有近1.76亿元人民币自动划入他的账户。 他的巨额财富,源于其2015年创办的AI量化公司XTX Markets。 这家公司彻底打破了传统华尔街模式,全公司仅有250多名员工,没有任何传统意义上的交易员,也没有任何外部投资者。 他们的「印钞机」,是一个纯AI交易系统,拥有超400PB全球金融市场
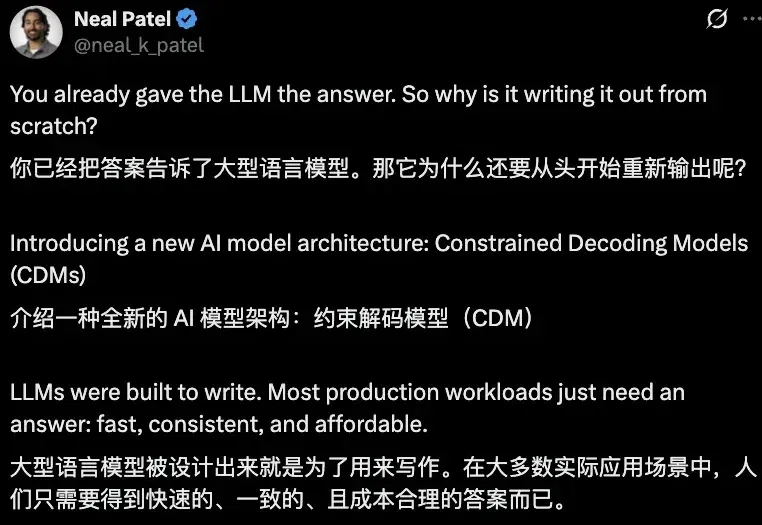
AI圈真是风水轮流转! Jev爆火之后,更多传统NLP技术翻红了。 而且吧,还真有人愿意掏钱。 专门做任务型小模型的创业公司Fastino,此前拿下1750万美元种子轮融资,加上此前的700万美元Pre-seed轮,累计融资约2450万美元。 领投方Khosla Ventures,还是OpenAI的早期投资方。 现在,ScaleDown也来凑热闹了,刚刚全新的CDM约束解码模型架构,一口气上线分类、实体提取、摘要三款模型。 NLP老三样直接组团复出。 相比前沿大模型API,其新模型最高快200倍、成本低467倍,还能处理100万Token的多模态输入。 每百万输入Token只要0.05美元,输
Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
《The Verge》报道,Mercor、Scale AI 和 Surge AI 招募律师、编剧、教师等专业人士生产 AI 训练数据,使劳动者在教 AI 取代原有工作的同时,面临项目骤停、严密监控、降薪和技能被模型掌握后需求消失的困境。
刚刚,奥特曼又曝新料了。在和Salesforce CEO Marc Benioff的对谈中,他亲口剧透了OpenAI内部模型的最新进展。首先,他给出了这样一句判断:「GPT-5.5的水平大概相当于一个普通的数学教授。GPT-5.6,大概能比肩全球排名前1%到2%的顶尖数学教授。」
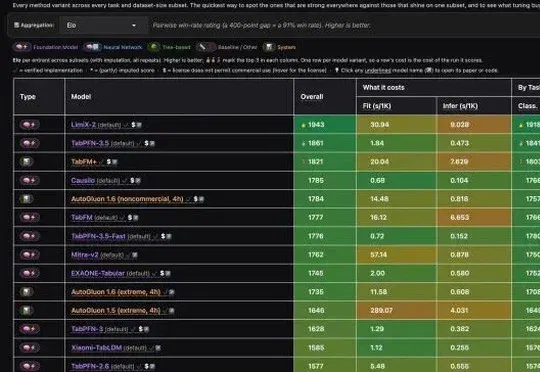
稳准智能团队发布的结构化数据基础模型LimiX-2凭借400M参数在TabArena、TALENT、BCCO等国际主流基准测试中拿下多项第一,断层领先谷歌TabFM、Amazon Mitra及SAP TabPFN-3.5等模型。