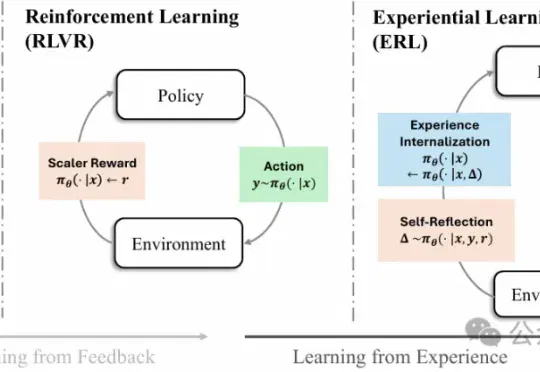
告别纯奖励试错!二次尝试+反思蒸馏,复杂任务提升81%(在新窗口打开)
强化学习已经成为大模型后训练阶段的核心方法之一,但一个长期存在的难题始终没有真正解决:现实环境中的反馈往往稀疏且延迟,模型很难从简单的奖励信号中推断出应该如何调整行为。
共 86 篇
强化学习已经成为大模型后训练阶段的核心方法之一,但一个长期存在的难题始终没有真正解决:现实环境中的反馈往往稀疏且延迟,模型很难从简单的奖励信号中推断出应该如何调整行为。
此事件震动了整个硅谷。虽然此前因为抨击其他 AI 公司「蒸馏」其模型,Anthropic 成为了众矢之的,但目前 Anthropic 在科技界获得了巨大的声援。包括竞争对手 OpenAI、谷歌都公开表态支持 Anthropic 坚守底线的决定。
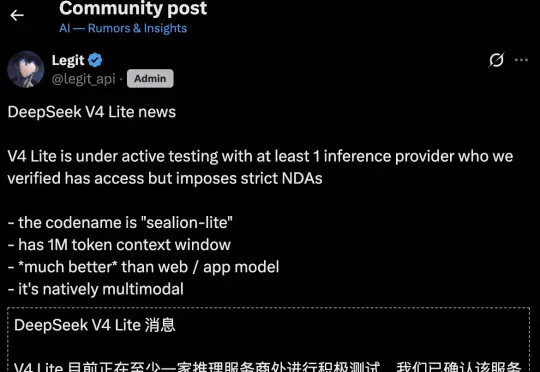
最近,炸裂消息一个接一个。首先,DeepSeek V4将在一周内上线。第二,它跳过英伟达,把访问权限首先给了某国内芯片厂商。另外,Anthropic因为蒸馏事件,也被群嘲了。
今天,美国大模型独角兽Anthropic连续发布多则推文、博客,指控DeepSeek、月之暗面和MiniMax三家中国AI实验室,正对Claude进行“工业级规模的蒸馏攻击”。
今天凌晨,月之暗面核心团队在社交媒体平台Reddit上举行了一场有问必答(AMA)活动。三位联合创始人杨植麟(CEO)、周昕宇(算法团队负责人)和吴育昕与全球网友从0点聊到3点,把许多关键问题都给聊透了,比如Kimi K2.5是否蒸馏自Claude、Kimi K3将带来的提升与改变,以及如何在快速迭代与长期基础研究之间取得平衡。
什么样的思维链,能「教会」学生更好地推理?
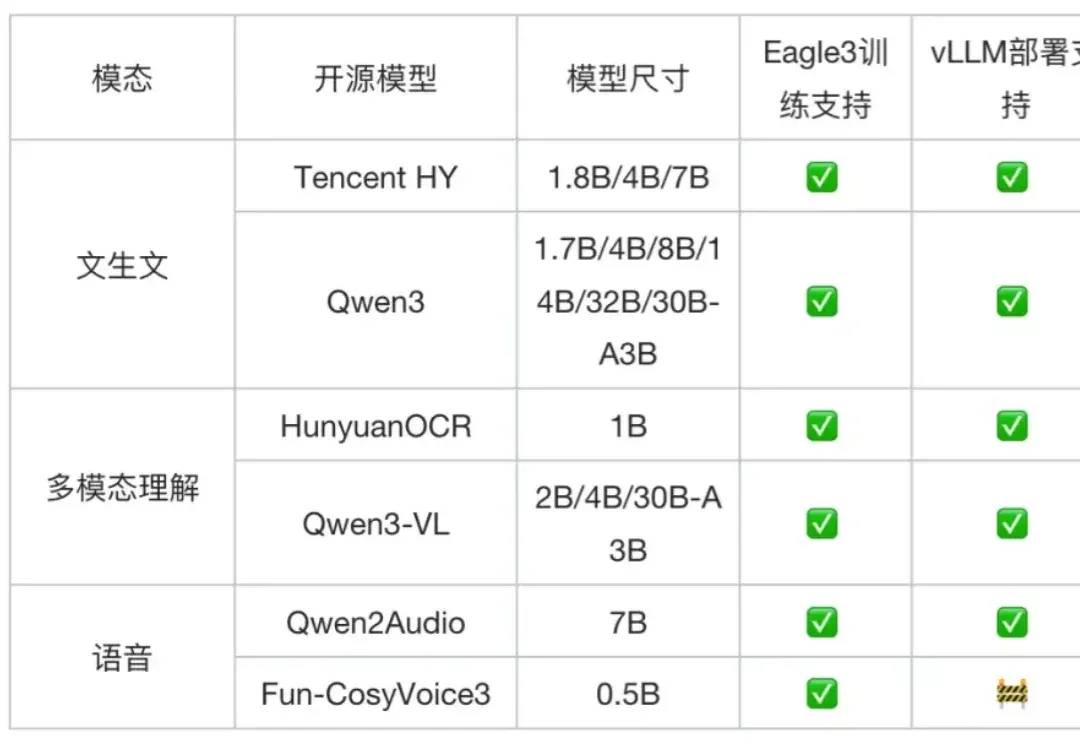
随着大模型步入规模化应用深水区,日益高昂的推理成本与延迟已成为掣肘产业落地的核心瓶颈。在 “降本增效” 的行业共识下,从量化、剪枝到模型蒸馏,各类压缩技术竞相涌现,但往往难以兼顾性能损耗与通用性。
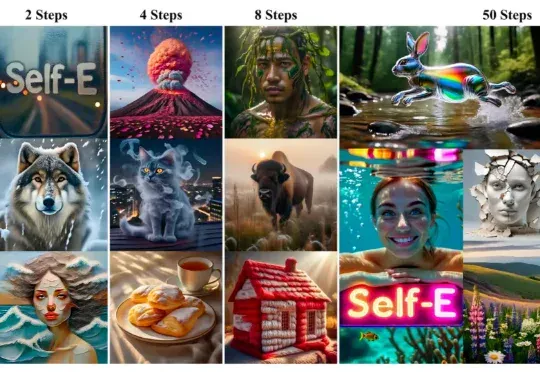
香港大学(The University of Hong Kong)与 Adobe Research 联合发布 Self-E(Self-Evaluating Model):一种无需预训练教师蒸馏、从零开始训练的任意步数文生图框架。其目标非常直接:让同一个模型在极少步数也能生成语义清晰、结构稳定的图像,同时在 50 步等常规设置下保持顶级质量,并且随着步数增加呈现单调提升。
2025年底,最令人印象深刻的AI圈大事莫过于Gemini 3 Flash的发布。
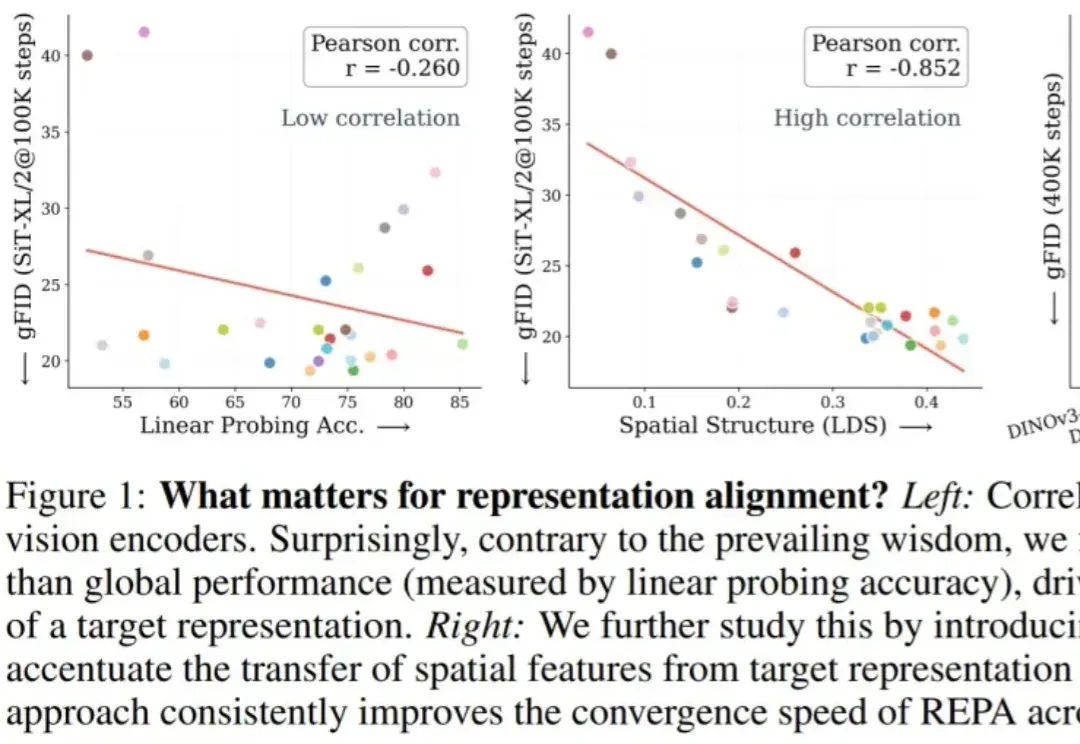
邹忌曾经有一个问题:吾与徐公孰美? 而对于 REPA,也有一个类似的问题:全局信息与空间结构,哪个对表征对齐更重要? 表征对齐(REPA)可通过将强大的预训练视觉编码器的表征蒸馏为中间扩散特征,来指导生成式训练。该方法于去年十月份问世,一直以来都备受关注,已成为加速扩散 Transformer(Diffusion Transformers)训练的一项有力技术。参阅报道《扩散模型训练方法一直错了!谢赛宁:Representation matters》。 但是,其还有一个很基本的问题悬而未决:对生成而言,目标表征的哪个方面更重要?是其「全局」语义信息(例如,以 ImageNet-1K 准确率衡量)