从少样本到千样本!MachineLearningLM给大模型上下文学习装上「机器学习引擎」(在新窗口打开)
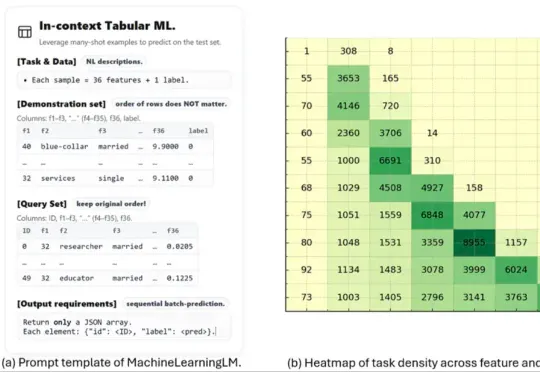
这项名为 MachineLearningLM 的新研究突破了这一瓶颈。该研究提出了一种轻量且可移植的「继续预训练」框架,无需下游微调即可直接通过上下文学习上千条示例,在金融、健康、生物信息、物理等等多个领域的二分类 / 多分类任务中的准确率显著超越基准模型(Qwen-2.5-7B-Instruct)以及最新发布的 GPT-5-mini。
共 348 篇
这项名为 MachineLearningLM 的新研究突破了这一瓶颈。该研究提出了一种轻量且可移植的「继续预训练」框架,无需下游微调即可直接通过上下文学习上千条示例,在金融、健康、生物信息、物理等等多个领域的二分类 / 多分类任务中的准确率显著超越基准模型(Qwen-2.5-7B-Instruct)以及最新发布的 GPT-5-mini。
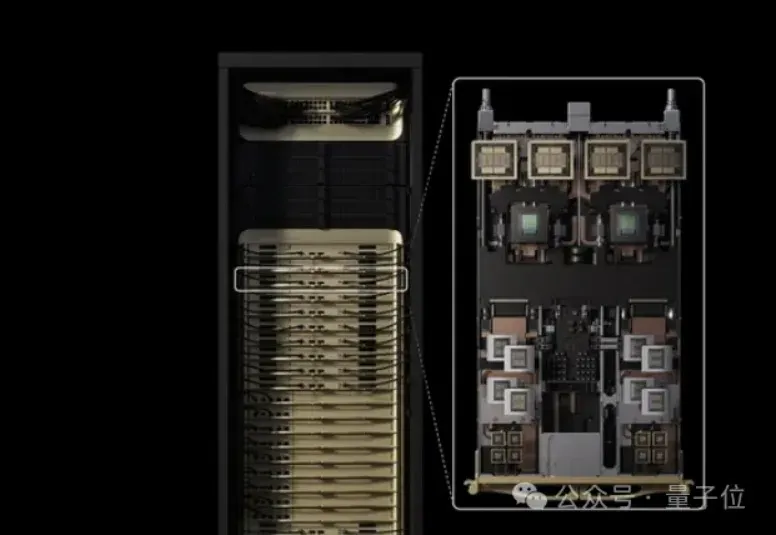
老黄对token密集型任务下手了。 刚刚,在AI Infra Summit上,英伟达宣布推出专为处理百万token级别的代码生成和生成式视频应用的全新GPU—— NVIDIA Rubin CPX GPU。 老黄表示:Rubin CPX是首款为超大上下文AI量身定制的CUDA GPU,可以让模型“一口气”推理数百万token。 而且,RubinCPX还能让你越用越省钱:每投资1亿美元,就能获得50亿美元的token收益。(50倍,你就赚吧,老黄说的) 对于“老黄画的饼”,Cursor、Runway、Magic等行业大佬也表示RubinCPX将分别在代码生产力、生成式影像创作、以及大模型自主代理上
刚刚,马斯克xAI加入Coding战局:推出智能编程模型Grok Code Fast 1。Fast写进名字里,新模型主打的就是快速、经济,且支持256K上下文,可在GitHub Copilot、Cursor、Cline、Kilo Code、Roo Code、opencode和Windsurf上使用,还限时7天免费!
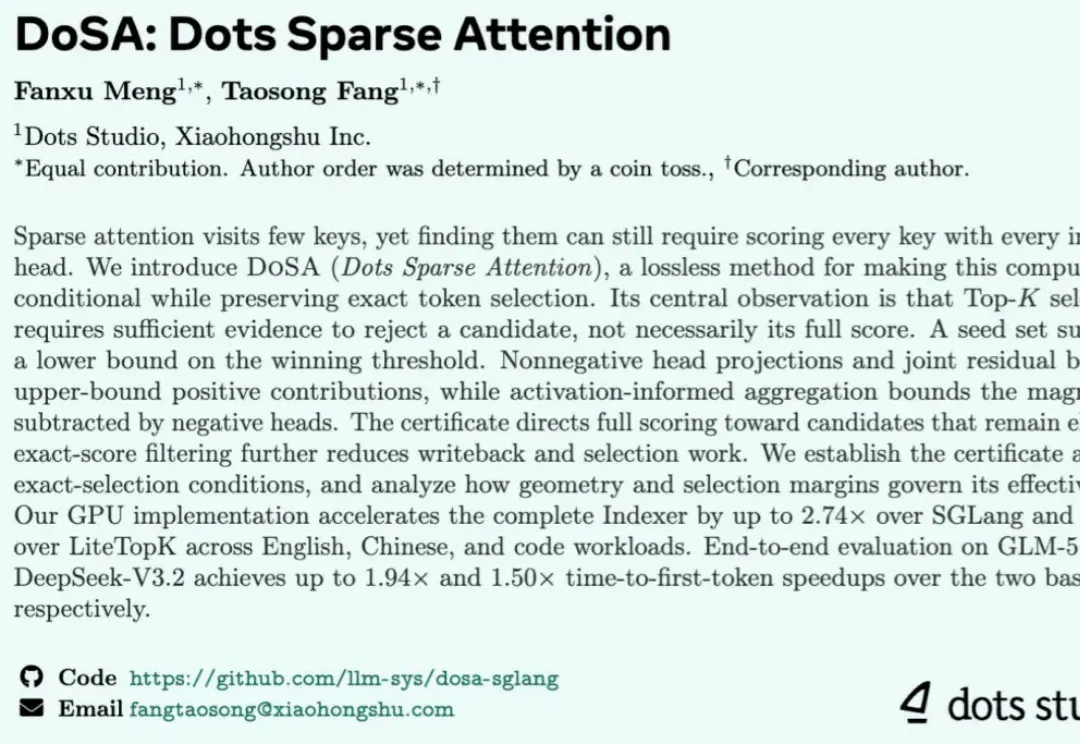
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
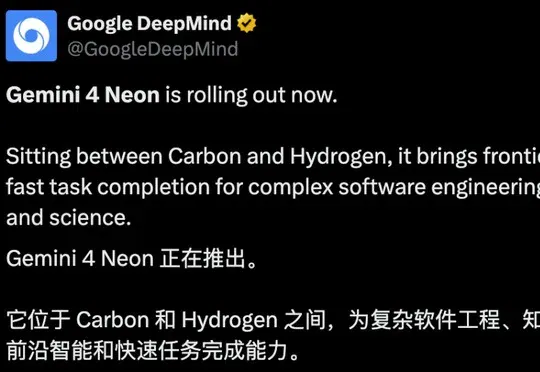
谷歌介绍兼顾效率与复杂任务的Neon,公布百万Token上下文和API定价,并扩展Project Genie交互体验。模型分批上线,网络安全版本及Genie访问均有资格与开放范围限制。
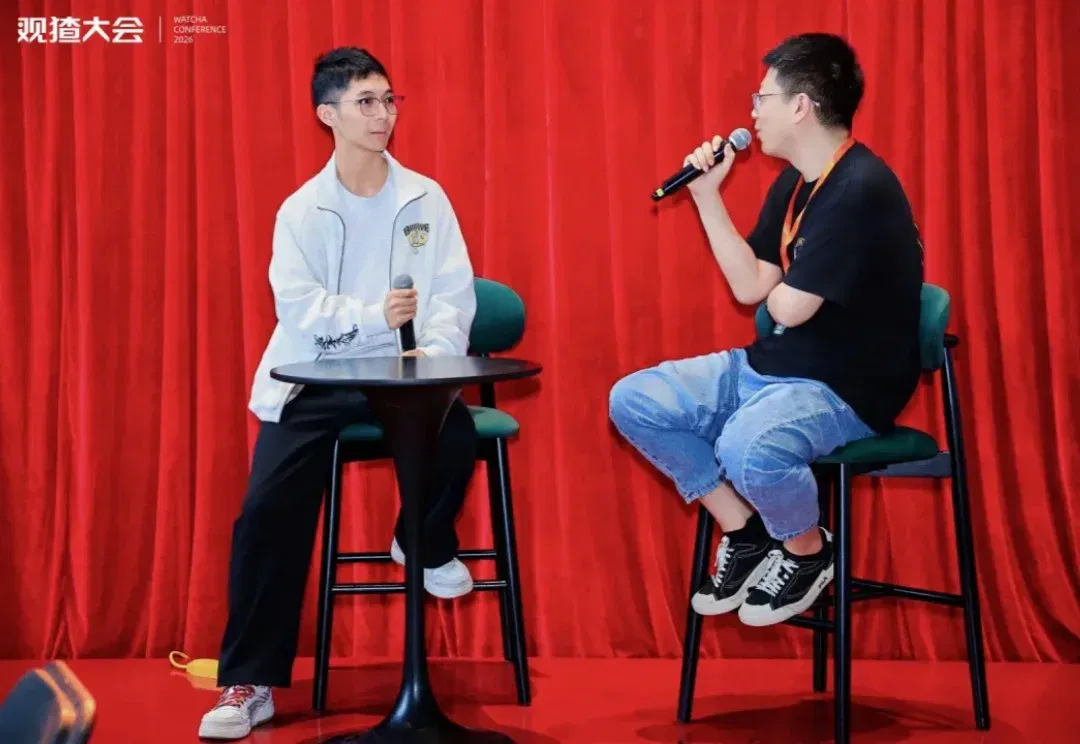
MiniMax Code负责人Ronny分享内部使用、上下文管理与工具编排经验,并讨论Personal Agent的协作与任务管理方向。95%代码和15%效率等数字为团队口径,未来形态属于其判断。
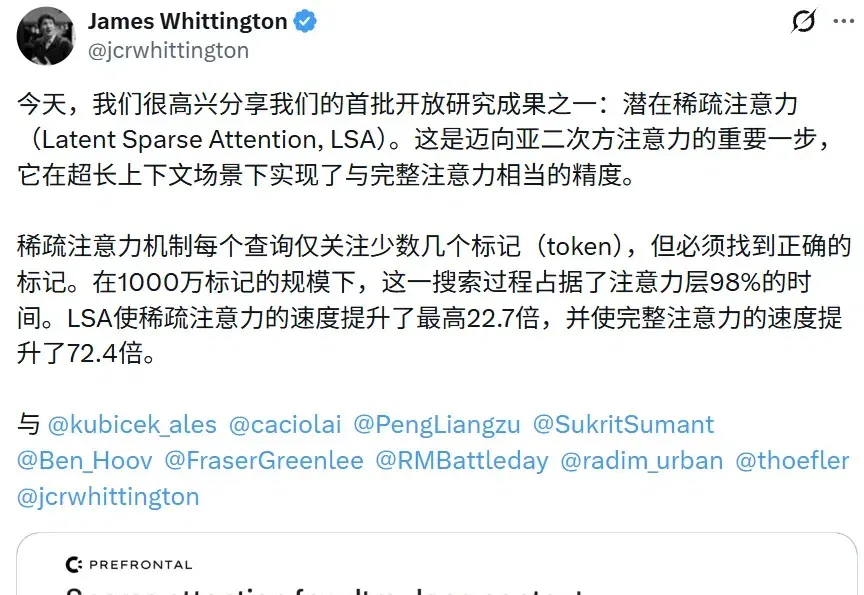
Prefrontal AI与ETH团队提出隐空间稀疏注意力,以聚类和层次索引筛选历史Token。论文区分单层计算与整模型首Token时间,22.7倍对应GLM指定注意力层的测试结果。
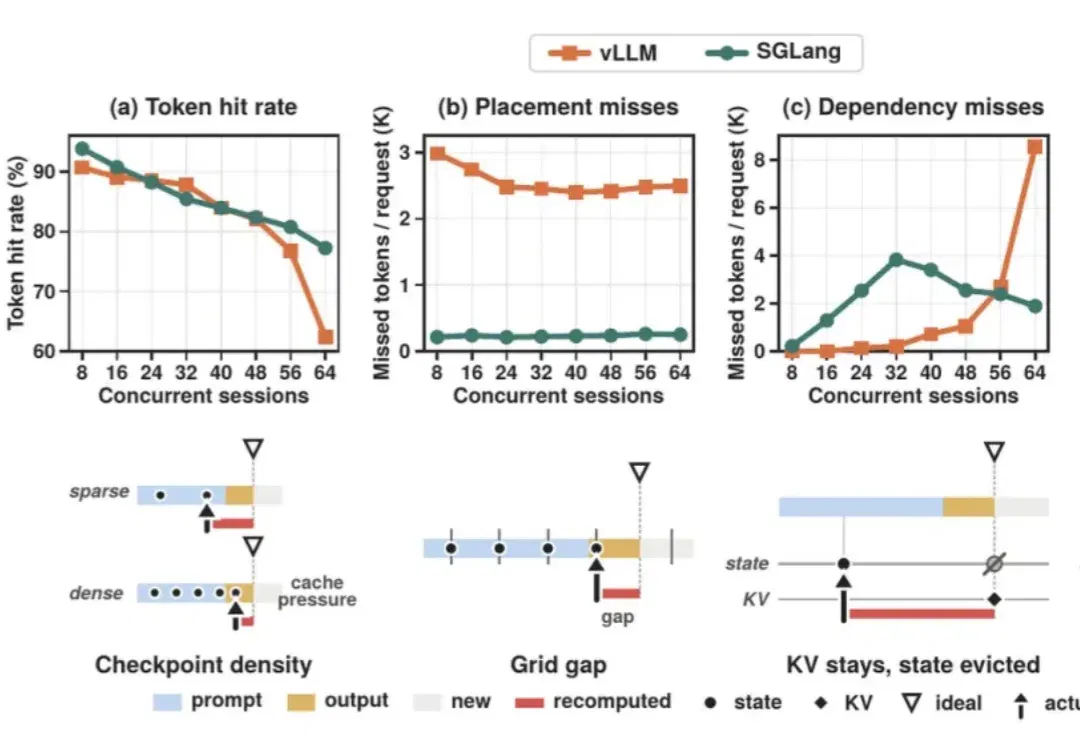
FlashStates针对KDA、GDN和Mamba等混合架构,联合管理递归状态与KV缓存。团队在B200及长上下文工作负载中测试了前缀复用、预填充速度和分层缓存收益。
报道介绍架构、百万Token上下文及长程交付案例。Work360与AII上的成本降幅不同,复杂开放任务仍有短板,中小模型待后续开放。
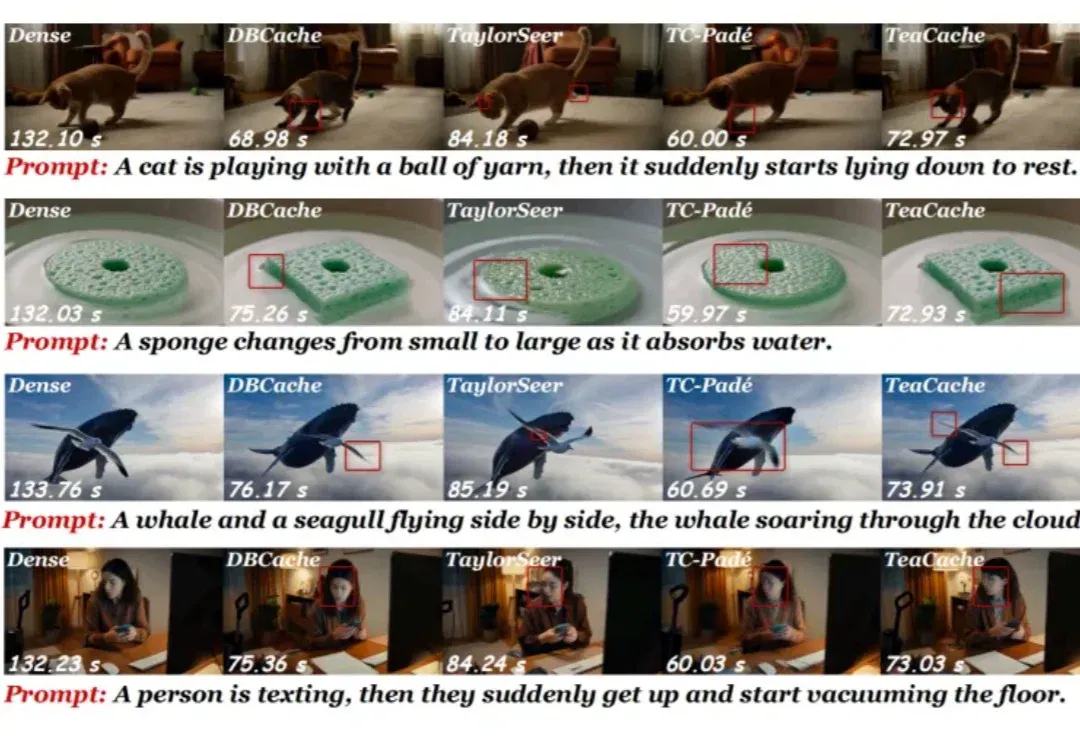
公司在发布测试中报告视频推理相对Dense平均2.48倍加速,并介绍显存调度、素材理解和生成上下文衔接方案。