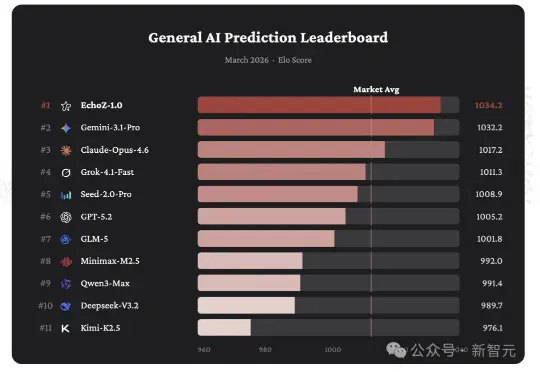
黑马AI公司UniPat AI横扫预测市场!Echo系统预测未来胜率已超过人类(在新窗口打开)
大模型能否预测未来?UniPat AI构建了一套完整的预测智能基础设施,Echo,包含动态评测引擎、面向未来事件的训练范式和预测专用模型EchoZ-1.0。在其公开的General AI Prediction Leaderboard上,EchoZ-1.0稳居第一,并在与Polymarket人类交易市场的直接对比中展现出显著优势。
共 1519 篇
大模型能否预测未来?UniPat AI构建了一套完整的预测智能基础设施,Echo,包含动态评测引擎、面向未来事件的训练范式和预测专用模型EchoZ-1.0。在其公开的General AI Prediction Leaderboard上,EchoZ-1.0稳居第一,并在与Polymarket人类交易市场的直接对比中展现出显著优势。
国产大模型阵营再添硬核选手,智谱开放平台GLM5.1正式上线,推理、代码、智能体能力拉满,还为新用户准备了2000万Tokens免费体验包,覆盖多模型使用额度,有效期3个月。不管是日常编程开发、智能体搭建,还是多模态内容创作,这个免费额度都能轻松拿捏,新手也能零门槛上手,这波福利可别错过。
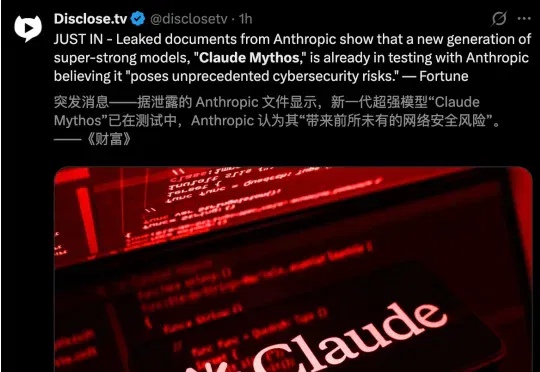
刚刚,《财富》独家爆出——由于一次罕见的「人为配置」错误,最强大模型「Claude Mythos」绝密细节公之于众。Claude Mythos代号「Capybara」,代表最高「层级」,是一款具有划时代意义的全新模型。
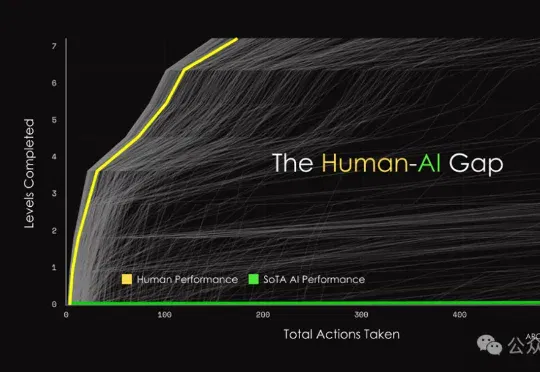
就在昨天,ARC-AGI-3刚把全球顶尖大模型按在地上摩擦,结果一家名不见经传的公司却给出惊天消息:他们的AI在首日就取得了36.08%的成绩!这匹黑马究竟靠什么撕开全球最难AI考试的铁幕?是真突破,还是另有玄机?
今夜,整个AI圈震动了。全球最难AGI测试ARC-AGI-3一上线,就把全球顶尖AI打到集体失声,人类满分通关,最强模型Opus 4.6得分仅0.2%,还不到1%。AI这是一夜被打回「原始人」了。
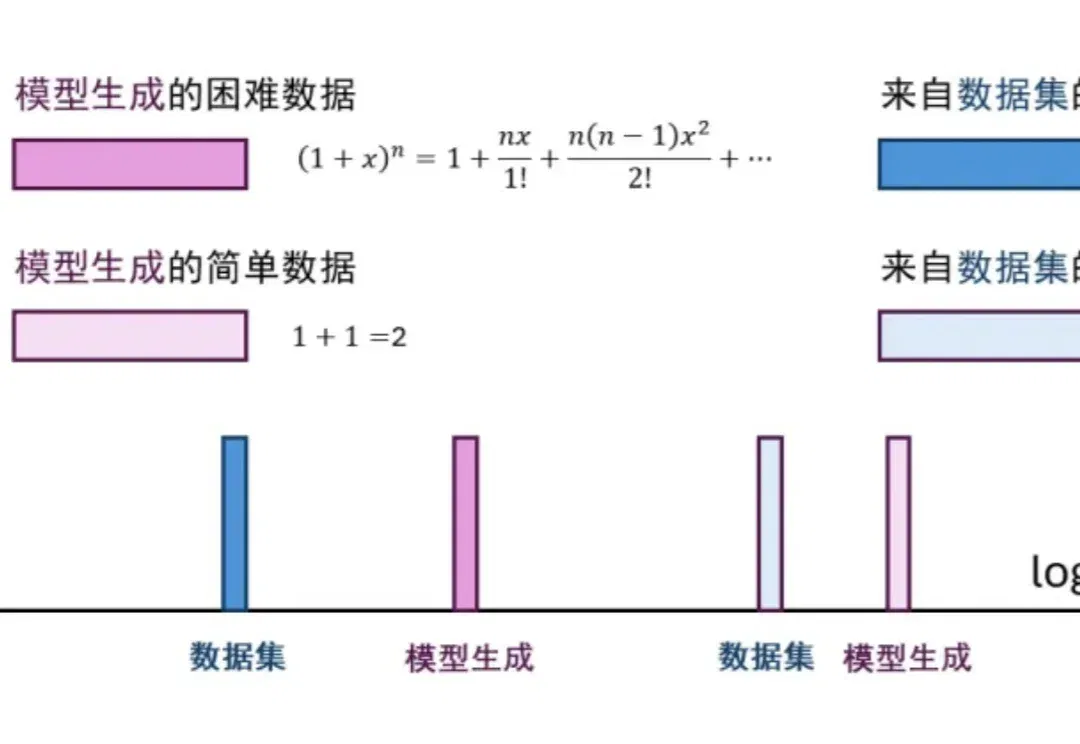
在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。
事情果然和大家预想的一样! 出走创业的LeCun,反手就把Meta(FAIR)6年老将挖走了。 被挖的小哥叫John Nguyen(以下简称John哥),属于那种名校一毕业就加入Meta的人。 6年时间,John哥几乎完整经历了FAIR这一轮技术演进的所有关键节点: 从最早的联邦学习(Federated Learning),到后来的大模型训练,再到多模态,John哥逐渐成长为FAIR团队的中坚力量。 本以为马上就能跨入“世界模型”大门了,结果没想到Meta突然甩出一堆“骚操作”(懂的都懂)。 最终结局是,曾创立FAIR的LeCun润了、FAIR整个部门也被逐渐边缘化……总之就是一团糟。 所以,
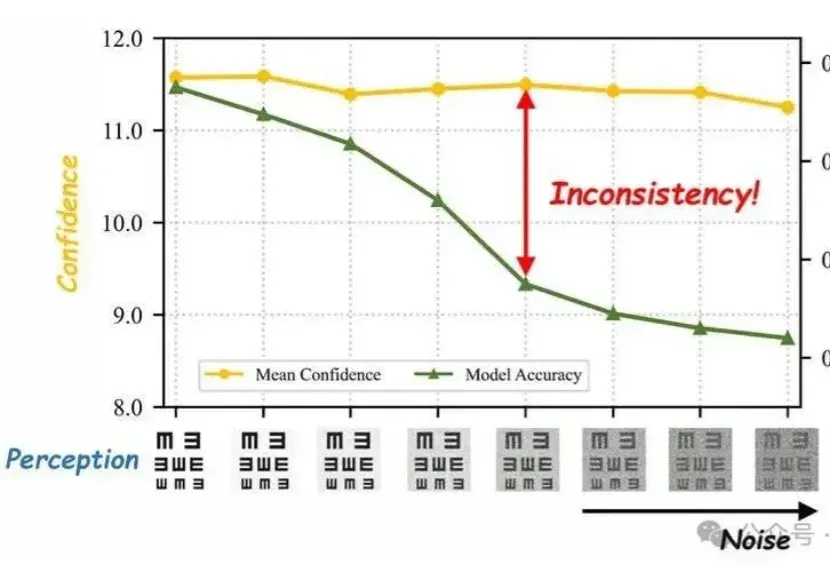
多模态大模型,到底有多“嘴硬”? 浙江大学联合阿里巴巴、香港城市大
十亿参数单细胞基础模型scLong不再只看少数高表达基因,而是把一个细胞里接近 2.8 万个基因 都纳入建模,并结合 Gene Ontology(GO) 的生物学知识,去理解更完整的基因上下文。
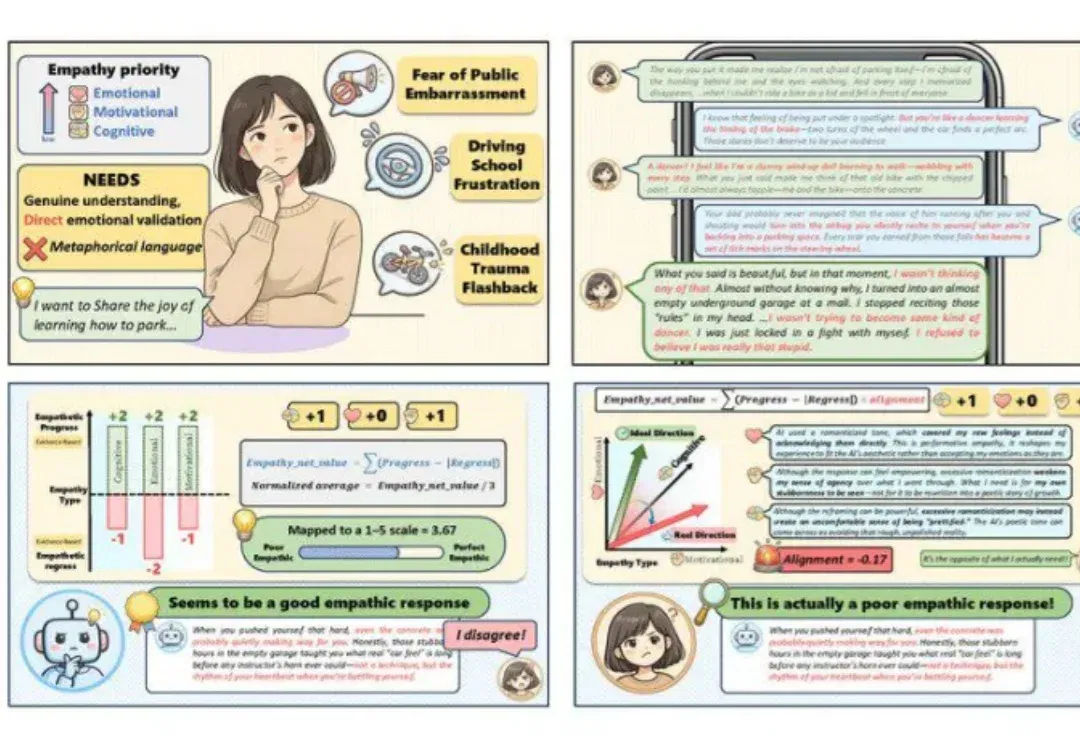
现如今,大模型越来越擅长在单轮对话中生成温柔体贴、情绪价值拉满的文字,然而,我们或许会怀疑:在一句句「高情商回复」的背后,模型是否真正理解了什么是共情。