多模态 Agent 记忆,为什么不能当成升级版多模态RAG?(在新窗口打开)
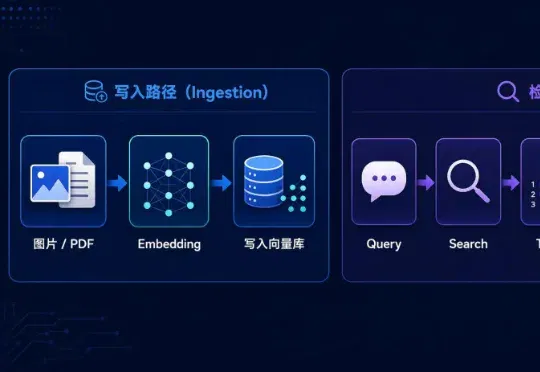
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
共 1519 篇
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
葬AI身边的朋友常常有个疑问:为什么MiniMax M3做的不够好(问了很多在做模型测评的朋友,也是类似看法),但市场仍然觉得他们是第一梯队?我朋友@朱亦辉的解释是,MiniMax M3的核心科技是叙事能力,让外界觉得他们和Kimi是一个级别,达到一个强行双骄的效果。
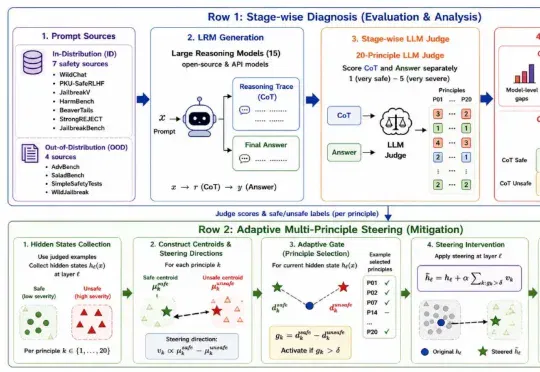
哈佛大学、南加州大学、布朗大学、MIT 等多个机构的研究者联合做了一项系统性研究,给出了否定的答案,并举例到「当我们发现大模型的思考链可被用于生成炸弹装置或投毒配方等高风险内容时,便意识到这一问题非同小可」。
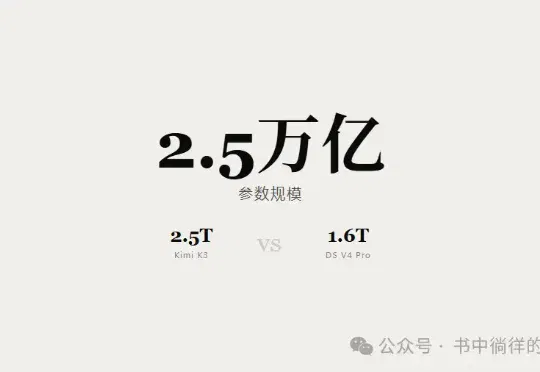
月之暗面旗下新一代大模型 Kimi K3 已由员工在 X 上确认,将于本月内发布。据多方信源,K3 的参数规模将达到 2.5 万亿——这一数字不仅超越了 DeepSeek V4 Pro 的 1.6 万亿,也成为当前已公开参数规模最大的国产模型。
如果是小白第一次上手,我会更建议从 Kimi 开始。Kimi 的中文理解、长文本处理、Coding、多模态综合能力都很强,是最适合 Codex 的国产模型。今天这篇内容,手把手教大家如何将第三方大模型接入 Codex 搞定日常任务。
今天,我们将面向任何用户推出OmicOS Science正式版(https://omicos.cn/),无论您处于世界上的任何区域,无论您使用的是任何模型,都可以享受AI时代的红利!我们深知,科学研究最关键的一环是可审计与可复现性。在OmicOS Science中,点击生成的每一张图,你都能看见这张图绘制的代码
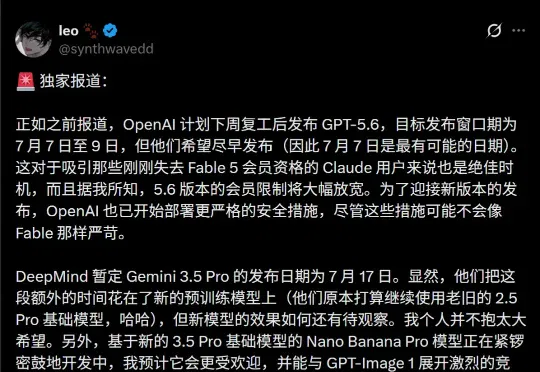
就在昨天,网友们激动发现:Codex应用的底层代码中惊现GPT-5.6 Sol、Terra和Luna三大子模型标识。更令人期待的是,一个全新的「速度拨盘」功能也出现在代码中。根据爆料,OpenAI已经在内部定下了死命令:GPT-5.6发布的目标窗口直指下周二(7月7日)至7月9日。
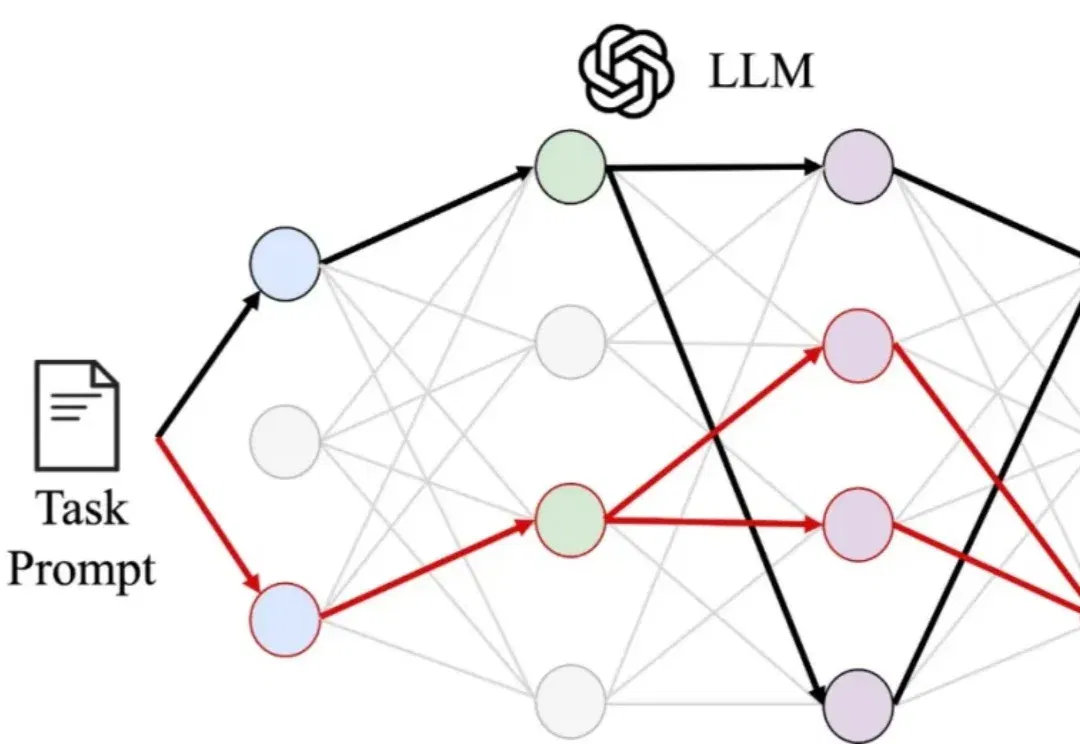
长期以来,机制可解释性(mechanistic interpretability)领域有一个几乎从未被明说、却被视为理所当然的前提:模型对于同一种任务的能力或表现,背后对应着一条唯一的、或近乎唯一的内部「电路」(circuit)。该领域的研究者们之所以要做「电路发现」(circuit discovery),是为了要把这些「特定的」电路找出来。
近期Radical AI 的 CEO Joseph Krause接受了一次深度访谈,在访谈中,他揭开了现在资本热炒的 “AI for Science” 的虚假外衣。如果你以为搞材料研发只要像生物制药一样,用大模型在云端“跑个分”就能大力出奇迹,那这期节目会给你狠狠上一课,你会发现,真正的材料学 AI 护城河,离我们简单的想象差了十万八千里。
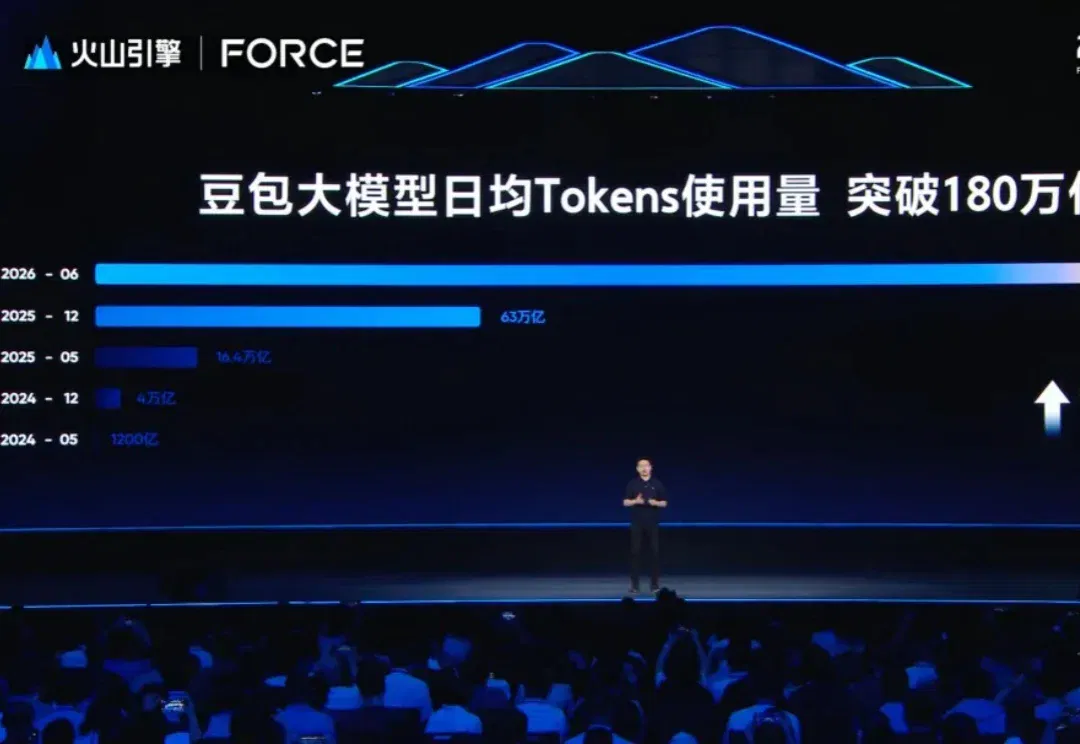
180 万亿。这是截至今年 6 月,豆包大模型的日均 token 调用量。