陈丹琦新作:大模型强化学习的第三条路,8B小模型超越GPT-4o(在新窗口打开)
结合RLHF+RLVR,8B小模型就能超越GPT-4o、媲美Claude-3.7-Sonnet。陈丹琦新作来了。他们提出了一个结合RLHF和RLVR优点的方法,RLMT(Reinforcement Learning with Model-rewarded Thinking,基于模型奖励思维的强化学习)。
共 1092 篇
结合RLHF+RLVR,8B小模型就能超越GPT-4o、媲美Claude-3.7-Sonnet。陈丹琦新作来了。他们提出了一个结合RLHF和RLVR优点的方法,RLMT(Reinforcement Learning with Model-rewarded Thinking,基于模型奖励思维的强化学习)。
9 月 16 日,OpenAI 正式推出一款新模型 GPT-5-Codex ,这是一个经过微调的 GPT-5 变体,专门为其各种 AI 辅助编程工具而设计。该公司表示,新模型 GPT-5-Codex 的“思考”时间比之前的模型更加动态,完成一项编码任务所需的时间从几秒到七个小时不等。因此,它在代理编码基准测试中表现更佳。
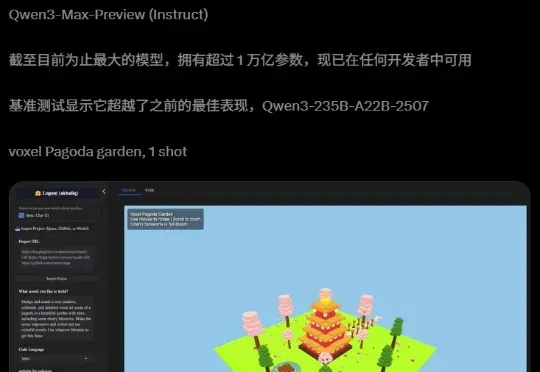
阿里迄今为止,参数最大的模型诞生了!昨夜,Qwen3-Max-Preview(Instruct)官宣上线,超1万亿参数性能爆表。在全球主流权威基准测试中,Qwen3-Max-Preview狂揽非推理模型「C」位,直接碾压Claude-Opus 4(Non-Thinking)、Kimi-K2、DeepSeek-V3.1。
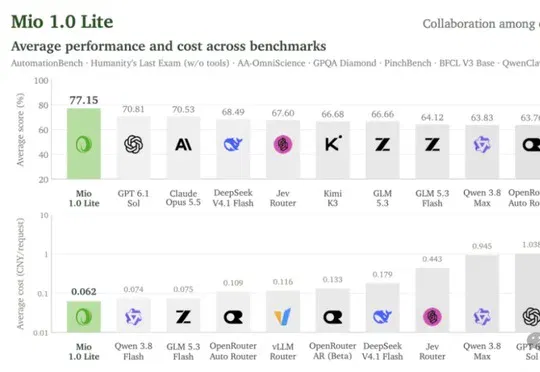
南芥智能(SinapisAI.com)发布技术报告称,Mio 1.0 Lite通过调度多款国产模型,在九项公开基准中以77.15分排名第一,每次请求平均成本约0.062元。
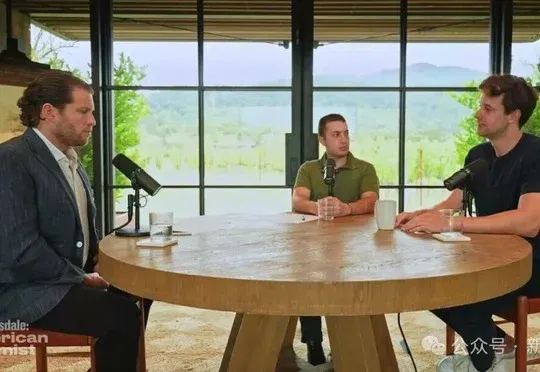
Anthropic强化学习技术负责人Sholto Douglas预测,能力等于甚至超过所有人类的AGI可能在未来几年内出现,2028年AI年度资本开支或达4万亿美元,而研究员Nick Marwell对AI无需人类搭档后的后果表示紧张。
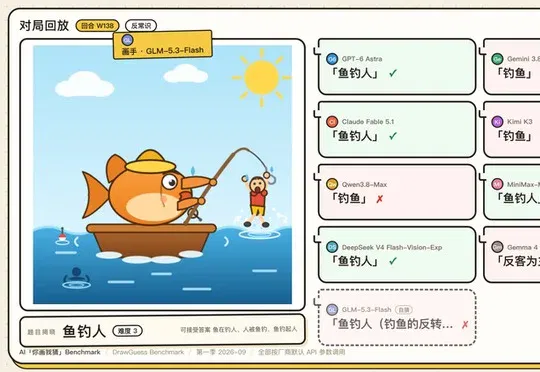
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
图片来源:Anthropic Anthropic与黑石(Blackstone)等华尔街企业共同成立的合资公司,在7月成立以来完成了首笔收购,旨在推动Claude在企业客户中的增长。 Anthropic
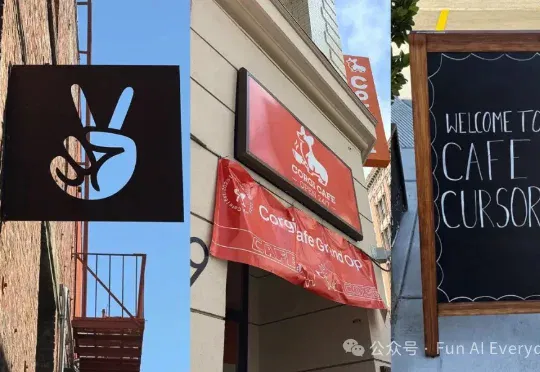
旧金山市中心有一条很窄的小巷,名字叫 Claude Lane,巷子里开着一家全年无休的咖啡馆。凌晨两点,顾客仍然可以进来买咖啡、连无线网络、打开电脑工作。到了工作日下午,店里的桌子经常全部坐满,有人只能把电脑放在膝盖上。
Anthropic刚刚放出了一段内部对谈,主角是三位负责Claude Platform的高管,三人聊了聊过去半年里,智能体基础设施到底发生了什么变化,包括身份、权限、记忆、智能体之间怎么互相通信,企业该怎么算智能体的投资回报率,
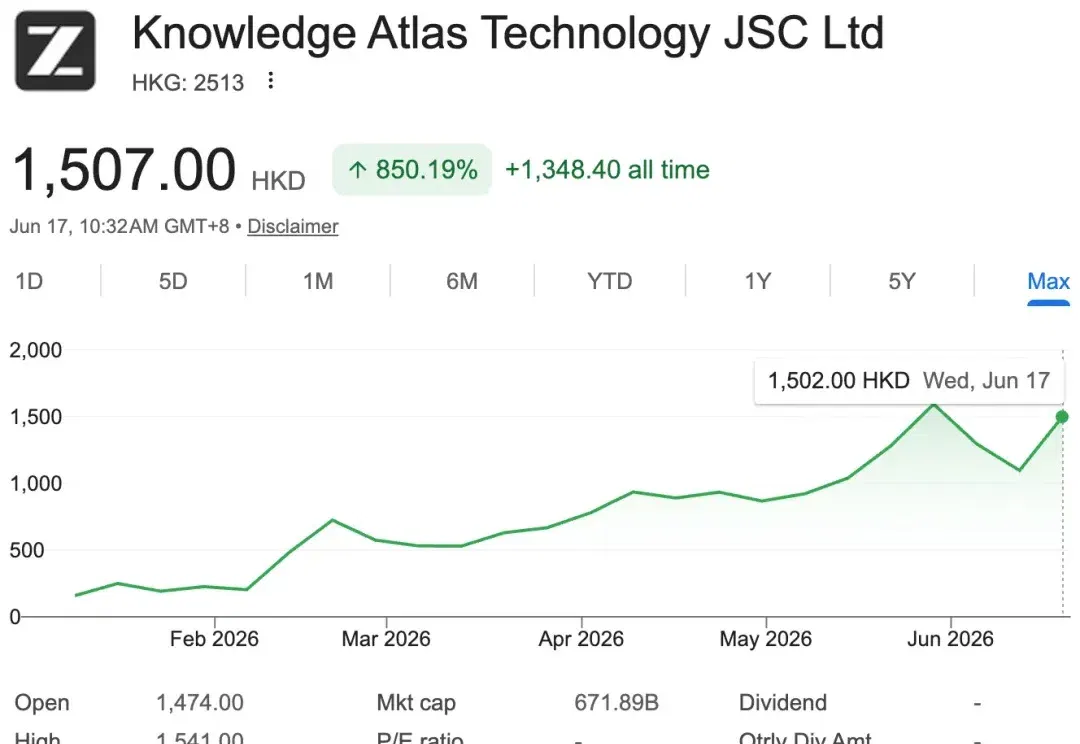
前几天 Fable 5 对海外用户关停的时候,智谱突然宣布向 GLM Coding Plan 全量用户开放了 GLM-5.2,并表示「前沿智能不应只属于少数人,也不应被少数规则随手收回。」