DeepSeek-V4和GPT-5.5第一波实测对决,结果出人意料!(在新窗口打开)
昨夜,GPT-5.5果然按期发布了,全网没有白等。更炸裂的是,就在同一天,DeepSeek-V4紧随其后发布了!实测后,结果出人意料。
共 108 篇
昨夜,GPT-5.5果然按期发布了,全网没有白等。更炸裂的是,就在同一天,DeepSeek-V4紧随其后发布了!实测后,结果出人意料。
不更是不更,一更就是个大动作,DeepSeek V4可能真的要来了!
DeepSeek V4下周登场:原生多模态,绕过英伟达,针对国产芯片深度优化。华尔街最怕的那条逻辑可能又要重演:算力霸权松动,美股先颤抖。
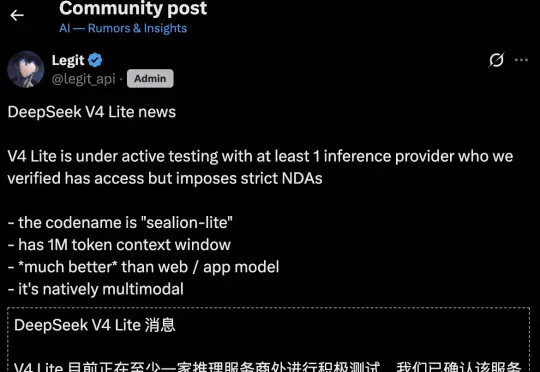
最近,炸裂消息一个接一个。首先,DeepSeek V4将在一周内上线。第二,它跳过英伟达,把访问权限首先给了某国内芯片厂商。另外,Anthropic因为蒸馏事件,也被群嘲了。
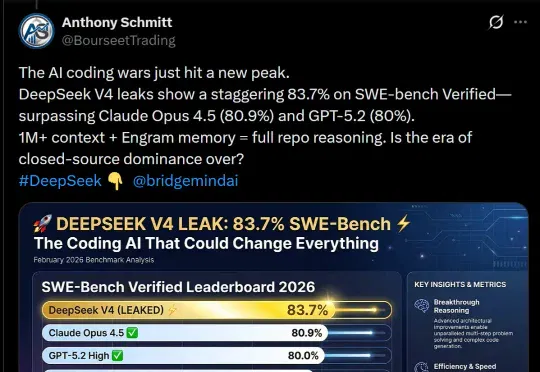
DeepSeek V4,据说明天就要上线了?这是首个匹敌顶尖闭源模型的开源模型,被网友评为「一鲸落万物生」。泄露的基准测试显示,它在SWE-bench Verified上取得了83.7%,已经超越Opus 4.5和GPT-5.2!
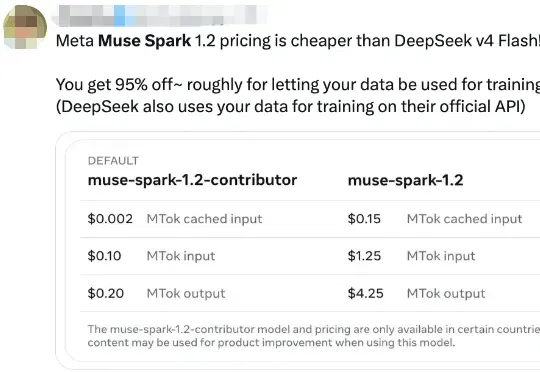
今日,Meta推出其首款编程Agent——Muse Code(测试版),以及该Agent搭载的新一代模型Muse Spark 1.2。模型一经面世便引发海外热议,核心关注点直指定价策略:比DeepSeek-V4-Flash更便宜。如果用户允许Meta用他们的数据训练模型,就能享受95折优惠。
DeepSeek 连自己官方开源的推理代码都能写错,而且错得相当有规律。
超越 GPT-5.5、Gemini 3.5 Flash、DeepSeek V4 Pro,阿里的最新旗舰模型 Qwen3.7 Max 在编程竞技榜拿下第二名,仅次于 Claude Opus 4.7。除了真实场景的用户选择,在传统的大模型固定评测榜单上,像是终端能力 Terminal Bench、编程能力 SWE Bench 等,Qwen3.7 Max 的表现也是拿下了国产模型的冠军。
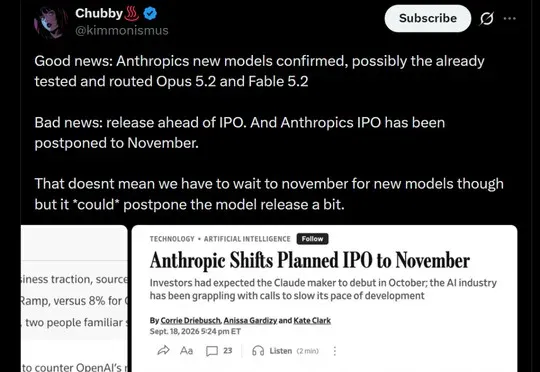
Anthropic、谷歌、OpenAI、Kimi、DeepSeek及阿里Qwen等全球AI大厂正密集备战,在中秋国庆假期前后集中推出或预告Claude 5.2、Gemini 4 Pro、Kimi K3.1、DeepSeek V4.1 Pro、Qwen4等旗舰基模,集体围攻OpenAI此前发布的GPT-6 Astra。
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。