9B端侧开源模型跑通百万上下文,面壁全新稀疏-线性混合注意力架构SALA立功了!(在新窗口打开)
最强的大模型,已经把scaling卷到了一个新维度:百万级上下文。
共 111 篇
最强的大模型,已经把scaling卷到了一个新维度:百万级上下文。
在 Anthropic 成立五周年前夕,联合创始人兼总裁 Daniela Amodei 罕见接受了公开采访!
MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。
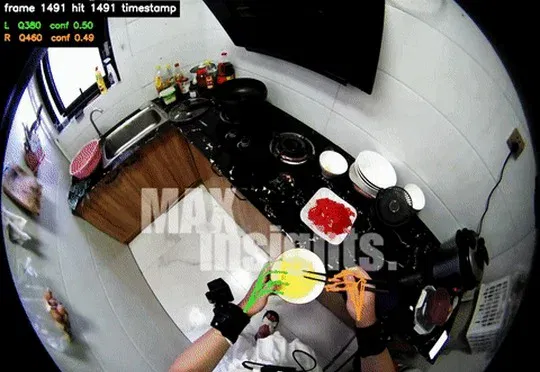
Maxinsights累计交付超200万小时第一人称数据,成为Figure、Genesis AI、Dyna Robotics等硅谷头部具身智能团队的数据基础设施,凭借150万小时高质量数据存量与全链路算法处理能力推动具身智能Scaling Law持续验证。
过去的大模型 scaling law 通常回答的是:当模型参数量、数据量和训练计算量增加后,loss 会如何下降。
姜旭是少数完整参与过 OpenAI 大模型核心技术演进的华人创业者之一。2019 至 2023 年间,他经历了 GPT 系列能力爆发最关键的阶段,工作横跨底层训练 infra、大规模预训练、RLHF 对齐算法与数据构建等核心链路。
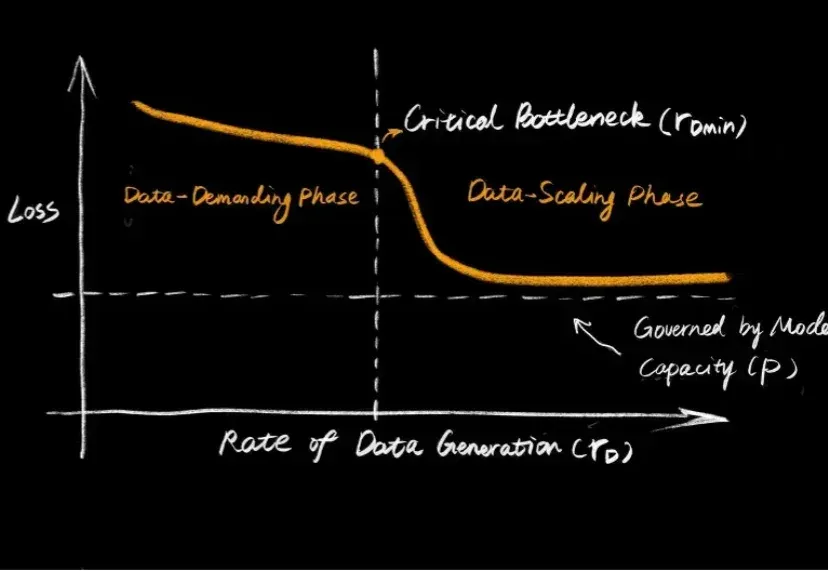
大语言模型的爆发,让大家见证了 Scaling Law 的威力:只要数据够多、算力够猛,智能似乎就会自动涌现。但在机器人领域,这个公式似乎失效了。
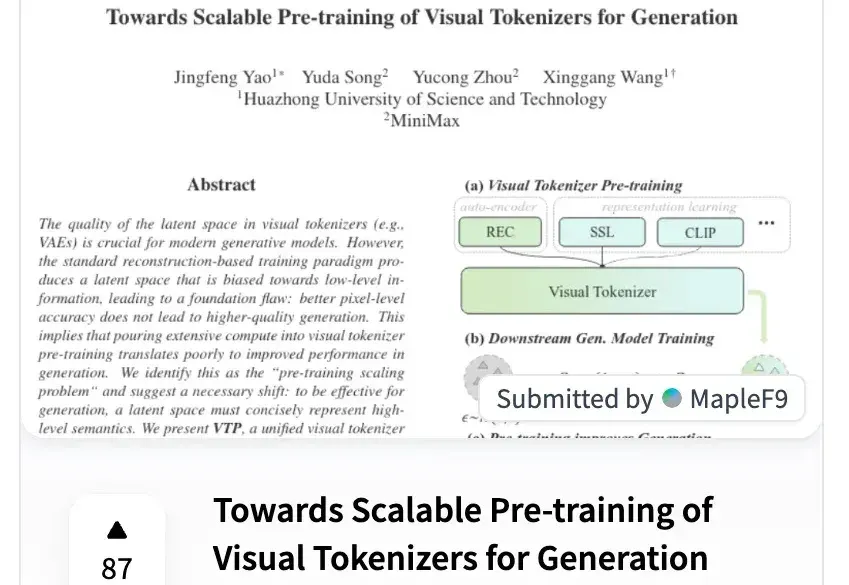
2025 年还有一周结束,年底,AI 视频圈又卷起来了。
Epoch AI 最近受 Google DeepMind 委托编写了一份分析报告,探讨这种规模扩张(Scaling)在计算、投资、数据、硬件和能源方面将带来哪些影响。在报告中,进一步探讨了这种规模扩张将赋予的未来 AI 能力,尤其是在科研领域,而这正是领先 AI 开发者关注的重点。
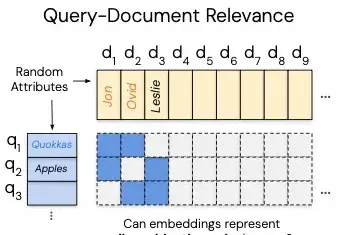
最近,工业界“RAG已死”甚嚣尘上。过去几年,AI领域的主旋律是“规模定律”(Scaling Law),即更大的模型、更多的数据会带来更好的性能。即便偶然有瑕疵,也认为只是工程上的不足,并非数学上的不可能。