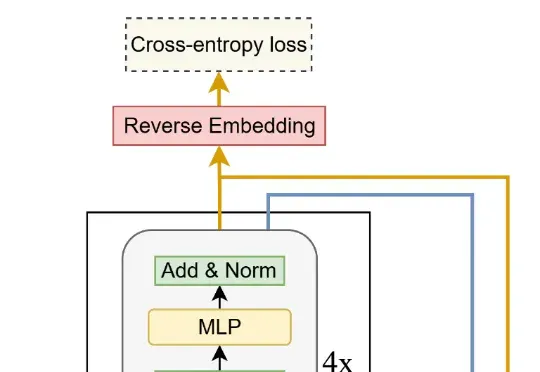
700万参数击败DeepSeek R1等,三星一人独作爆火,用递归颠覆大模型推理(在新窗口打开)
来自加拿大蒙特利尔三星先进技术研究所(SAIT)的高级 AI 研究员 Alexia Jolicoeur-Martineau 介绍了微型递归模型(TRM)。这个 TRM 有多离谱呢?一个仅包含 700 万个参数(比 HRM 还要小 4 倍)的网络,在某些最困难的推理基准测试中,
共 66 篇
来自加拿大蒙特利尔三星先进技术研究所(SAIT)的高级 AI 研究员 Alexia Jolicoeur-Martineau 介绍了微型递归模型(TRM)。这个 TRM 有多离谱呢?一个仅包含 700 万个参数(比 HRM 还要小 4 倍)的网络,在某些最困难的推理基准测试中,
论文提出的方法名为 RL4HS,它使用了片段级奖励(span-level rewards)和类别感知的 GRPO(Class-Aware Group Relative Policy Optimization),从而避免模型偷懒、只输出无错误预测。
最近读到a16z合伙人Olivia Moore的一篇分析文章《 The Great Expansion: A New Era of Consumer Software》,她把这种现象称为"Great Expansion"(大扩张),我觉得她抓住了一个非常关键的趋势。
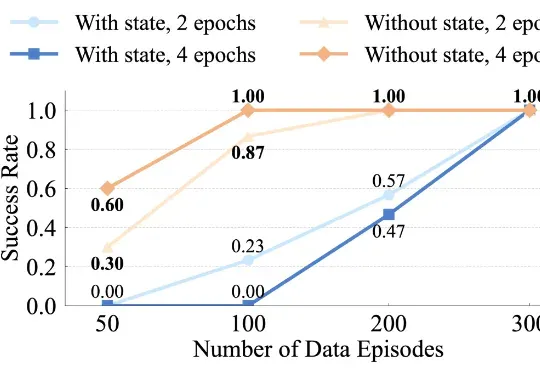
最近,千寻智能的研究人员注意到,基于模仿学习的视觉运动策略中也存在类似现象,并在论文《Do You Need Proprioceptive States in Visuomotor Policies?》中对此进行了深入探讨。
你有没有经历过这样的场景:公司高层突然宣布"我们现在是AI优先的公司",然后看着你说"去组建一个AI团队吧",但预算和人员编制却纹丝不动?如果你点头了,那你绝对不是一个人。从Shopify到Duolingo,再到Zapier,似乎每家科技公司都在宣布自己转型为"AI优先",仿佛这是一张通往未来的船票。但现实往往更加残酷:你被赋予了AI转型的重任,却没有额外的资源去实现它。
用 AI 学语言,正成为越来越多人的选择。我们习惯于在手机里下一个 Duolingo 或 Babbel,利用碎片时间打卡闯关,仿佛离「掌握一门外语」的目标又近了一步。