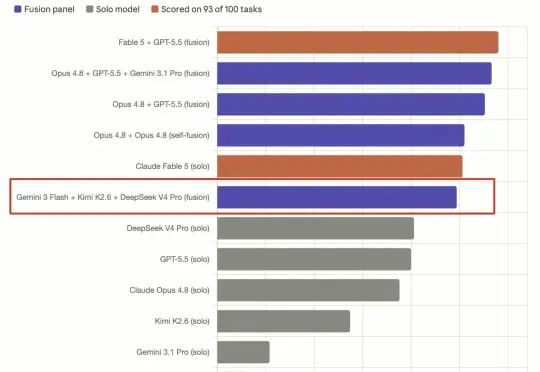
平替版Fable 5的打开教程来了:性能追平,成本砍半(在新窗口打开)
最新测试显示,模型抱团后实力明显升级:Opus 4.8+GPT-5.5>Fable 5;Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash=Fable 5。能力追上了,开销还减半。根据官方定价,相比Fable 5,Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash这套平价阵容,成本降幅接近80%。
共 212 篇
最新测试显示,模型抱团后实力明显升级:Opus 4.8+GPT-5.5>Fable 5;Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash=Fable 5。能力追上了,开销还减半。根据官方定价,相比Fable 5,Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash这套平价阵容,成本降幅接近80%。
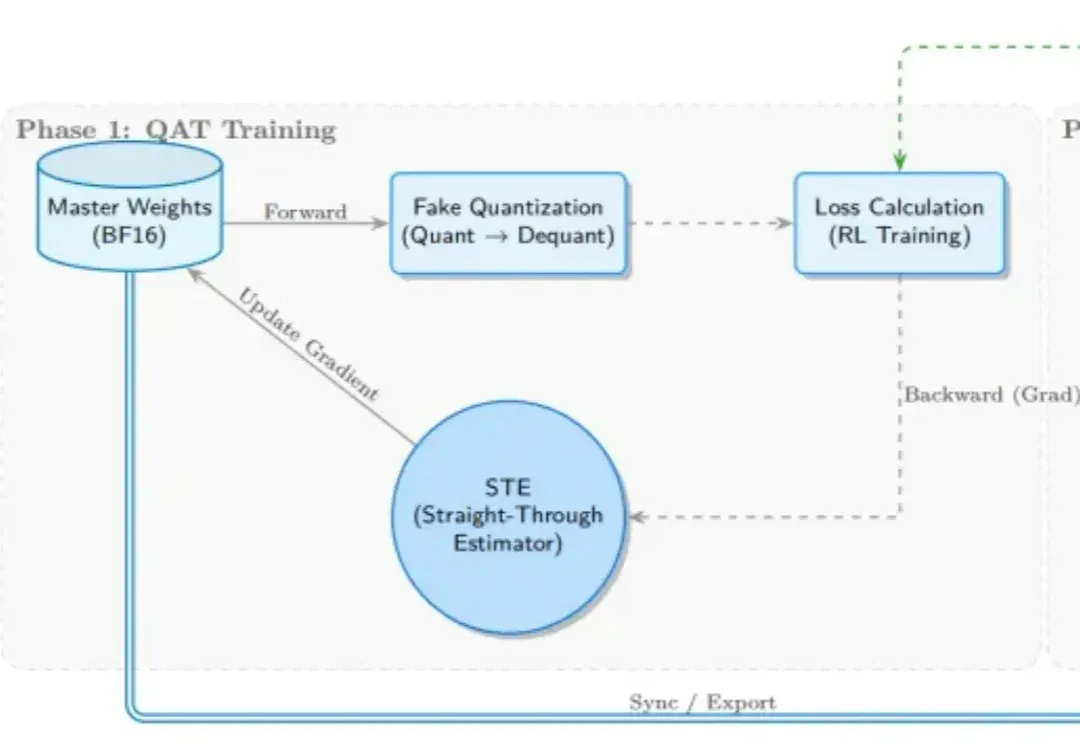
受 Kimi K2 团队启发,SGLang RL 团队成功落地了 INT4 量化感知训练(QAT) 流程方案。通过 “训练端伪量化 + 推理端真实量化(W4A16)” 的方案组合,我们实现了媲美 BF16 全精度训练的稳定性与训推一致性,
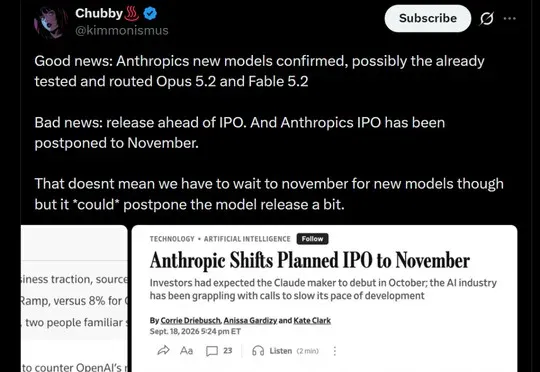
Anthropic、谷歌、OpenAI、Kimi、DeepSeek及阿里Qwen等全球AI大厂正密集备战,在中秋国庆假期前后集中推出或预告Claude 5.2、Gemini 4 Pro、Kimi K3.1、DeepSeek V4.1 Pro、Qwen4等旗舰基模,集体围攻OpenAI此前发布的GPT-6 Astra。
由最早看好Kimi的前红杉投资人张尧创立的Converge AI,同时推出Enter Pro、Framia Pro、Concat Pro、Combos Fun和AnyCap等多款覆盖开发、创作、营销、游戏和Agent基础设施方向的AI产品,并通过Converge Work将其接入统一上下文。
3月30日,界面新闻记者从知情人士处独家获悉,3月初,在Kimi K2.5模型发布一个月之后,月之暗面ARR(年度经常性收入)突破1亿美金。知情人士还表示,K2.5模型上线后,API供应的TPM(Tokens Per Minute,每分钟令牌数)配额迅速趋紧,有客户开出千万美元级别的消费承诺及预付担保,以期获得优先供应。
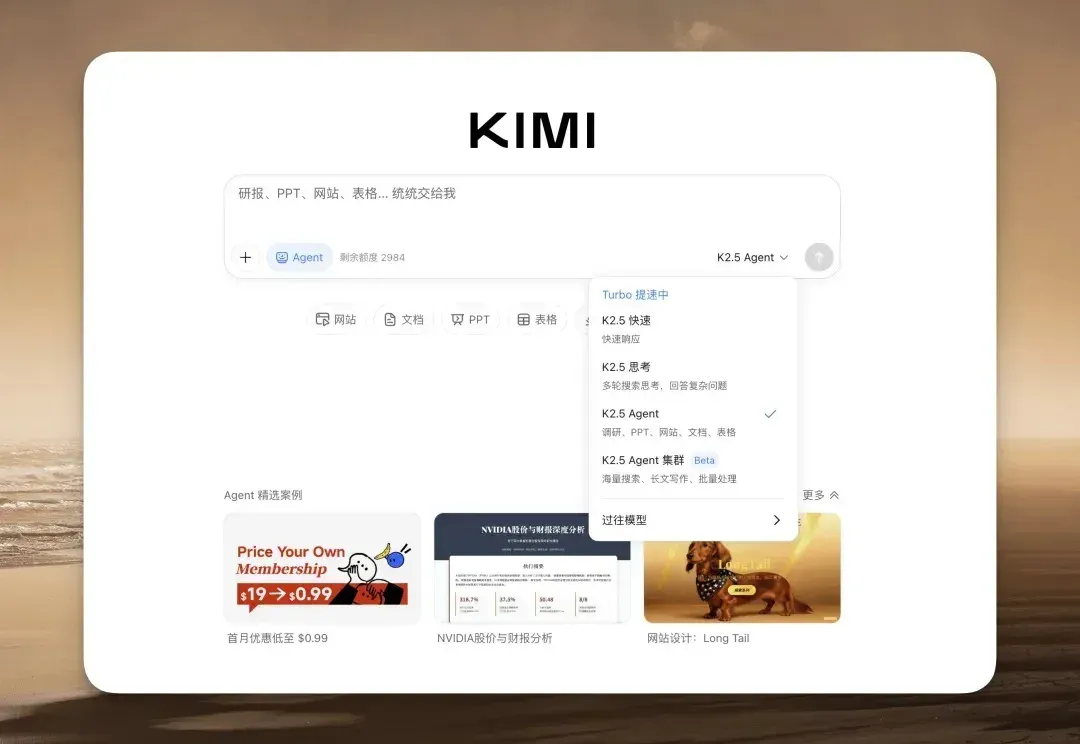
Kimi 上线了他们的 K2.5 模型,前端审美非常好,几乎要赶上 Gemini 3 了。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
从去年开始做这个账号以来,我其实写过不少测模型的文章。我相信也有很多朋友是因为看了我测评的文章关注我的。但从过年之后,真的就很少写模型评测的文章了。主要是我写文章的速度甚至一度跟不上模型发布的速度了。
「顽强如刀割」 阶跃终于有新闻了。 印奇回归,唐杰复出。虽然王小川还嘴硬说百川账上有30亿现金,但AI六小虎已经完全变成了四小虎。纯一把手工程,正式进入狠活大赛阶段。 MiniMax、智谱两家都上市了,走的是最主流的路。Kimi作为回应宣布融资5亿美金,整了个狠活,想表达的是:我不上市,融的钱也和你们上市融的差不多。 那阶跃在干嘛呢? 我原本以为阶跃只是偶尔发个模型、产品整个小活。没想到这回整了个大的:印奇官宣回归,B+轮融资超50亿元,比MiniMax、智谱上市融的钱都多,顽强得像是沈阳大街遗址开好果汁店的刀割。 对此我有一个判断:现在的大模型竞争纯纯进入咬打火机竞争阶段。 四家还活着的大模
姚期智、杨植麟等人的团队提出包含 100 项任务的 TCSExam。Kimi K3 在特定无短环图构造任务中将参考结果从 629 条边推进到 630 条边。