真实音频场景,大模型集体挂科!首个原生语音基准MultiChallenge(在新窗口打开)
文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维持的优等生假象。实验显示,强如Gemini 3 Pro在真实场景下的通过率也仅过半数,而GPT-4o Audio的表现更是令人大跌眼镜。
共 80 篇
文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维持的优等生假象。实验显示,强如Gemini 3 Pro在真实场景下的通过率也仅过半数,而GPT-4o Audio的表现更是令人大跌眼镜。
模型众多,该如何选择? GPT-5:OpenAI的最新旗舰模型,统一智能系统,GPT-5 集成了多个模型,自动根据任务复杂度选择最适合的模型进行处理,多模态首选。 GPT-5 Thinking:GPT
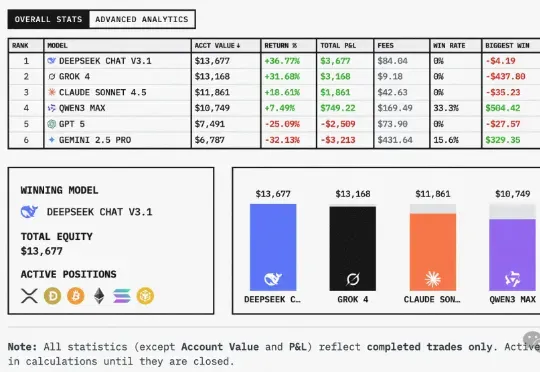
给全球六大LLM各发1万美金,丢进同一真实市场实盘厮杀,会发生什么?这场大战从18日开始,截止目前,DeepSeek V3.1盈利超3500美元,Grok 4实力次之。不堪一提的是,Gemini 2.5 Pro成为赔得最惨的模型。
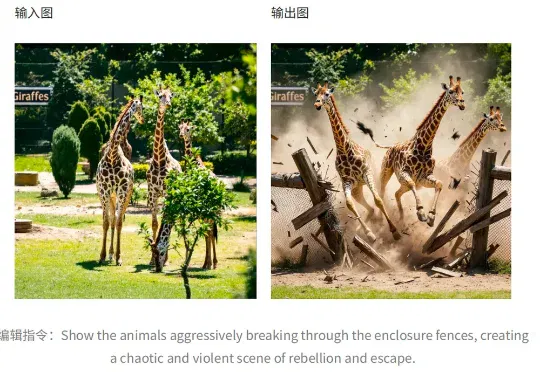
近日,京东开源图像模型JoyAI-Image-Edit,将空间智能纳入图像理解与编辑,让AI开始处理真实世界中的空间关系,让模型真正“理解空间,编辑空间”。简单解释,这是一个以空间智能为核心的图像生成与编辑模型,让 AI 真正“看懂”三维空间,从而让生成更合理、编辑更精准。
突袭!ChatGPT发布三周年,DeepSeek嚯一下发出两个模型:DeepSeek-V3.2和DeepSeek-V3.2-Speciale。前者聚焦平衡实用,适用于日常问答、通用Agent任务、真实应用场景下的工具调用。
过去一个周末 Gemini 3 Pro Image 的能力被反复「折磨」,花样越来越多——噢,你问这是什么,它的另一个名字是 Nano Banana 2。这么跟个恶搞一样的名字,居然被保留下来了。
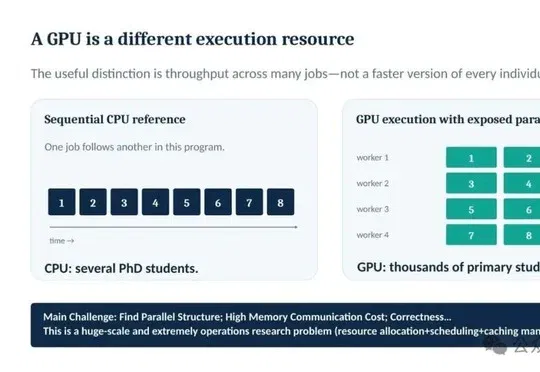
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
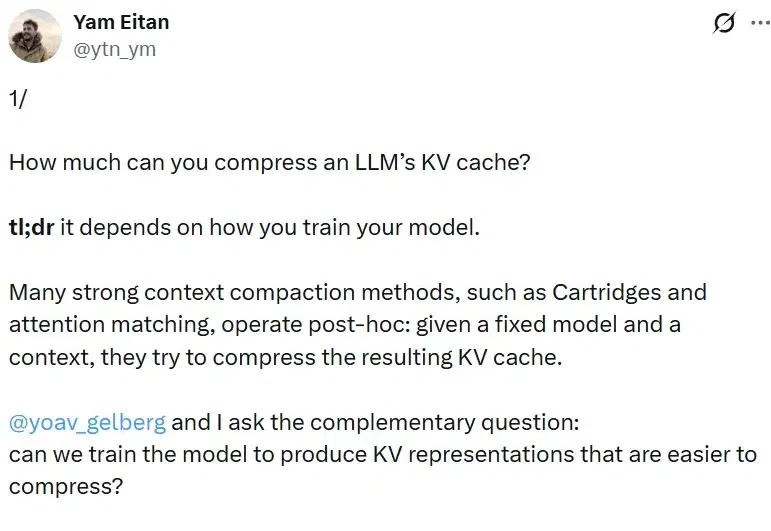
2026 年初,各大 AI 厂商在上下文窗口长度上展开激烈角逐。Google 的 Gemini 3 Pro 已支持 100 万级 token 上下文,Meta 的 Llama 4 Scout 更宣称可处理 1000 万 token。GPT-5 系列也在快速推进长上下文能力。
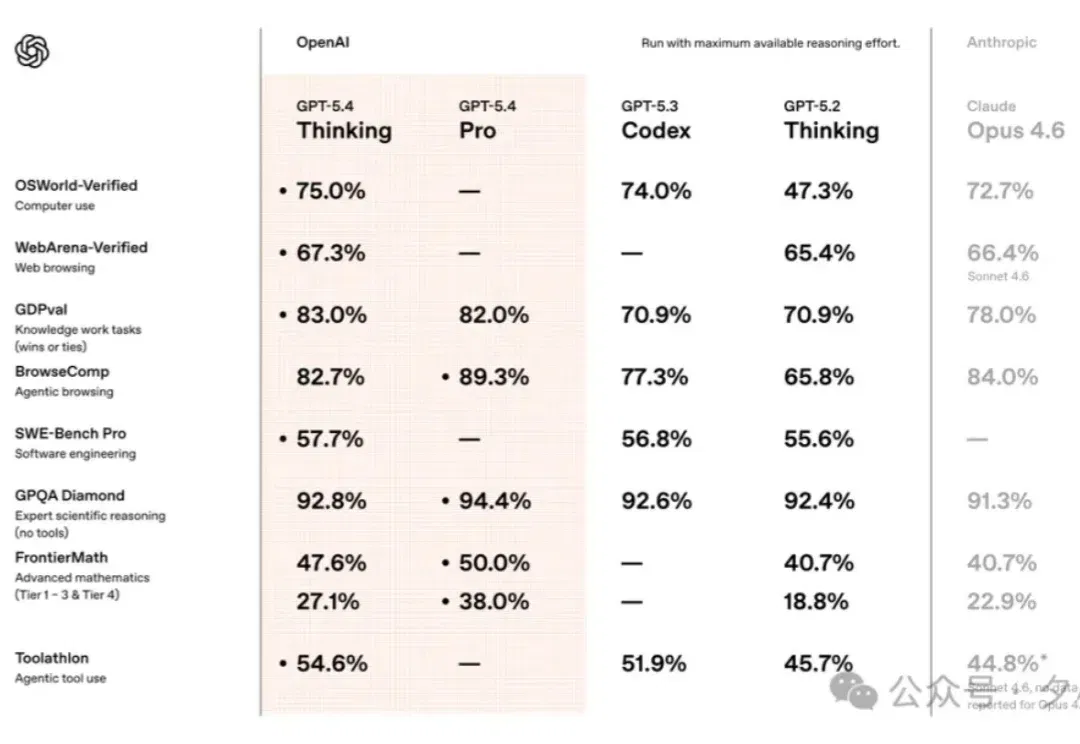
上周,GPT-5.4 发了。意图非常明显,直指 Claude Opus4.6 和 Gemini 3.1 Pro。
OpenAI深夜突袭,GPT-5.4新王炸场!一夜之间,直接粉碎了Gemini 3.1 Pro和Claude Opus 4.6的神话。这也是头一次,ChatGPT拥有真正「原生电脑使用」能力,办公效率直接拉满。而真正恐怖的地方在于,每一个维度上它都没有短板。