硅谷扔出“巨内核”,中国团队祭出“超级算子”,万亿参数模型效率战打响!(在新窗口打开)
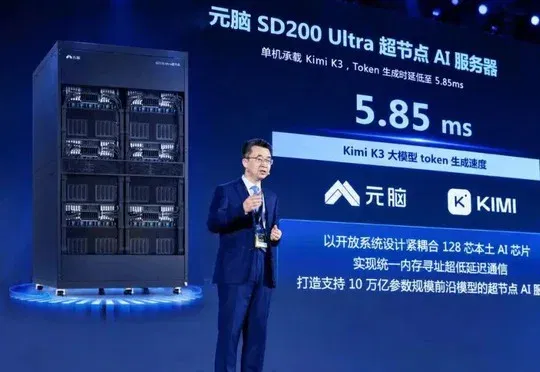
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
共 164 篇
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
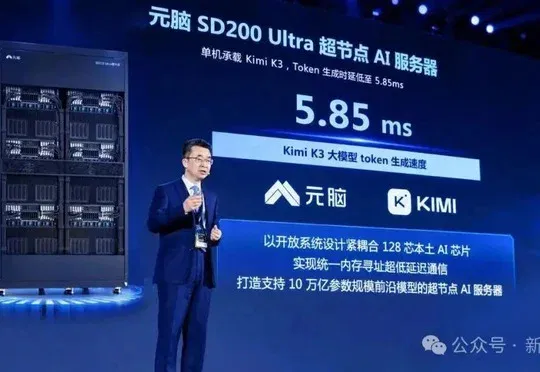
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
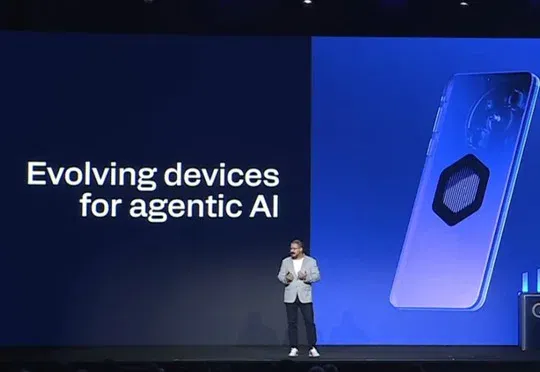
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
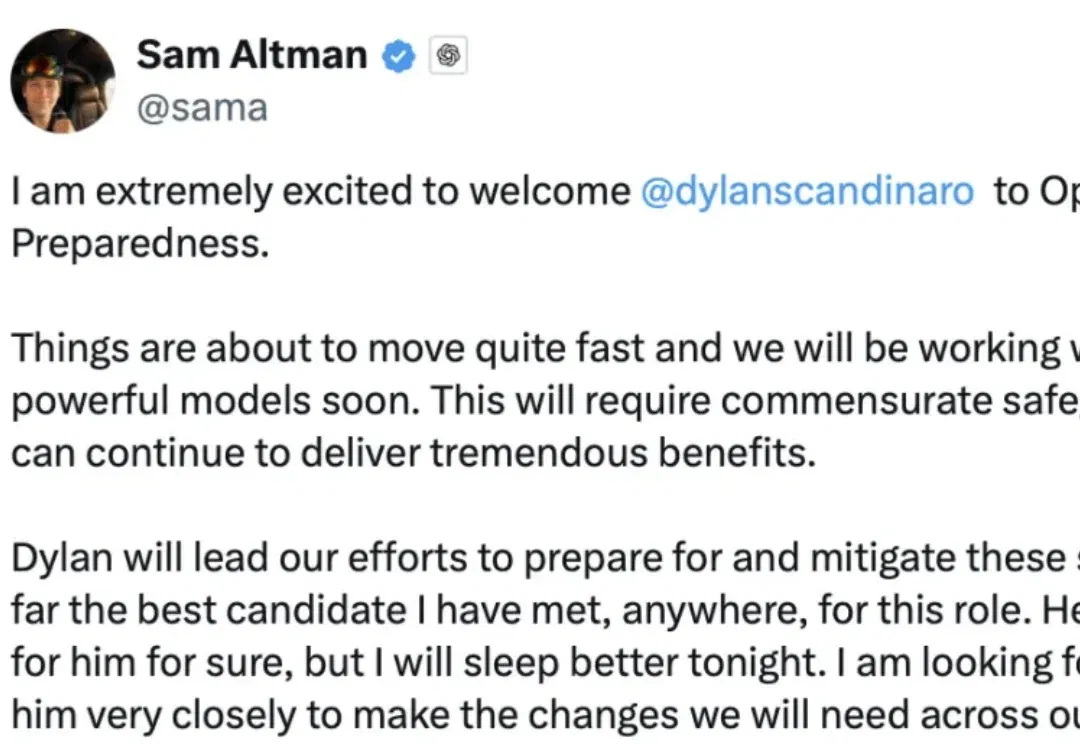
OpenAI……又解散了一个安全团队。 该团队名为“Preparedness”,意为“应急准备”,专门负责评估自家AI是否会带来灾难级的社会风险。 官方对此称,安全工作已经融入了开发流程,不需要单独设一个团队了。 此前,OpenAI在两年间主要组建过4支安全力量,分别是: Safety团队,关注当前产品的安全问题,负责人离职后被合并进研究部门; Superalignment团队,关注远期超级智能对齐问题,已于2024年5月解散,其负责人离职后公开称“安全已给产品让路”,而后Mission Alignment团队作为其继任团队被组建,存续仅16个月。 AGI Readiness团队,2024年1
试图把医疗级脑刺激技术装进日常耳机。 2026年5月,消费神经科技公司Sychedelic宣布完成350万美元种子轮融资,由Cultadvisors LLP、TurboStart和IdeaBaaz(Kuberan Ventures)领投,Praveek Ventures及多位天使投资人跟投。 这家总部位于印度古尔冈、在纽约设有办事处的初创企业,计划用这笔资金推进产品量产、全球市场拓展以及AI自适应算法的持续迭代。 Sychedelic的联合创始人兼CEO Ria Rustagi 的妹妹因误诊的脑部感染去世,Rustagi 本人因此患上创伤后应激障碍,随后,她在生下第一个孩子后又遭遇产后抑郁。
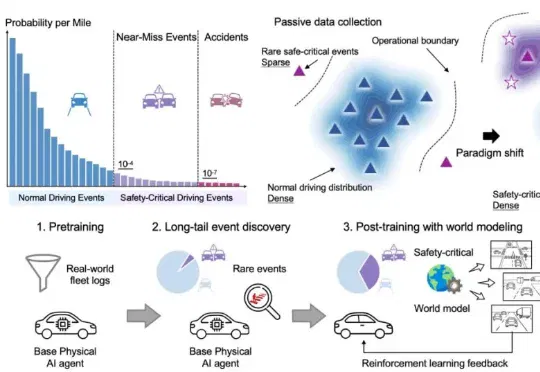
香港大学李弘扬团队联合华为、上海创智学院及清华大学李升波教授团队,发表的最新论文World Engine: Towards the Era of Post-Training for Autonomous Driving给出了系统回答。
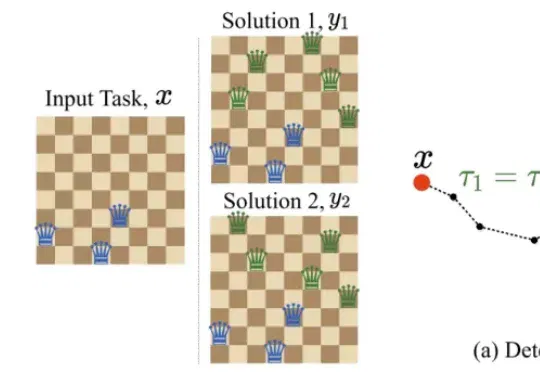
现在,图灵奖得主 Yoshua Bengio 给出了一份全新的并行方案。他们提出了 GRAM(Generative Recursive reAsoning Models,生成式递归推理模型),把确定性的递归潜在推理变成了概率性的多轨迹计算。模型在潜在空间中进行随机递归推理,每一步都可以采样不同的方向,最终形成对解空间的多路径探索。
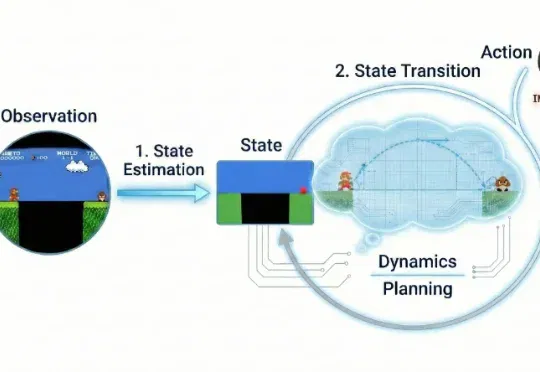
近年来,视频生成(Video Generation)与世界模型(World Models)已跃升为人工智能领域最炙手可热的焦点。从 Sora 到可灵(Kling),视频生成模型在运动连续性、物体交互与部分物理先验上逐渐表现出更强的「世界一致性」,让人们开始认真讨论:能否把视频生成从「逼真短片」推进到可用于推理、规划与控制的「通用世界模拟器」。
最近,一篇由中国团队领衔全球24所TOP高校机构发布,用于评测LLMs for Science能力高低的论文,在外网炸了!当晚,Keras (最高效易用的深度学习框架之一)缔造者François Chollet转发论文链接,并喊出:「我们迫切需要新思路来推动人工智能走向科学创新。」
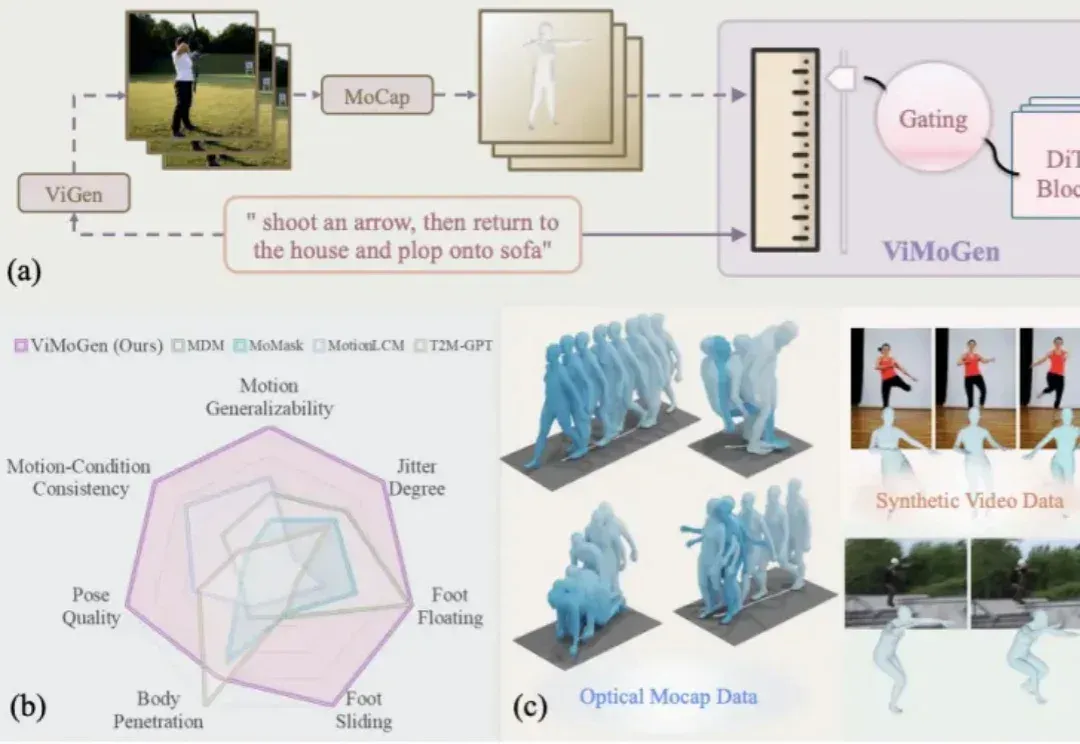
随着 AIGC(Artificial Intelligence Generated Content) 的爆发,我们已经习惯了像 Sora 或 Wan 这样的视频生成模型能够理解「一只宇航员在火星后空翻」这样天马行空的指令。然而,3D 人体动作生成(3D MoGen)领域却稍显滞后。