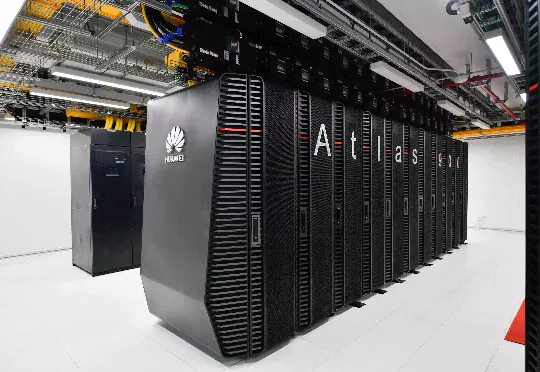
智谱建成1吉瓦AI数据中心,已开始部分运营。(在新窗口打开)
7月20日,一则消息震动全球AI圈:中国AI公司zAI(智谱AI)建成一座供电规模达1吉瓦(1GW)的AI数据中心,已开始部分运营。更核心的信息是——这座超大规模算力中心,完全未使用任何Nvidia芯片。
共 108 篇
7月20日,一则消息震动全球AI圈:中国AI公司zAI(智谱AI)建成一座供电规模达1吉瓦(1GW)的AI数据中心,已开始部分运营。更核心的信息是——这座超大规模算力中心,完全未使用任何Nvidia芯片。
AI新云赛道再现巨额融资。成立于2022年的AI新云(Neocloud)公司Together AI,于7月1日正式宣布完成8亿美元C轮融资,投后估值达到83亿美元。Together AI的核心业务是出租NVIDIA GPU集群及其他AI专用基础设施,为企业提供运行开源大模型的云平台。
在世界模型这条路上,行业一直卡在一个几乎无解的矛盾里:想要更真实的长程模拟,就必须给模型更深的计算;可一旦把模型做得更深,部署成本、参数规模和误差累积又会迅速抬头。结果就是,大家都知道世界模型要 “想得更久”,却很难让它在现实系统里 “算得起、跑得稳”。
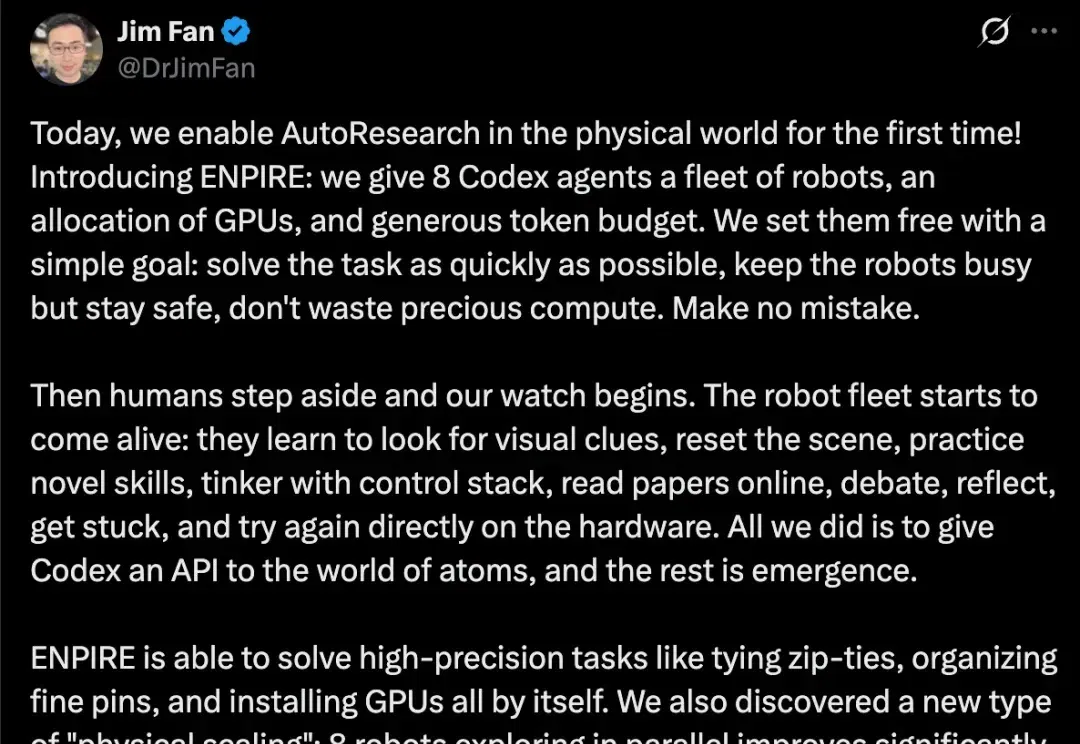
自动化研究,这一次真正走出代码沙盒,进入了真实的物理世界。
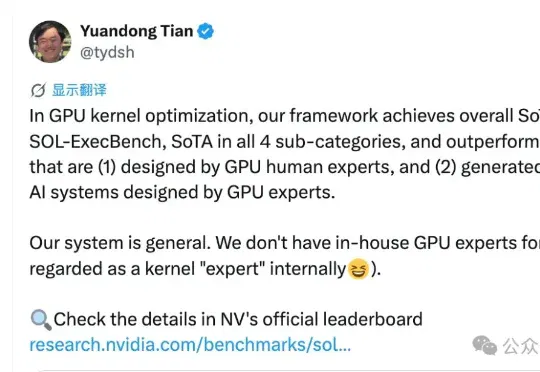
刚刚,田渊栋创业公司,交出了首个研究成果。田渊栋在X上宣布,其创立的Recursive,在NVIDIA官方的GPU kernel优化榜SOL-ExecBench上拿下了整体和四个子类别的SOTA。
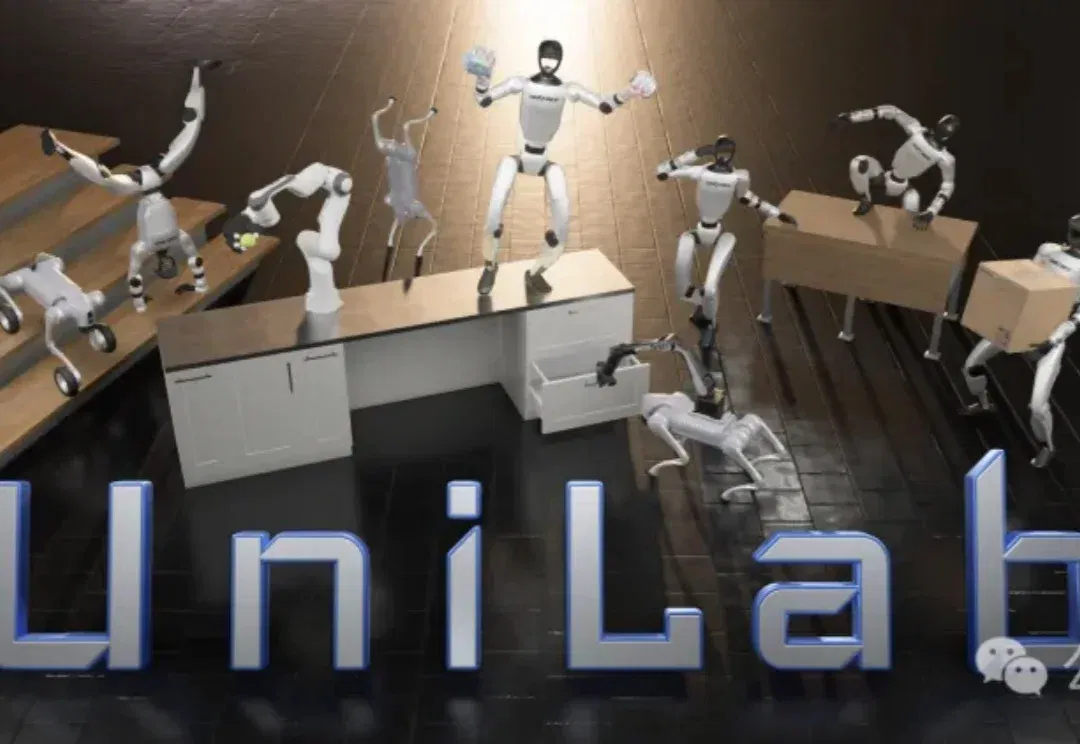
在具身智能训练中,“把计算全部塞进GPU”似乎成了唯一的提速密码,机器人运控并行训练的框架,IsaacLab、MuJoCoPlayground、mjlab都默认遵循这一范式,这些系统都牢牢绑定在NVIDIA生态中。
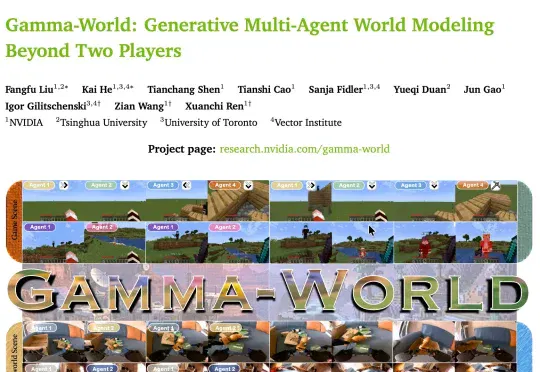
5 月下旬,NVIDIA 联合清华大学、多伦多大学和 Vector Institute 发布 Gamma-World,共一第一为清华大学电子系博士刘芳甫,核心 Research 方向是世界模型和空间智能。
Omdia这份名为《2026全球AI工厂市场格局》的报告,点明了新时代的核心逻辑——决定胜负的,不再是谁拥有更多GPU,而是谁能够更高效地把“电力+算力+数据”转化为真正有价值的Token。
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
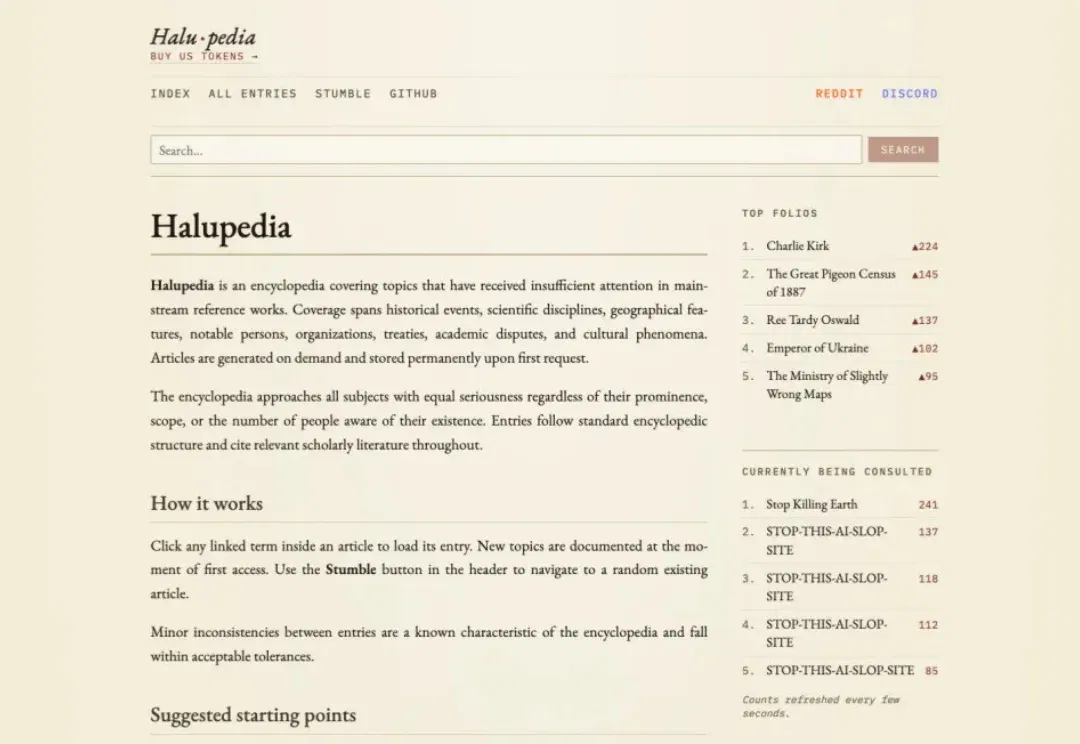
当我们在维基百科搜索一个词条时,你期待的是真相,至少在AI时代,总得有一个地方能(大概率)给我点真东西吧。可以,但在 Halupedia 搜索一个词条时,得到的也是真相——一个三秒钟前刚被发明出来的真相。