浙大00后硕士破局AI记忆难题!新技术让长对话响应速度快十余倍(在新窗口打开)
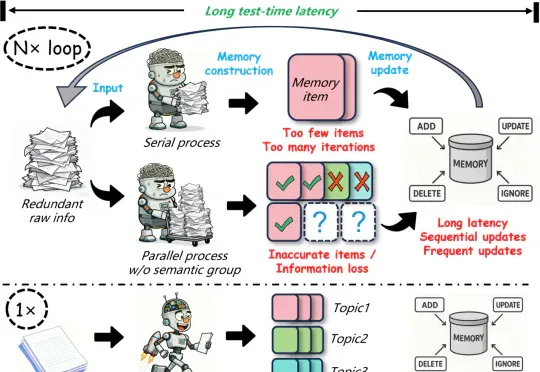
走上了堪称是“最佳 AI 转型路径”之后,他也在读研期间和合作者针对 AI 记忆开展了一项研究,借此发明出一种名为 LightMem(轻量记忆)的技术。在 LongMemEval 和 LoCoMo 这两个专门用于考察 AI 长期记忆能力的基准测试上,LightMem 回答问题的准确率全面超越之前的冠军模型,最高提升了 7% 以上,在某些数据集上甚至提升了将近 30%。
共 74 篇
走上了堪称是“最佳 AI 转型路径”之后,他也在读研期间和合作者针对 AI 记忆开展了一项研究,借此发明出一种名为 LightMem(轻量记忆)的技术。在 LongMemEval 和 LoCoMo 这两个专门用于考察 AI 长期记忆能力的基准测试上,LightMem 回答问题的准确率全面超越之前的冠军模型,最高提升了 7% 以上,在某些数据集上甚至提升了将近 30%。
最近研究发现,大模型在判断逻辑谬误时容易「想太多」,误报正常句子,但在确定有谬误后,其分类能力较强。研究人员构建了首个高质量英文逻辑谬误基准SMARTYPAT-BENCH,并开发了基于Prolog的逻辑谬误自动生成框架SMARTYPAT,为大模型逻辑能力评估提供新思路,可用于谬误识别、辩论教育等领域。
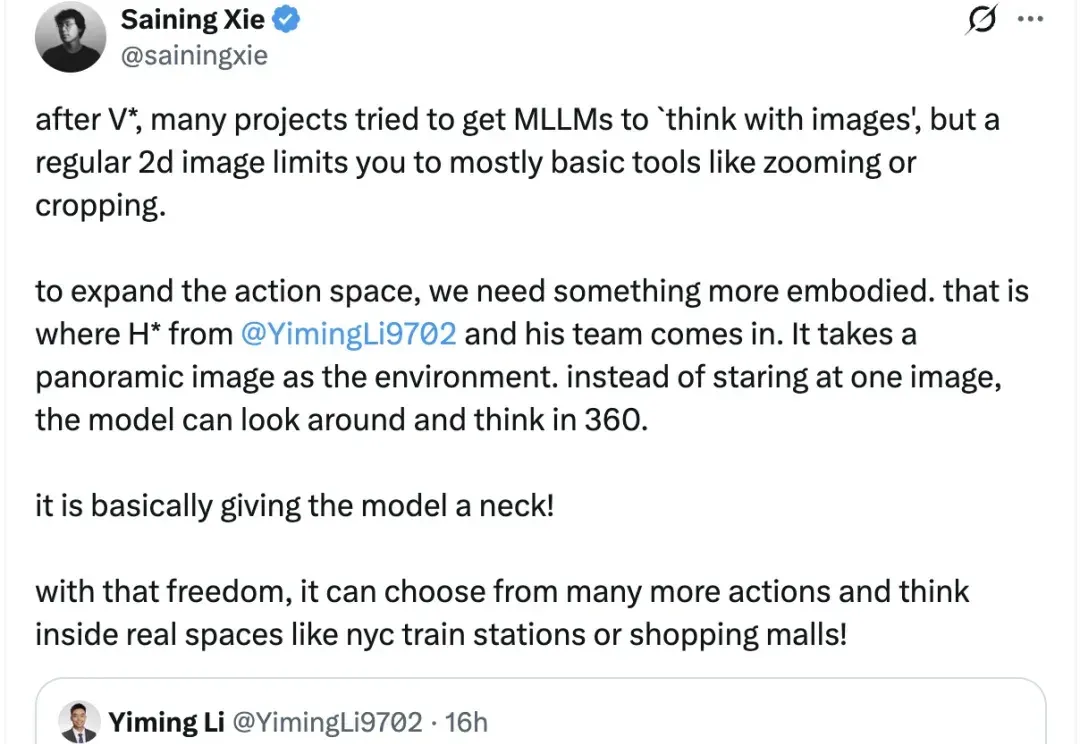
终于有人要给大模型安“脖子”了! 在最新的论文Thinking in 360°: Humanoid Visual Search in the Wild中,来自纽约大学的研究团队让大模型能够环顾四周,进行360度的全方位思考。 他们通过定义一套全新的数据集和基础测试H*,让模型可以在火车站、购物中心等真实环境中,进行像人类一样的视觉搜索。 谢赛宁(也参与了这篇论文)在转发中,直接表示:这不就是给模型安了个脖子吗? 这是怎么回事? 类人视觉搜索 整体而言,研究团队首先提出了一项在360度空间中实现人类主动空间推理的新任务—— 类人视觉搜索(Humanoid Visual Search),这项任务能
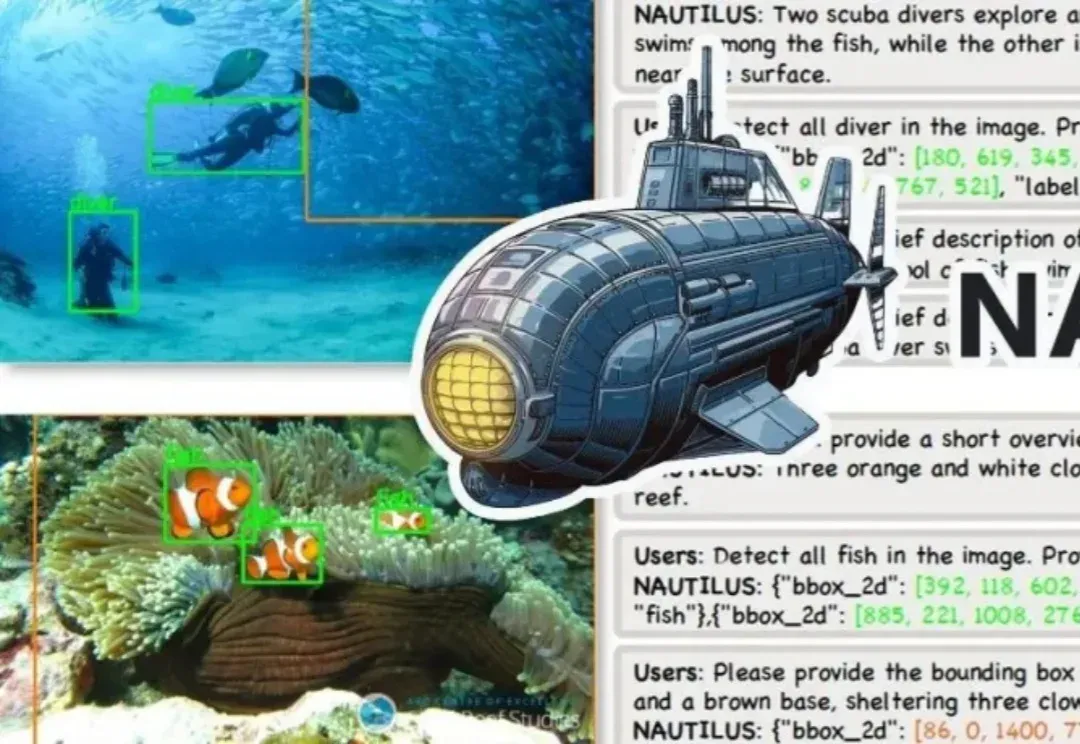
华中科技大学团队推出首个水下多模态大模型NAUTILUS,支持8种水下场景理解任务,并开源145万图文对的NautData数据集。模型通过视觉特征增强模块解决水下图像模糊和颜色失真问题,性能超越现有模型,恶劣环境下表现更佳。
在开放研究领域里,苹果似乎一整个脱胎换骨,在纯粹的研究中经常会有一些出彩的工作。这次苹果发布的研究成果的确出人意料:他们用谷歌的 Nano-banana 模型做个了视觉编辑领域的 ImageNet。
在金融、医疗等高度敏感的应用场景中,拜占庭鲁棒联邦学习(BRFL)能够有效避免因数据集中存储而导致的隐私泄露风险,同时防止恶意客户端对模型训练的攻击。然而,即使是在模型更新的过程中,信息泄露的威胁仍然无法完全规避。为了解决这一问题,全同态加密(FHE)技术通过在密文状态下进行安全计算,展现出保护隐私信息的巨大潜力。
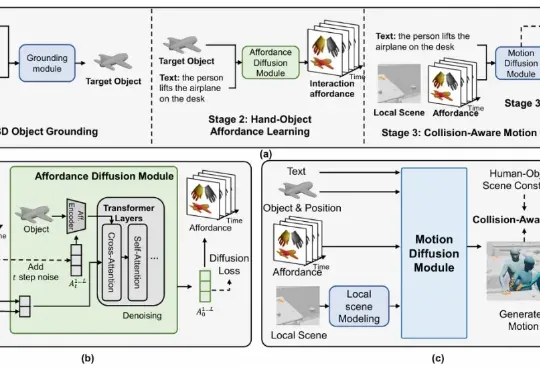
该研究首次提出了含可移动物体的 3D 场景中,基于文本的人 - 物交互生成任务,并构建了大规模数据集与创新方法框架,在多个评测指标上均取得了领先效果。
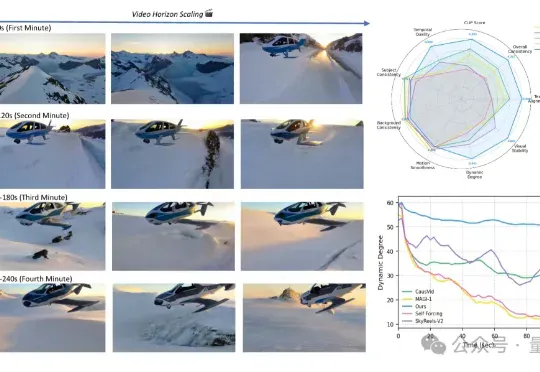
从5秒到4分钟,Sora2也做不到的分钟级长视频生成,字节做到了!这就是字节和UCLA联合提出的新方法——Self-Forcing++,无需更换模型架构或重新收集长视频数据集,就能轻松生成分钟级长视频,也不会后期画质突然变糊或卡住。
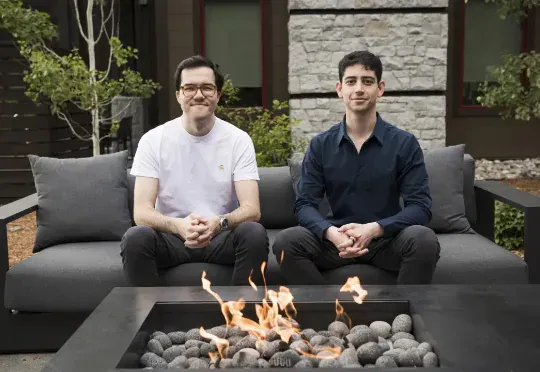
图片来源:David AI Labs David AI Labs 这家初创公司通过出售音频数据集来帮助训练人工智能模型,近期在新一轮融资中从投资者处筹集了 5000 万美元——这表明为 AI 开发提供
既然后训练这么重要,那么作为初学者,应该掌握哪些知识?大家不妨看看这篇博客《Post-training 101》,可以很好的入门 LLM 后训练相关知识。从对下一个 token 预测过渡到指令跟随; 监督微调(SFT) 基本原理,包括数据集构建与损失函数设计;