训练提速4.6倍!FP4+BF16双轨并行,NVIDIA×港大×MIT联手重新定义扩散模型训练速度上限(在新窗口打开)
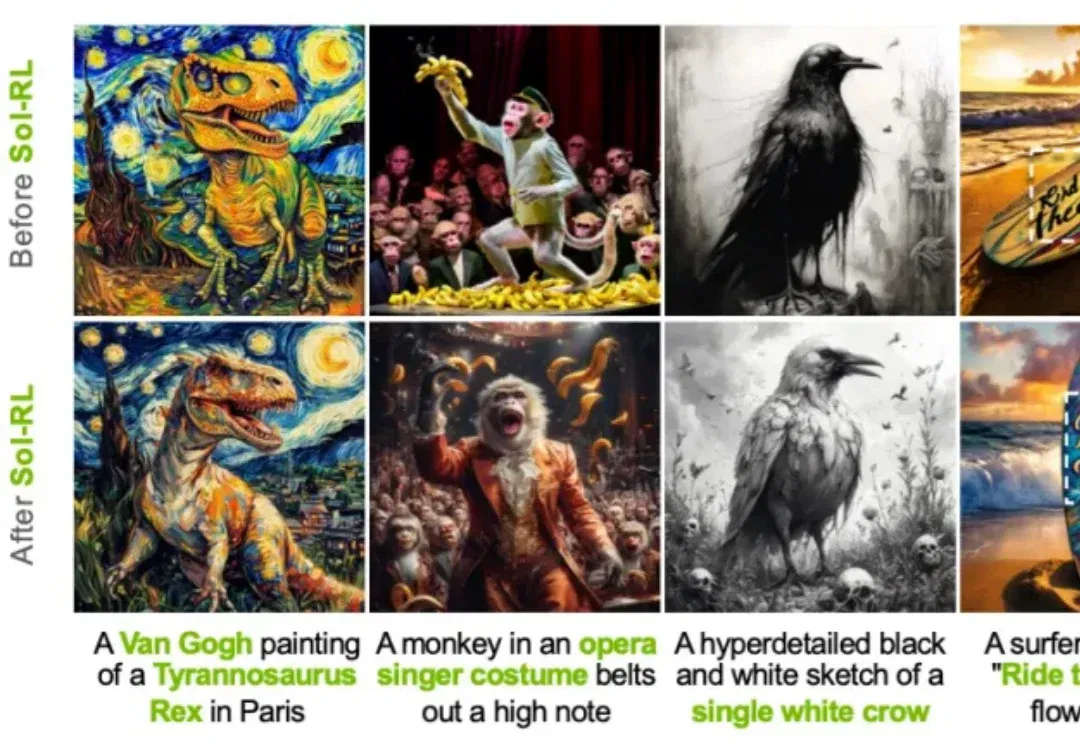
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
共 85 篇
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
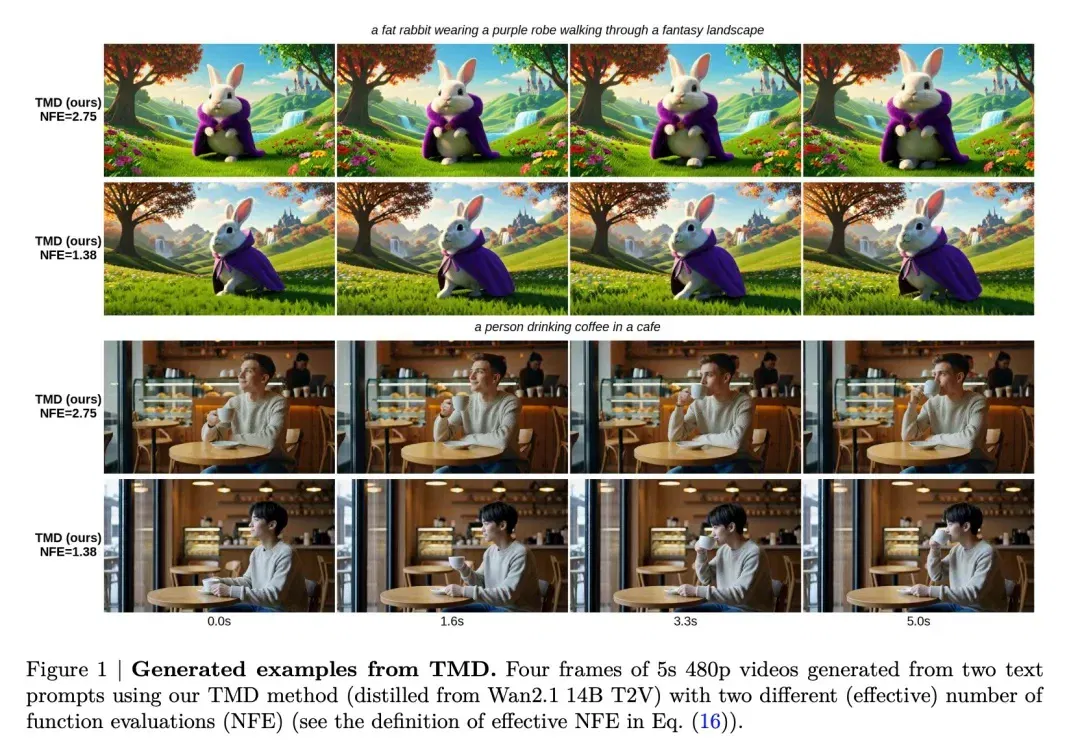
近年来,大规模视频扩散模型在视频生成领域取得了显著进展。然而,采样效率低下仍然是这类模型的核心瓶颈。
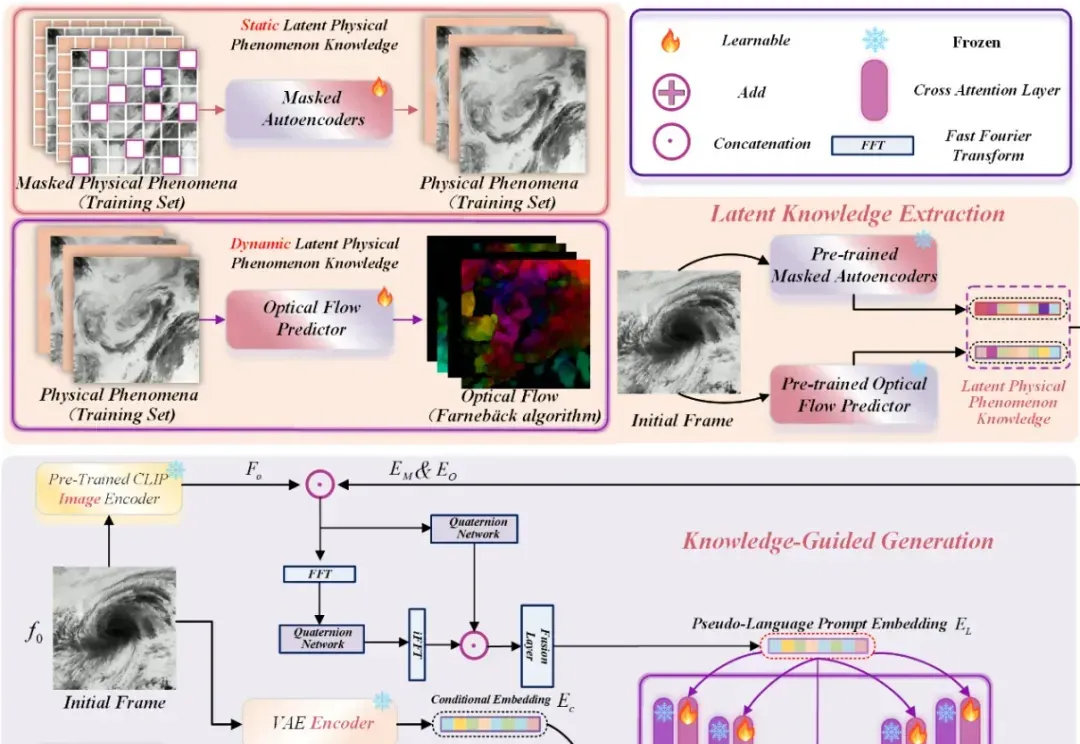
近年来,Stable Diffusion、CogVideoX 等视频生成模型在自然场景中表现惊艳,但面对科学现象 —— 如流体模拟或气象过程 —— 却常常 “乱画”:如下视频所示,生成的流体很容易产生违背物理直觉的现象,比如气旋逆向旋转或整体平移等等。
近年来,基于扩散模型的图像生成技术发展迅猛,催生了Stable Diffusion、Midjourney等一系列强大的文生图应用。然而,当前主流的训练范式普遍依赖一个核心组件——变分自编码器(VAE),这也带来了长久以来困扰研究者们的几个问题:
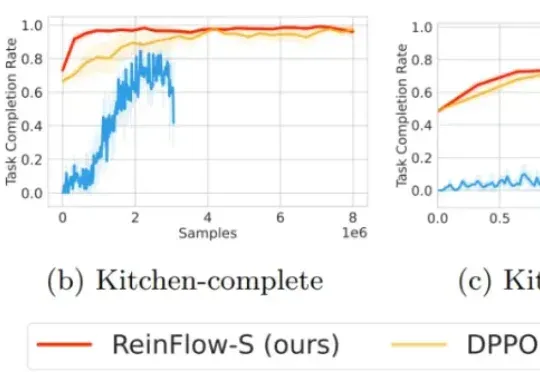
今年,流匹配无疑是机器人学习领域的大热门:作为扩散模型的一种优雅的变体,流匹配凭借简单、好用的特点,成为了机器人底层操作策略的主流手段,并被广泛应用于先进的 VLA 模型之中 —— 无论是 Physical Intelligence 的 ,LeRobot 的 SmolVLA, 英伟达的 GR00T 和近期清华大学发布的 RDT2。
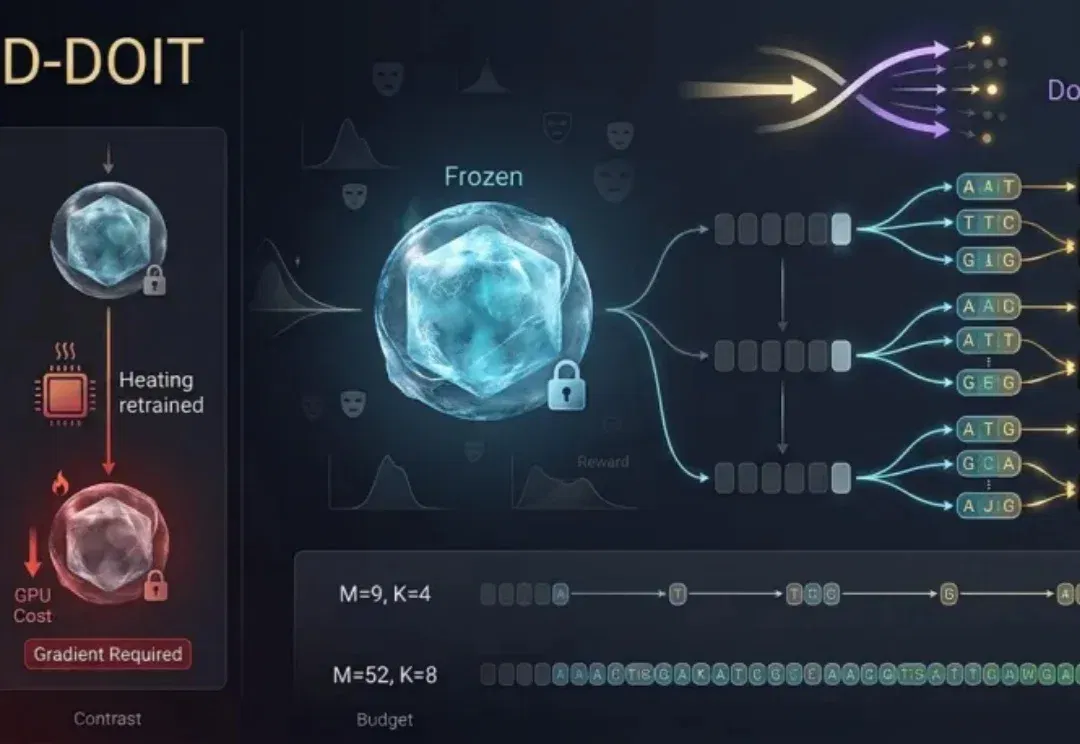
方法以离散Doob变换为理论目标,通过有限候选和奖励查询近似引导;在预测性基准中报告增益,仍需湿实验及推理成本权衡。
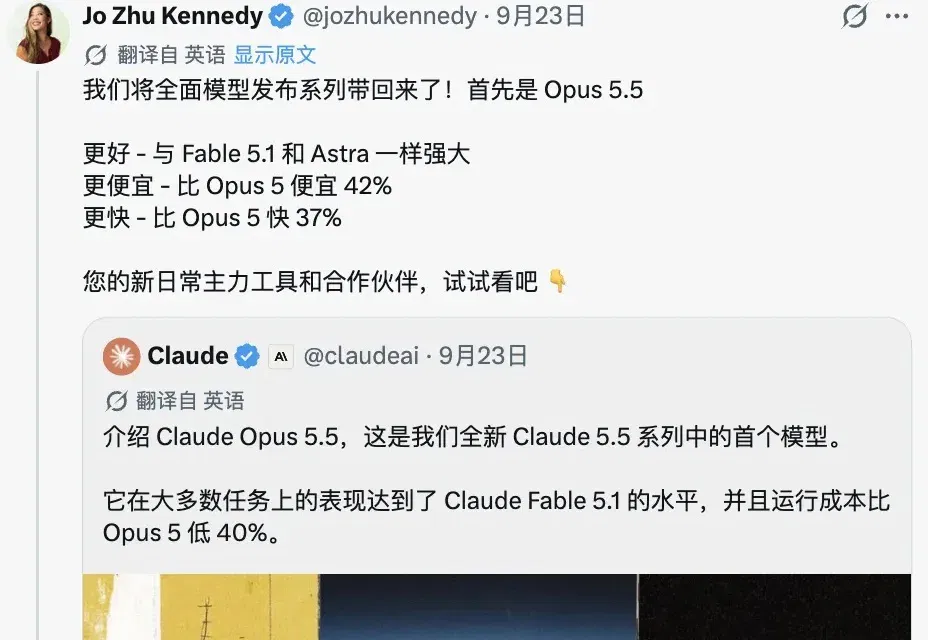
蹬吧,就可劲儿蹬吧! 昨儿Opus 5.5前脚突袭上线,后脚网友就拿它开始疯狂整活儿了?? 一种神秘的、可编辑的、花样百出的、各种玩梗的、拉GPT出来对打的纯代码生成视频直接《刷屏》—— 这边,有网友用Opus 5.5纯代码搓了个78秒的高噪点磨砂风动画,而且45分钟就直出成片。 老哥自己都绷不住了,直言CRUD是真要被按在地上摩擦了啊!!!(笑) 下面这位大神网友,甚至直接用Opus 5.5搓起了AI课件。 然后…就这么把扩散模型的U-Net骨架搭出来了?? (终于理解了父母嘴里的那句:你们真是赶上好时候了。。。) 当然,3D建模也不在话下的好吧! 下面这个网友以前对AI生成3D这件事挺不屑
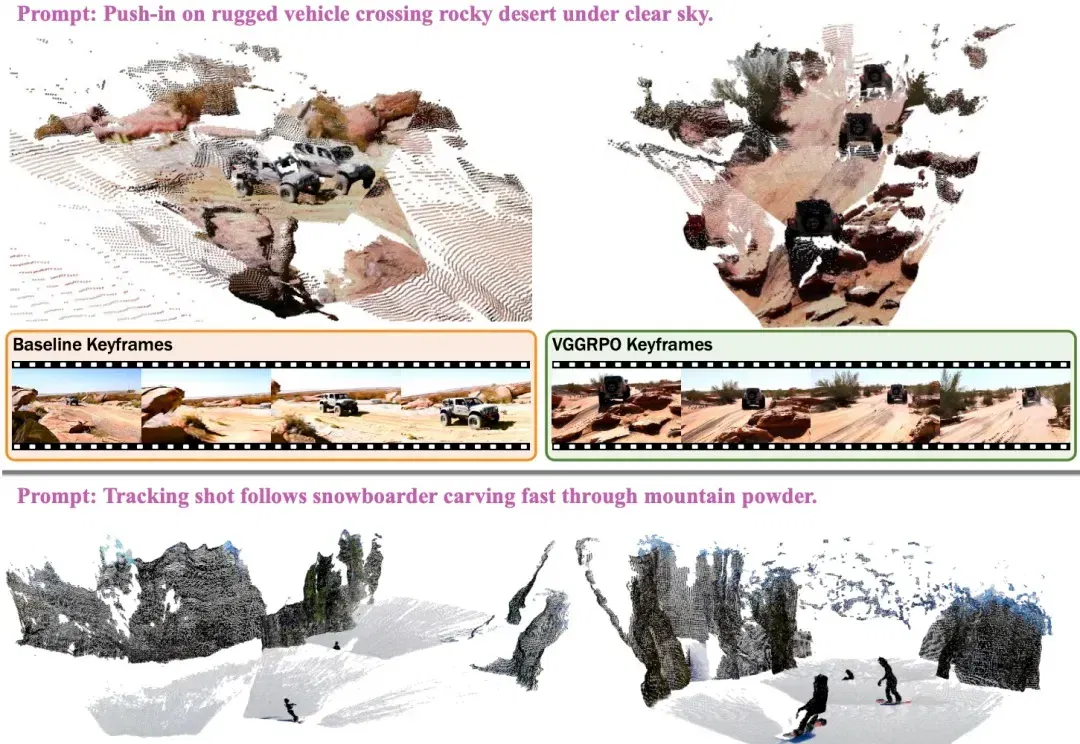
大规模视频扩散模型,画面越来越真,却总在“物理定律”上栽跟头。
还记得「苦涩的教训」(The Bitter Lesson)吗?
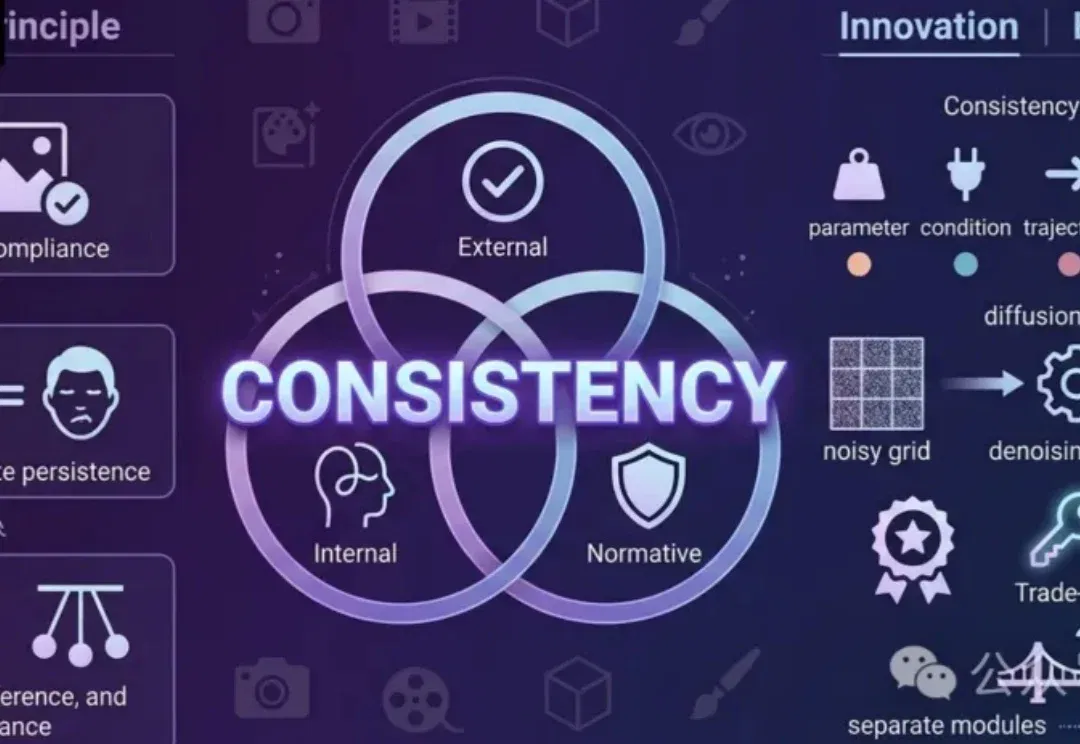
扩散模型已经越来越会「画」,却还远没有学会「守住要求」。决定系统是否可靠的,已不再只是画质,而是生成结果能否持续遵守条件、维持状态,并符合人类与现实世界的基本标准。